「In the LOOP」栏目是 Research AI+社区推出,面向Frontier 领域青年研究者的专访栏目,带领大家亲临 100 位 Researcher 的思想现场。欢迎优秀的小伙伴后台自荐或者互相推荐~
Keep everyone In the LOOP!
本期专访嘉宾:穆尧
穆尧,上海交通大学长聘教轨助理教授,入选国家级青年人才计划,上海市海外高层次青年人才,2026年度云帆奖明日之星得主,智源青年学者, EAI-100 2025学术新锐。博士毕业于香港大学计算机系,访学于苏黎世联邦理工学院、新加坡国立大学等。穆尧博士长期从事具身智能的基础研究,深耕多模态具身认知、具身世界模型和具身自主进化系统等方向,担任了NeurIPS、ICLR、CORL等国际机器学习顶级会议的领域主席和TMLR等国际期刊的编委,中国计算机学会智能机器人专委会执委,中国图形图像学会三维视觉专委会专委,Valse执行领域主席,在IJRR、RSS、NeurIPS、ICML、CVPR等计算机领域国际顶级期刊和会议发表论文60余篇,谷歌学术引用超5000余次。曾荣获2026年ICRA最优论文奖提名、2026年ICRA ViTac 研讨会最优论文奖、2025年IROS最优论文奖提名、2024年ECCV协同具身智能研讨会最优论文奖、2024年中国自动化学会自主机器人研讨会奖学金(全国5人)、2021年IEEE ICCAS2020大会最优学生论文奖、IEEE IV2021最优学生论文提名奖等多项奖励。
导读
如果机器人叠衣服时,衣角突然从夹爪里滑了出来,它接下来该怎么办?
对人来说,这可能只是一个下意识的补救动作:重新抓住,再继续。但对机器人来说,这种“不按剧本发生”的瞬间,往往才是真正困难的部分。
今天具身智能的大量数据,仍然来自人类示范、遥操作和人工采集。它们告诉机器人,人是怎么把一件事情做对的。但如果抓偏了、物体滑落了,或者执行到一半,现实世界已经偏离了训练数据里的“标准答案”呢?
穆尧关心的,是机器人能不能开始积累属于自己的 experience:不只是失败和纠错,而是它真正进入环境之后探索过哪些状态、做过哪些尝试、什么有效、什么无效,以及偏离之后如何把任务继续做下去。
在他看来,未来真正需要被 scale up 的,不能永远只是人类提供的 demonstration,还应该包括机器人自身与物理世界交互产生的经验。
这也是他现在反复谈到的一个概念:具身 RSI(Recursive Self-Improvement,递归自我改进)。
它的关键在于:机器人从上一轮探索中获得新的能力之后,就能进入过去到不了的状态、完成过去完成不了的任务,从而产生下一轮新的经验。
前一轮能力的提升,会改变下一轮它能够探索什么、又能够从中学到什么。
穆尧对这件事的兴趣,可以一直追溯到学生时代。
他的专业背景来自机械与控制,AI 启蒙也不是计算机视觉,而是 David Silver 的强化学习课程,以及 AlphaGo、AlphaZero。真正吸引他的,是 AlphaGo 展示出的另一种可能:一个智能系统不只是学习人类留下的棋谱,还可以通过自主探索产生自己的经验,最终走到人类已有经验之外。
硕士阶段,穆尧研究自动驾驶;2021 年进入博士阶段后,他把研究对象转向机器人。相比行动边界相对明确的汽车,不同形态的机器人能够进入更多环境、操作更多物体,也拥有更为开放的行动空间。
于是,一个问题逐渐变得清晰:
AlphaGo 已经证明,自主产生的 experience 可以孕育出超越人类棋谱的智能;同样的事情,能不能发生在物理世界?
真正的难点也正在这里。
AlphaGo 可以在虚拟棋盘上同时展开海量对局;机器人面对的却是真实的桌子、衣服、夹爪、摩擦力和重力。你很难摆上一万台机器人,让它们同时、不眠不休地试错。
过去几年,穆尧围绕机器人数据、仿真、具身模型、Agent 和强化学习推进的一系列研究,也逐渐汇聚到同一个问题上:
怎样让机器人开始生产自己的经验,又怎样把这些 experience 真正 scale up?
这也是他创立 SeeAct AI 想继续推进的事情。
而就在这条路线逐渐拼起来的时候,foundation model 又突然向前迈了一步。
GPT-6 Astra 等新一代通用模型开始表现出更强的空间理解,以及对操作关键点、末端执行器轨迹等物理信息的理解能力。对穆尧来说,这没有让过去的工作变得多余,反而让一些原本需要长期投入的事情突然开始加速。
但它也把另一个问题推到了台前:
如果 foundation model 继续快速变强,它最终会吃掉多少机器人系统原本需要自己解决的问题?
一边是越来越强的基础模型,一边是仍然难以规模化获得的物理世界 experience。两者之间的边界会落在哪里,也构成了我们这次和穆尧对谈最核心的两条线。
访谈最后,我们问他:如果完全不考虑技术、产品和资金限制,SeeAct 最终想实现什么?
穆尧想起了小时候最喜欢的一部电视剧——《魔幻手机》。
剧中的“傻妞”既存在于数字世界,也能够以人的形态进入现实:理解信息,同时真正作用于物理环境。2008 年的电视剧把她的降临放在了 2060 年。
穆尧说,他现在想先把目标放在 2030 年:
“在物理 AI 世界里,做一个非常出色的‘傻妞’。”
Highlight
SeeAct为什么要从物理世界向数字世界“打过去”
Xinran: 很多人过去认识的是穆尧老师。最近你创立了SeeAct,开始以创业者的身份出现在大家面前。能否用一句话介绍SeeAct究竟想做什么?
穆尧:
我们现在在做的事情,一句话概括,就是希望打造一个能够贯通数字世界和物理世界的智能体。
数字世界里的智能体已经展现出了非常好的效果,物理世界的端到端模型也在快速进步。我们觉得,现在是一个很好的历史机遇:有可能诞生一个真正横跨数字世界和物理世界的智能体。
SeeAct希望做的,就是构建一套连接大模型与物理世界的完整自进化系统,一套具身RSI。
Liz: 数字世界里的Agent已经很强了,为什么不能直接给它接上一具机器人的身体?从数字智能进入物理世界,中间真正缺少的是什么?
穆尧:
我觉得,首先要看你让机器人做的是什么任务。拿榜单来说,如果一个榜单主要靠复杂的视觉语言推理,而底层执行只是简单的 pick-and-place,那么 GPT-6 加上 π0.5 这样的组合,就可以有很好的表现。但任务越强调dexterity,也就是灵巧操作,这套组合的瓶颈就会越明显。
对于非常灵巧的操作,人并不是靠大脑把每个关节的动作都想清楚。大脑可以理解一项任务大概应该怎样完成,给出方向、动作趋势和关键姿态;但具体执行的时候,需要实时的闭环反馈。我们不可能每一帧都去调用一次大模型,让它推理半天,再输出一个坐标值。
这里我还想澄清一下“大脑”和“小脑”的叫法。有些人把底层运控的 policy 叫作小脑,再把一个可能只有 3B 左右的 VLA 叫作大脑。但在我的理解里,很多需要实时闭环输出动作的 VLA、World Action Model,本质上仍然是小脑模型。
因为这里有一个推理频率的区别。上层大模型是慢系统;如果一个模型要根据视觉反馈端到端地输出动作,而且我们期待它的动作输出频率在 50 赫兹以上,那么在我的概念里,它应该被定义为小脑。
我这里说的都是 manipulation,也就是具身操作场景。小脑主要解决灵巧操作,上层大脑负责理解、推理和调度。
所以,数字世界和物理世界之间缺少的,不只是把模型接到机器人的一个接口,而是一套让上层推理和底层灵巧策略能够充分衔接、共同进化的系统。
Liz: 现在也有其他团队在尝试连接基础模型与物理世界。SeeAct的路线有什么不同?
穆尧:
我觉得现在做这件事的公司大致可以分成两类。
一类是从数字世界向物理世界打。数字世界中的模型经过充分训练,已经有很强的语言、视觉和推理能力。这条路线首先解决的是grounding,以及二维、三维空间中的关键位置、关键方向和关键动作趋势。
我们走的是另一条路线:从物理世界这一端往数字世界打。
这要求我们真正具备底层dexterous policy的研发能力,而且必须能把它在具体任务中的成功率真正做到很高。底层策略不断增强之后,它会给上层更好的反馈,也允许推理层和policy层在更复杂、更多样的任务中继续探索。反过来,这些探索又会提高上层模型对空间、任务编排和物理过程的理解。
换句话说,一条路线是从数字世界向物理世界延伸,我们则希望从物理世界出发,连接数字世界。
贯通这两个世界,我们核心bet的点是经验数据的scale up。只有在大规模并行探索的情况下,才有可能迸发出充分的智能,AlphaGo已经很好地验证了这一点。
Liz: 我在线下的闭门会上听到过你的一个观点,基础模型公司会从model往harness走,创业公司会从harness往模型走,现在两边都在向中间推进。那如果下一代基础模型继续快速增强,SeeAct今天做的哪些事情可能被基础模型吸收?又有哪些边界是你认为不会变化的?
穆尧:
我觉得两边的能力都会不断增强。上层基础模型会越来越强,底层端到端policy也会越来越强,因此中间的具体边界一定会不断移动。
比如grounding、任务理解、动作趋势和关键pose,未来都可能越来越多地被上层模型吸收。大模型能够处理多复杂的任务、输出多精细的关键pose,这些能力可能以周为单位更新。
从我目前看到的进展来说,我觉得海外在上层推理大模型和底层策略模型上,可能又和国内出现了一些代差。之前大家都在做 VLA、World Action Model 的时候,国内在数据采集上有很好的优势,曾经很快追平了一段距离。但现在,我觉得这两层又出现了一些新的差距。
底层策略方面,我觉得 Physical Intelligence 的很多思路和我们比较一致,也很强调经验数据的利用。Generalist AI、Skild AI 在陌生环境中的 in-context、zero-shot 能力,也给自进化提供了一个很好的基础。上层的通用大模型同样在快速进步。
我自己的一个判断是,到 2027 年春节前后,海外可能迎来上下层能力交融的一个爆发点,甚至可能更早。这是我个人对 timing 的预测。
但这些变化不会改变一个宏观判断:上层大模型是慢系统,底层端到端policy是快系统。具体边界会不断移动,但“慢推理”和“快执行”之间的分级不会消失。
所以,我们押注的不是某一个今天恰好属于下层的具体功能,而是底层灵巧策略的持续增强,以及物理交互产生的经验如何反过来推动整个系统进化。
从自主经验到具身RSI:机器人如何从自己的行动中学习
Liz: 你刚才说,SeeAct这条路线核心bet的是经验数据的scale up。它和行业今天大量采集的数据究竟有什么不同?你以前提到过“数据为王”,现在发生了什么变化吗?
穆尧:
首先,“数据为王”并没有错,但我们要进一步讨论:究竟什么样的数据,才能真正把物理智能推到可用的阶段?
现在大家的模型可能都是DiT或者Transformer结构。相对于模型结构上的一些小改动,优质数据带来的增益往往更大,这是我以前表达“数据为王”时的核心观点。
但是现在行业里被不断scale up的数据,不管是人类直接操作的数据、UMI数据,还是遥操作数据,本质上大多是由人产生的经验数据。坦白讲,这些都是演示数据,是人和物体交互之后,再交给机器人去模仿。
但我理解的具身智能,是智能体从自身和物理世界的交互中习得知识。也就是说,我们真正需要补充的,是机器人自主探索和自主推理所产生的经验数据。
这和围棋很像,如果你把人类所有棋谱都喂给模型,它可以模仿人类高手,但它打不败柯洁。要产生真正强大的智能,你需要把自主推理、自主探索产生的经验scale up。
为什么这种经验对机器人尤其重要?因为只要我们对泛化性有要求,机器人在执行过程中就不可能永远不出现偏差。除非它做的只是重复定位精度达到亚毫米级的机械定点任务,而这类任务早已商业化。只要环境和操作对象会变化,运行中就一定会出现偏差。
人也一样。考试时需要草稿纸,工人在产线上也不可能一次差错都不出。但我们可以在还没有铸成大错的时候及时调回来:东西摆歪了一点,就把它纠正回来;动作偏了一点,就重新调整路径。
演示数据主要告诉模型“正确的动作是什么”,却不能充分覆盖偏离之后的状态空间。机器人要获得自主纠错能力,数据就必须覆盖更充分的反事实空间。因此,我们现在真正需要scale up的,不只是demonstration,而是experience。
Liz: 失败和纠错在你所说的experience里处在什么位置?为什么它们尤其重要?
穆尧:
失败和纠错不是experience的全部,但它们是demonstration data最难覆盖的部分。机器人尤其需要看到,在各种意外情况下应该怎么恢复。
比如搬一个箱子,搬着搬着箱子发生了倾斜,机器人应该怎么调整重心;做精细操作的时候稍微偏离了目标,是直接继续向前,还是先往后退,再调整方向重新执行。这些都不是一条标准演示轨迹能够充分提供的。
我们希望模型见过足够广泛的场景、任务和偏差状态。在预训练阶段,它就能够获得一种自主纠错的“基因”。这样到具体场景做后训练时,它才能比较高效地适应。
如果预训练阶段完全没有见过这些经验,所有纠错能力都要等到后训练阶段再补。即使最后在单一场景里能训练到90分,它所需要的时间和成本也会非常高,这会直接增加商业落地的难度。
Liz:真机探索很难把并行度做高。机器人的经验应该怎样被 scale up?
穆尧:
Scale up经验非常重要的一点,是把探索的并行度开得足够高。
以人形机器人的策略训练为例。如果并行度很低,机器人第一次发力没有站起来,后面采到的可能都是它躺在地上挣扎的数据。这类经验的质量就很低。
但如果能够高度并行地探索,采样足够多次,其中只要有少数尝试找到了更好的发力方式——哪怕还没完全站起来,只是先坐起来,或者让腿和地面形成稳定的支撑——这些经验就更有价值。高并行度会让探索更容易找到智能提升的起点。
可是纯真机方案很难做到这一点。我们不可能同时部署一万台机器人,任由它们进行大规模试错。所以我们坚持的路线,是用World Engine驱动大规模、并行化的经验采集。
这里说的仿真,不一定只指传统physical engine。由world model、端到端模型驱动的synthetic environment,只要能够支持交互和未来推演,都在这个范畴内。
真实世界的数据质量最高,但并行度很难做大;World Engine可以提供非常高的并行度。因此,我们更希望把两者结合起来:在虚拟环境中做大规模rollout和在线探索,在真实世界中由Agent辅助机器人更高效地探索,再把真机产生的数据用于离线强化学习和系统校准。
Liz: 围绕“经验生产”这件事,SeeAct正在构建一套怎样的系统?
穆尧:
整个系统大体可以分成三层。
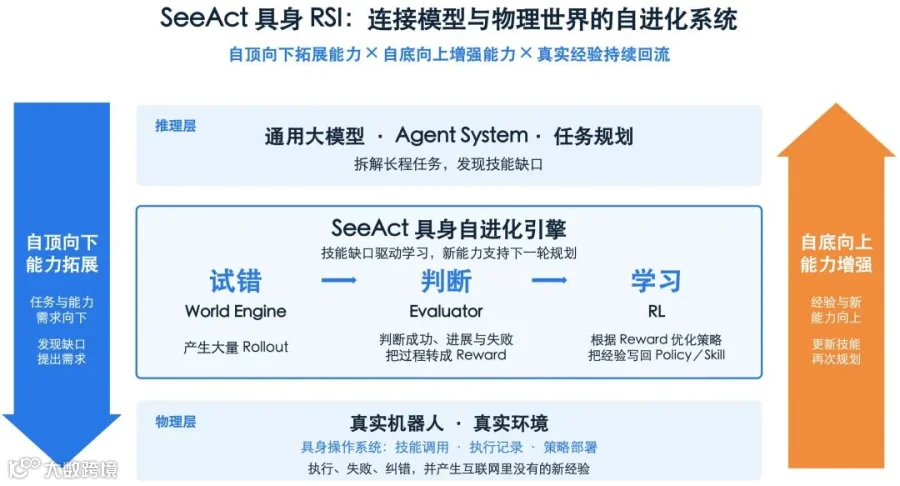
第一层是推理层。它由通用大模型和相应的harness组成,负责长程任务拆解、复杂视觉语言理解和任务理解。更重要的是,它会通过与环境的交互,发现当前的技能缺口:哪些技能还不具备,哪些技能的成功率比较低,哪些能力需要进一步强化。
发现技能缺口之后,就进入第二层,也就是自进化引擎。这一层主要包含三个部分。
第一个部分是World Engine。它负责产生大量rollout,让机器人进行大规模自主试错。
第二个部分是Evaluator。它评判交互数据取得了多少进展、当前行为距离任务目标还有多大差距,并完成相应的奖励分配。比如,它需要判断当前interaction已经完成了目标的百分之多少。
第三个部分,是把多个场景、多个任务,乃至整个机器人群体产生的数据汇聚起来,进行多任务、多场景的联合强化学习。我们希望充分利用自主探索得到的数据和奖励信号,提升策略基座在不同场景中的成功率与泛化能力。
这是一种自底向上的能力增强:新技能不断被习得,旧技能的成功率不断提升;随后,新技能以及它的能力边界会被注册给上层harness。上层再把这些由端到端policy构成的技能当作API,进行更复杂的任务调度和组合。
第三层是真实的物理执行层。自进化引擎中的World Engine既包括端到端World Model,也包括高精度Physics Engine。系统会根据两者不同的能力边界,为不同任务选择合适的交互环境。World Engine负责大规模并行探索,真实机器人则提供最高质量的现实反馈,两端产生的结果都会重新送回系统。
如果把这三层连起来,整个过程就是:执行任务、发现技能缺口、在World Engine中高并行试错、由Evaluator分配奖励、通过强化学习提升策略,再把新的技能返回给上层Agent。Agent拥有更多技能之后,又能够挑战更复杂的任务,并在新的失败中发现下一轮能力缺口。
我们最终希望形成的是这样一个可以持续自我增强的闭环。整个系统贯通上层推理层、中间的自进化引擎和真实机器人的物理执行层,我们把它称为一套具身自进化的RSI系统。
新模型加速的,是一条从AlphaGo开始的长期路线
Liz: 我们记得 GPT-6 Astra 发布后不久,你正式宣布创立 SeeAct,时间应该是 9 月 10 号。好像这两者之间存在一些联系,是这样子的吗?
穆尧:
其实我筹划创业这件事已经很久了。我过去做的很多research,其实都在为这件事准备,包括World Engine、物理引擎、RoboTwin 1.0、2.0、3.0,以及Agent方向的RoboClaw等工作。本质上,它们都在为具身自进化系统服务。我们很早就希望搭建这样一套系统,并不是看到某一个新模型出来之后,才突然改变方向。
但是,新一代模型的出现确实让我们对这件事更加兴奋,也给创业公司带来了很好的机会。
第一,它让高精度3D资产的自动构建出现了一条更好的管线。以前,我们拓展物理环境时会遇到大量工程问题,高精度资产非常消耗人力。模型能力提升之后,资产生成、渲染和物理solver开发都有机会变得更自动化。这也在一定程度上降低了过去以高精度仿真资产作为壁垒的门槛,对新公司来说反而是一个很大的机会。
第二,大模型开始展现出两类让我很惊艳的能力。比如在叠衣服这样的任务中,它已经可以识别和输出一部分关键点;同时,它开始能够理解末端执行器的位姿轨迹,并表现出某种in-context following能力。
过去大家谈大语言模型的涌现,主要指自然语言处理中的in-context能力。现在,我们在具身领域也开始清晰地观察到类似现象。
这意味着上层和下层的连接范式可能被重构。以前,大模型与策略模型主要在task level交互;现在,它们可以在动作趋势、关键pose甚至一部分轨迹层面形成更dense的衔接。更灵巧、更实时的action仍然要由端到端policy完成,但两层之间不再只有一条很窄的接口。
这也会对传统以VLA为主的公司形成冲击。过去很多VLA公司投入很大精力做视觉语言到动作的对齐。但从第一性原理看,动作本身包含的信息量相对有限,直接把视觉语言中的推理能力完整对齐到动作并不容易。大量数据可以带来不错的视觉泛化,但要获得通用大模型那样的推理能力,仍然非常困难。
所以,新模型没有改变我们要做的事情,却明显加快了技术成熟的速度,也给新成立的公司提供了重新定义上下层连接方式的窗口。
Liz:你前面提到,SeeAct希望通过大规模并行探索积累experience。这让我想到数字世界里一些 Frontier Labs 在做的 AI Researcher:也是通过大规模并行实验,不断积累哪些 idea work、哪些 idea 不 work。两边最后走到这么相似的范式,看起来有点偶然,但我相信这种偶然背后往往有一些必然。你最早是什么时候开始意识到,机器人自己产生的经验会很重要,应该让它从自己的尝试和失败中学习?有没有哪段研究经历促成了这个想法?
穆尧:
其实这个想法出现得非常早。我过去很多研究,本质上一直在为这件事做铺垫。
真正吸引我去做强化学习、人工智能和端到端策略的,是AlphaGo的成功。我第一次非常直接地看到,原来真的可以产生一种超越人类的智能。
我接触AI的时间比较早,最开始还在用TensorFlow,后来才转向PyTorch。很多做视觉的老师,AI启蒙可能来自李飞飞老师的CS231N,从检测、分割这些网络开始学。我的专业背景偏机械和控制,所以我的AI启蒙是David Silver的强化学习课程,以及其中介绍的AlphaGo、AlphaZero。
在刚刚开始构思自己未来想做什么的时候,我就希望做成一件在general意义上类似AlphaGo的事情。
硕士阶段,我研究的对象是自动驾驶和汽车。但后来我觉得,车的任务边界相对明确:四个轮子在道路上行驶,要沿着道路、遵守交通规则,不能撞到人和车。这个问题当然非常重要,但对我来说,它的行动空间还是有一定局限。
2021年开始读博士、进入具身智能领域以后,我发现机器人特别有意思:机器人的形态非常多,可以做的任务也非常多,而且在一些工作上,它天然可能比人更强。我觉得,这是一个可能产生“物理世界中的AlphaGo”的领域。
当然,2021年的具身智能还非常空白。要数据集没有数据集,要benchmark没有benchmark,很多东西都要自己造。我们就从数据集开始,后来做具身基础模型、具身思维链、视觉反馈下的代码生成,再到拓展上层Agent可以调用的工具,最后走到面向多场景、多任务的端到端策略和联合强化学习。
所以,从今天回看,这并不是看到某个新模型发布之后才出现的想法。我的很多研究一直沿着同一个方向,只是人在不断成长,研究对象从汽车变成了双臂机器人,外部的技术条件也在变化。双臂机器人恰好与我非常契合。现在创业,是希望把过去这些分散的部分真正组合成一套完整系统。
我觉得一个人做研究也好、创业也好,最重要的是做一件让自己真正感到兴奋的事情。你坐下来读一篇相关论文,或者和团队开一场技术讨论会,不会觉得疲惫,反而会感到非常 energetic。我觉得这样的事业,才是一件值得长期投身的事情。
Liz: 现在回看,你过去的很多研究似乎很自然地组成了一个系统。但在探索过程中,有没有遇到过让你怀疑或者调整路线的挑战?
穆尧:
我们一直在探索的核心问题,就是怎么 scale up 经验数据。总体上,我们并没有改变技术路线,但在推进过程中确实遇到过非常大的挑战。
我以前在很多场合说过,我是一个非常坚定的仿真派。当然,仿真并不一定只指 physical engine,由 world model 和端到端模型驱动的 synthetic data,以及对未来的推演,也属于我说的仿真。
但是在2025年以及2026年上半年,很多公司都在推动真机数采,行业里质疑仿真的声音非常多。这些质疑也不是没有道理。
首先,早期的物理仿真引擎很多来自游戏引擎,对刚体支持得比较好,但柔性体很难做好。比如仿真一件衣服,效果可能像橡皮泥一样。这样的数据很难支持真实的灵巧操作。
其次,sim和real之间确实存在差距。仿真可以批量产生pick-and-place数据,但放到真机上,效率和成功率未必足够高。
所以我们一直在想,仿真应该怎么破局。
第一步是解决视觉真实性。生成式模型快速发展以后,图生3D可以帮助我们构建更精细的前景资产,3D Gaussian等技术可以提升背景真实性和实时渲染效果。相对于NeRF时代,视觉上的sim-to-real gap已经有机会被明显缩小,这也是我们RoboTwin系列工作希望解决的一部分问题。
我们把视觉做得比较好之后,外界的质疑又转到了物理真实性上。我的观点是,仿真不一定要把每个参数都复制得完全一样。具体是0.2牛还是0.3牛,并不是最重要的,因为人与人的手掌大小、粗糙程度和摩擦力也不一样。智能的习得应该是反馈式的,而不是把某一个固定参数背下来。
从这个意义上说,我觉得仿真和现实世界更像两个平行宇宙。物理参数不需要逐项完全一致,但只要变化趋势是对的,智能体就应该像人进入一个略有差异的世界一样,依靠反馈很快适应,不至于连一个瓶盖都拧不开。
仿真真正需要保证的,是物理趋势正确,并且能够覆盖更多类型的物体。因此,我们投入了很多精力支持流体、柔性体以及各种物理solver。例如厚重衣物被夹爪挤压时可能出现穿模,我们也在研发相应的无穿模仿真方式。
我们还与摩尔线程等产业伙伴合作,希望构建一套可以跨物理引擎、跨渲染引擎,同时支持不同GPU和国产算力的完整仿真系统。相关成果也已经陆续投稿和发布。
但有一点是我之前没想到的:GPT-6 Astra 的发布,会给仿真带来这么大的升级——对高精度资产构建和物理环境开发带来了很大帮助。我原来已经做好了用两年左右的时间坐冷板凳、慢慢打磨,但模型能力提升之后,高精度资产构建、渲染,以及物理solver的调用、修正和边界条件优化,都开始变得更加自动化,效果也很好。这件事极大地加速了我们正在做的事情。
所以回看这段经历,我们确实投入了很大力气应对挑战,但我在这条路线本身没有后退过。我自己一直很喜欢一句话:“坚刚不可夺其志,万念不可乱其心。”
群体智能:让经验在不同机器人之间流动
Xinran:我自己是做人机交互出身,一直有一个直觉:个体智能的进化,可能很难比得上群体通过社会化交互所产生的进化。群体之间可以并行地交流、学习和积累经验,因此无论规模还是效率,都可能更高。
我们之前也和一些研究 Agent 群体自进化的老师交流过。想从 Physical AI 的角度继续请教老师:随着基础模型越来越能够进入和理解物理世界,你怎么看群体物理智能这件事的长期发展?SeeAct 目前在群体智能,或者说群体物理智能方面,已经做了哪些工作?未来又准备往哪些方向探索?
穆尧:
首先可以解释一下,为什么我们会选择面向一个机器人群体,而不是单一机器人来做这件事。
这里其实和你刚才从人机交互角度提到的观点异曲同工:仅仅依靠单一本体进行探索,很难产生足够丰富的智能。这和我们前面说的“提高并行度”是一脉相承的。我们希望让大量不同的机器人同时进入环境、执行任务、探索,并持续积累经验数据。
首先,单一的机器人本体很难支撑真正通用的智能。不同场景对末端执行器的需求完全不一样。抓取细小图钉时,精细的小爪子可能比粗大的爪子有效得多;但需要较大负载时,小爪子又很难完成任务。即使是类人的灵巧手,手指粗细、长度和尺寸不同,也会影响它适合完成什么工作。
所以我们需要一个比较通用的基模,能够支撑不同类型的末端执行器,让它们在更丰富的任务和场景中积累自主决策经验。硬件上的变化有时比单纯升级算法更有效。模型在预训练阶段见过的本体、任务和错误越丰富,后续适应新场景时的代价就越低。
第二,有些任务天然需要多个机器人协同完成。例如两个机器人一起把桌布扽平,或者协作铺酒店的床单、被罩。这样的任务连人类遥操作都可能比较困难,更适合通过奖励驱动的大规模探索来获得协作经验。
第三,我们还要把视角从policy model提高到推理层。自主纠错的起点,是先意识到自己发生了错误,然后给出一个纠正错误的子任务:你现在向右偏了,需要先后退,再向左调整,然后重新靠近目标。
这种对错误的检测、失败原因的归因,以及对后续策略的文字指引、动作趋势指引和关键pose指引,具有很强的跨本体能力。人类和机器人在身体结构上完全不同,但人仍然可以成为机器人的监工,指出它在哪里出错、接下来应该如何调整。
因此,群体自进化既包括底层策略在多本体、多任务中的联合学习,也包括上层推理经验在不同机器人之间的迁移。最终仍然是一种自底向上的增强:底层policy变强,上层对物理世界的理解和调度能力也随之增强。
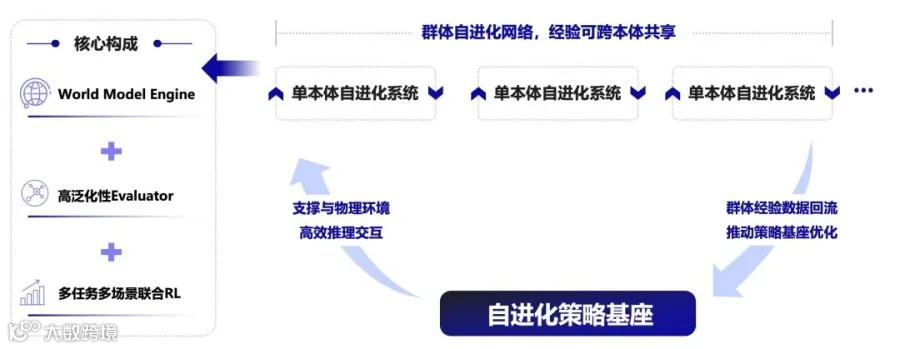
如何验证并scale up一套具身RSI系统
Liz: 怎样验证这条技术路线是有效的,而不是给系统增加了更多复杂模块?
穆尧:
我觉得可以从两个方面验证。
第一个方面是策略基础模型。为什么Physical Intelligence的π0、π0.5发布一段时间以后,仍然有很多团队使用?因为大家在实测中发现,它们有比较好的few-shot能力。比如叠衣服,采集几千条数据,再对π0.5做fine-tuning,可能就可以得到一个不错的结果。这说明它具备比较好的视觉和空间泛化性。
而我们希望通过scale up经验数据,让模型获得更强的自主纠错能力。未来用户拿到我们的模型,只需要提供少量数据,甚至通过in-context方式给出非常少的演示。这些演示里可能完全没有纠错和恢复数据,但模型自己执行时一旦出现偏差,仍然能够表现出很强的恢复能力。
也就是说,验证重点不只是“它能不能完成一次任务”,而是“它偏离之后能不能自己回来”。这是我们希望策略模型对外发布时能够展现的核心效果。
第二个方面,是上层推理和底层端到端模型的衔接。
假设一个长程任务包含十个以上的子任务,每个skill即使都有接近99%的成功率,组合起来之后,整体成功率仍然会明显下降。单独把每一个policy继续训练到更高成功率当然重要,但还不够。
我们希望上层推理层能够检测单一策略的失败,重新调用、调整或者切换技能,让系统具备容错和恢复能力。最终,即使中间某一个子任务失败,完整长程任务仍然可以在智能调度下继续执行。我们的目标,是通过这种衔接,让长程任务的整体成功率逼近99%。
还有一个我认为非常重要的milestone:机器人能不能在一个真实场景中持续24小时自主运行,并持续回流它自己产生的推理和交互数据。
具身智能相比自动驾驶的一大挑战,是至今仍缺少成熟的自动化数据回流管线。很多数据只能通过付费外采、由人类操作产生。如果一个系统能在真实场景里持续自主工作,同时把经验稳定地回流到训练系统中,我觉得这本身就是非常大的进展。
Liz: SeeAct目前已经实践到哪一步?哪些问题已经解决,哪些还在继续推进?
穆尧:
目前,我们已经有一套完整系统的基础技术原型,其中包括三个基础模型:world model、reward model和policy model,也包括面向多任务、多场景的联合强化学习方法。
但现在最主要的工作还是scale up:我们要扩大world model和policy model,基于更广泛的数据训练reward model,也要让Agent进入真实机器人的探索循环,辅助真机产生更多有效rollout。
在world model方面,我们会先发布3D原生的小体量版本,到2026年年底和27年初再进一步放大。
策略基础模型受到实时推理的约束,不会无限追求参数量,同时要保持足够高的动作输出频率。
此外,我们也会和合作紧密的本体厂商一起,在实际场景中探索整套自动化系统的初步落地。到2027年4月之前,我们的重点仍然是模型、系统研发以及商业化的初步验证。
商业化方案要从场景里自然生长出来
Xinran: 从科研技术走向真实落地,SeeAct会先进入什么样的场景?你如何看待商业化节奏?
穆尧:
我们的规划比较明确。第一阶段会依托产业投资方能够提供的场景,与本体厂商和场景方一起推进。
因为这不是单纯部署一个软件模型。整套算法还需要结合端侧算力、本体和末端执行器,也要适配当地的网络、供电以及具体工作环境。因此,它需要SeeAct、本体厂商和场景方三方协同打磨。
我们也希望最初合作的场景方足够有耐心。因为面向一个新场景,除了模型能力,还要保证工业节拍,处理大量边界条件,并找到最终可交付的产品形态。
第一阶段比较有利的一点是,我们的产业投资方既能连接一些本体厂商,也有比较好的真实场景,可以支持SeeAct、本体厂商和场景方三方协同完成整套系统的商业化打磨。
但Day One最重要的事情,还是先把技术做得足够强。如果模型能力本身比较弱,就急着谈商业化交付,我觉得是不现实的。理想状态是,对于一个实际场景,我们能够在两三个小时内,让策略达到客户愿意付费的效果。之后,再通过和场景方深入合作,把节拍、稳定性和边界条件逐步打磨出来。
这个过程也是一家初创公司的“自进化”。你需要不断积累面向场景交付的经验。
我不认为从另一个行业引进一个做过交付的人,就能直接把这件事完全cover掉。我们研发的是一套新的系统,产品需要被重新定义,它和机器人本体、场景方之间应该怎样衔接,客户最终为什么买单,都需要在实际合作中快速迭代。
真正成熟的落地经验和商业化方案,一定是从场景里面长出来的,而不是从另一个行业照搬过来的。
真正的拐点,不是更炫的Demo
Liz: 你认为具身智能下一次真正的技术拐点,会以什么方式被普通人感知到?是机器人终于不只会叠衣服了吗?
穆尧:
我觉得真正释放出来的信号,可能不是多么稀奇古怪的能力,而是一些场景真正开始产生实在的落地,不再只是表演性质的落地。
比如叠衣服。这个任务听上去已经很常见,但现在机器人叠得还不够平整,速度不够快,动作还会哆哆嗦嗦。如果它能达到一个月薪两万元的保姆的工作效率:把衣服洗完、晾好、熨平、叠整齐,再放进衣柜,同时完成防潮、除臭和定期通风,我觉得这就太有市场了。
当然,机器人的尺寸还需要优化,尤其是中国家庭空间比较有限。但我不太认同具身智能总要去设计一堆稀奇古怪的demo,比如穿冰糖葫芦、做中药荷包。这些表演性质可能更多。
我很欣赏Dyna Robotics。它做的事情听上去甚至比叠衣服更简单,就是把长方形的毛巾、餐巾叠成场景需要的形状。但它把这件普通的事情做得非常solid,比如在美国鼎泰丰的餐巾折叠场景里推进真实部署,也进入了酒店等场景。
对具身智能来说,真正重要的不是又完成了一个新奇任务,而是把一两件事做实。哪怕只在一个场景里,让机器人持续24小时自主运行,并持续回流它自己产生的推理和交互数据,我觉得都是一个很好的milestone。
从技术发展角度来说,我认为现在恰恰是做具身智能很好的时代。资本市场对这个行业的耐心可能有所下降,但物理AI真正有希望的能力正在开始出现。我的判断是,2027年具身智能的发展速度和落地速度一定会高于2026年。
过去,很多VLA模型只是使用几十万、几百万小时数据训练,loss继续下降,大家就把这称为scaling law。每家公司当然都可以讲自己的故事,但在我的定义里,真正值得称为“涌现”的,是模型获得了in-context能力。
一方面,策略基座开始表现出in-context learning的苗头;另一方面,通用大模型开始能够理解末端执行器的位姿序列,甚至输出一部分末端位置和动作趋势。这是GPT-5及以前的模型很难达到的效果。在我看来,这两类能力才是物理AI开始出现“涌现”的信号。
OpenAI已经非常认真地把具身数据用于训练,也组建了自己的Robotics团队。以它的迭代速度、资源和基础模型能力,我认为进展会非常快。我自己的预测是,2027年二三月份前后,海外可能出现一些新成果,引发新一轮行业爆发。我们也在根据自己的技术理念和体系加速追赶,希望届时能同期发布一些有分量的成果。
有人会问,现在谈具身RSI是否太早。我反而认为,当前正是做具身RSI的好时机。我们已经掌握了扩展演示数据和经验数据的一些方式,应该在基础模型完全成熟之前,先把构建自进化系统的基础工作做好,再大规模推进自进化。等到一家公司直接发布一个完整成熟的系统以后再进入,机会可能已经不存在了。
“2030 年我们想做一个从数字世界到物理世界完全贯通的super intelligence”
Xinran: 如果完全不考虑技术、资金和产品限制,SeeAct最终希望推动一个怎样的世界?
穆尧:
在有无限资源的情况下,我们一直希望做的,是一个从数字世界到物理世界完全贯通的super intelligence。它能够产生一个真正的“超人机器人”。
从科幻层面来说,我小时候很喜欢一部电视剧,叫《魔幻手机》。里面有一个角色叫“傻妞”。她既可以作为手机存在,也可以变成人的形态,还可以和物理世界交互,把现实世界和线上的信息实时打通。这就是一个从数字世界到物理世界完全贯通的 Super Intelligence。这是我小时候最爱看的一部电视剧。
那是2008年的电视剧,它想象的是2060年的智能体。我觉得,我们现在或许可以先target一个2030年的目标:在物理AI的世界里,做出一个真正非常出色的“傻妞”。
Xinran: 所以《魔幻手机》可能很早就为你后来的职业选择埋下了一个种子?
穆尧:
很有可能。
编者按:《魔幻手机》于 2008 年播出。今天回看,“傻妞”这个同时连接数字信息、现实感知与物理行动的形象,很容易让人联想到今天关于具身智能和 Physical AI 的一些想象。感兴趣的小伙伴可以自行搜索观看,共同体会一下儿时穆尧老师的心情。
关于作者
Liz:Research AI+社区 Research Fellow,前🐧算法,野生全栈,热爱build,技术E人。专注于将前沿算法落地为真实可用的产品,也喜欢把抽象复杂的技术讲得通俗有趣。
Xinran:Research AI+社区发起人,Tongji+Cornell校友,HCI 野生研究者。