


投机解码是大模型推理加速的关键技术,DeepSeek提出的DSpark是SOTA算法之一。与一般的Dense草稿不同,DeepSeek在V4系列采用了更大的MoE草稿;训练所需的隐状态需由独立的推理服务在线提供。DeepSeek的V4系列配套了草稿权重,但未公开训练方案。昇腾为V4-Flash Preview构建了端到端的跨机训练管线,经过5轮训练,平均接受长度为4.416,达到官方权重的99.8%。
投机解码通过引入一个远小于目标模型的草稿模型,一次性提出多个候选 token,由目标模型单次前向并行验证,被接受的部分即可跳过对应次数的前向。端到端收益由草稿的平均接受长度和草稿模型投机开销、目标模型校验开销共同决定;其中平均接受长度反映草稿对目标模型输出分布的拟合程度,是衡量草稿质量的核心指标。
首先,大规模DSpark训练配方未公开;其次,草稿模型与训练方式引入的 Infra 复杂度高。接下来先介绍草稿模型本身的结构:它的每一层就对应目标模型的解码层,权重形状完全一致,架构上与目标模型的异同如下所示:
表1:草稿模型与目标模型的结构对照

块入口那组投影是草稿获知context的唯一途径。由于采用MoE架构,虽然草稿只有3层,参数规模仍较大:以bf16计算,仅权重就达到42GB,必须以分布式方式进行训练。

图1:DSpark 的架构与解码循环。
来源:Cheng et al.,arXiv:2607.05147,CC BY 4.0。
草稿模型训练的数据、
算力与训练配方
草稿模型的拟合对象是目标模型的输出分布,而原始语料自带的应答并非出自目标模型,因此需要提取提示词,由目标模型重新生成。数据集取自公开的open-perfectblend;应答生成与后续评测均在非思考(non-thinking)模式下进行(同DSpark论文,即DSV4聊天模式的默认配置)。实际业务中思维链和agentic 数据本文未涉及,若有需求可扩充对应数据。为了防止低质量的生成结果影响训练效果,生成结果需要先经过质量过滤,剔除空应答与退化重复两类(约占0.05%)。清洗去重后得到约80万条;因只取每条对话的首个用户轮,训练数据全部为单轮。
训练管线由三类角色构成:16张Atlas 800T A2承载bf16目标模型,边响应推理边存储第40/41/42 层的隐藏状态;8张Atlas 800T A2运行草稿训练(非 MoE 部分FSDP2并行、MoE部分EP8并行);另有一台Atlas 800T A3用于端到端评测。为了避免离线隐藏状态存储开销,本工作采用了在线滚动缓冲:按样本转储、用后即删。
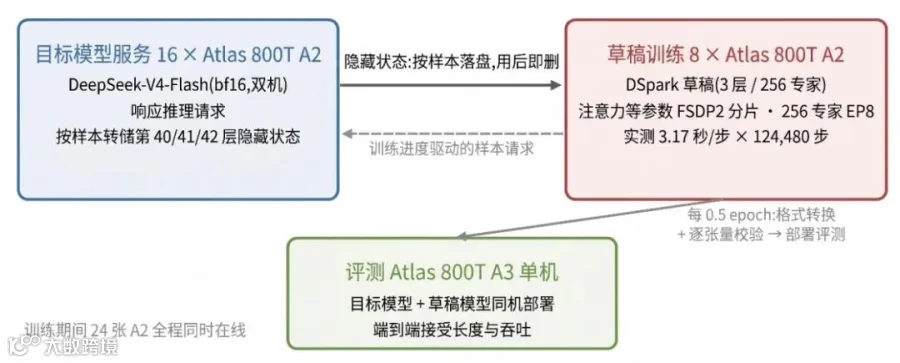
图2:训练管线拓扑与隐藏状态数据流
块大小block_size 5遵循官方发布的草稿配置;同时总序列长度 total_seq_len 设置成 3072。
权重初始化:1)整层热启动:草稿层与目标模型的对应层同构,自然的初始化方案是直接从第 40–42 层整层复制权重,训练收敛速度相比随机初始化取得了大幅提升。2)Router随机初始化:主模型的 router 权重拟合的是目标模型该层的原始隐藏状态,而草稿会把第 40–42 三层的隐藏状态拼接后投影回一层,输入分布完全不同;直接继承权重会导致专家负载向极少数专家集中,造成训练坍缩。而将 router随机初始化则可以避免该问题。
本工作参考torchtitan的EP实现,每张卡只持有E/EP个完整专家。专家权重与其余参数采用同一种分片表示,同时接入昇腾的融合grouped-GEMM算子实现高效的MoE计算。应用草稿EP并行后,完全消除了前向160 秒量级的尖峰,稳态耗时在 250–400 毫秒,优化器步降至100毫秒量级。
MoE提速后瓶颈转为等待隐藏状态,占总耗时57%。优化思路是提高单步的计算量,通过启用激活重计算并增加每序列采样的锚点数,使单步耗时与推理服务的产出速率匹配,这一优化使等待耗时降至35.7%。剩余等待耗时主要来自EP all-to-all时最慢的卡,这部分是个未来可行的优化点。
生产配置最终稳定在端到端3.17秒/步,合计约4.5天,显存峰值55GB。
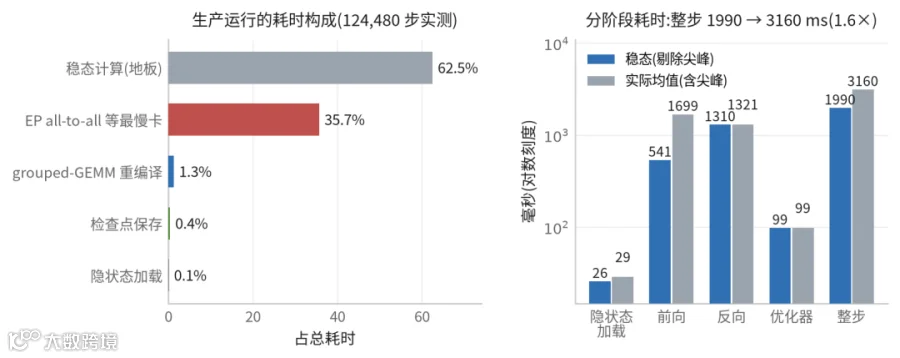
图3:生产运行的耗时构成
MoE的有效容量取决于有多少专家真正参与计算,负载均衡度是训练效率的关键指标。本工作参考官方权重的负载均衡度作为牵引,据此设定均衡强度后,最终配方每步的有效专家数稳定在 65–75(约四分之一)。我们也完成了反向消融试验:把强度拉到让绝大多数专家参与计算(有效专家数约120),五项平均反而降至2.66,远低于同批无均衡基准的3.63。均衡存在适宜的强度区间,并非越强越好。
开源实现中训练损失按各卡自身的监督 token 数归一化,数据并行取平均后,实际优化的成为“各卡比值的平均”而非按 token 加权的平均(实测各卡累计监督 token 数相差 19%,不随步数衰减)。该修复已提交上游社区评审。
总损失经124k步由5.62降至0.63,训练平稳收敛。

图4:训练损失。细线为逐步原始值,粗线为 500 步滑动平均;纵轴为对数刻度
下游5项benchmark任务平均分值与DeepSeek-V4官方DSpark草稿模型比值达99.8%。
表2:五数据集平均接受长度,与官方发布权重对照

评测为 Temperature=0 贪心解码,每步投机 5 个 token,使用完整数据集。官方草稿接受长度是在相同环境测试获得。主要差距在多轮对话数据集 mt-bench(94.2%),推测与训练数据全部为单轮有关。

图5:与官方发布权重的分数据集对照
投机推理中,维持靠后位置的接受率是决定平均接受长度的关键。下表是 gsm8k 上“在前缀已被接受的条件下,该位置被接受”的条件概率:
表3:gsm8k上块内各位置的条件接受率
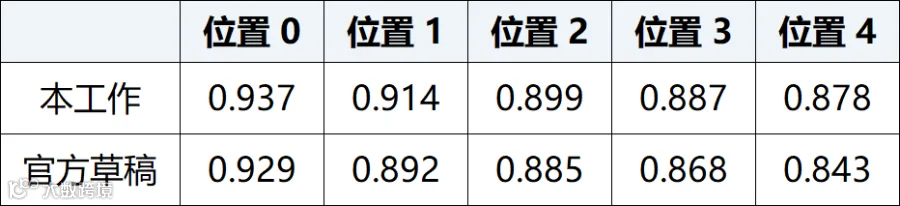
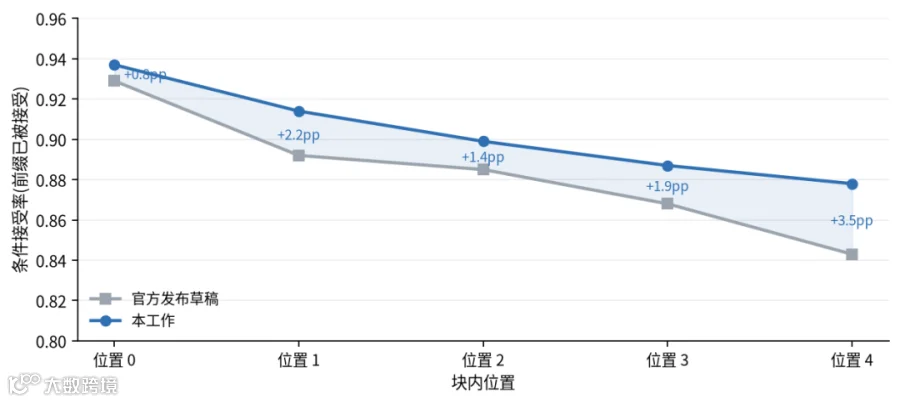
图6:逐位置条件接受率(gsm8k)
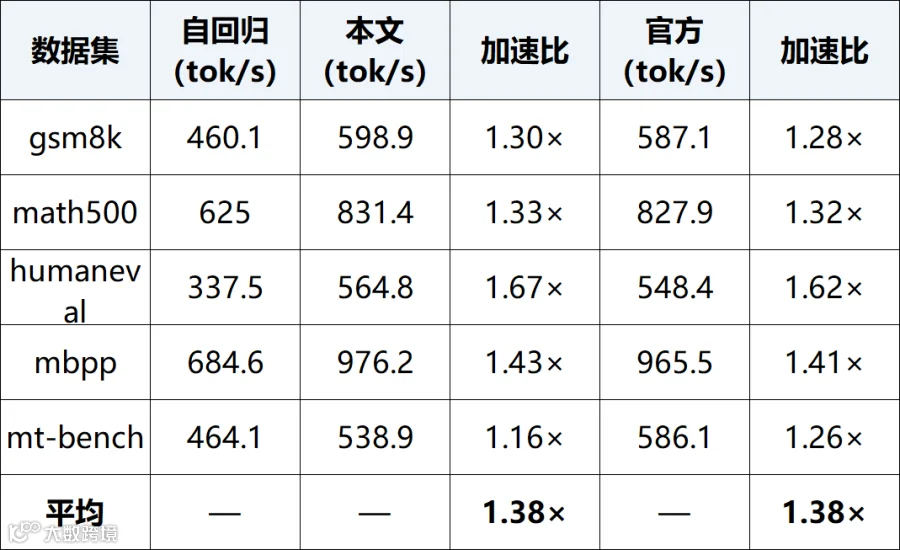
在1、48两个并发度下测得开启投机相比不开启投机,端到端(含 Prefill)加速比。并发48(服务吞吐口径):5个数据集平均加速1.38×,官方草稿同为 1.38×。并发1(单请求时延口径,gsm8k):2.27×,扣除首token时延(TTFT)后的稳态解码加速约2.6×。
表4:并发 48 下的端到端吞吐与加速比
此外,本工作的MoE草稿训练策略及加速特性已在某金融客户生产环境中应用。通过在业务场景数据的训练,所得的草稿模型接受长度提升了8%,实现DeepSeek-V4-Flash在数字助手场景下的推理加速。
本工作完成了DeepSeek-V4系列DSpark草稿模型在昇腾平台的从零训练实践,实现了高效的草稿模型训练管线,在DeepSeek-V4-Flash(Preview)上经过5个epoch训练,达成官方99.8%的接受长度,并在1并发下取得2.27×,48并发下1.38×加速。
本工作训练实践已于vLLM社区speculators框架提交RFC,欢迎大家试用交流!
开源社区代码链接:
https://github.com/vllm-project/speculators/issues/952
