

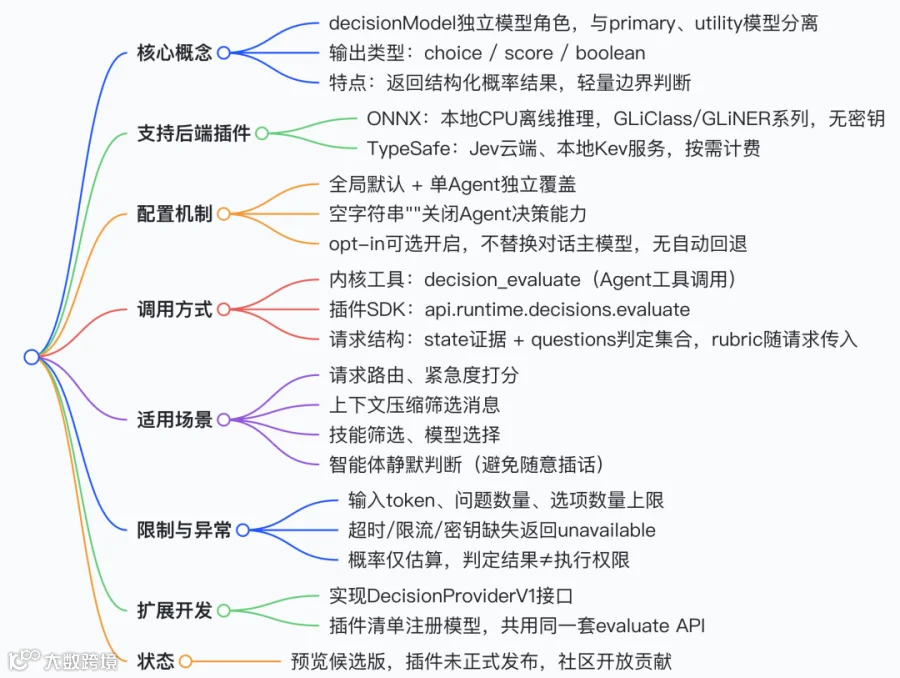
编者摘要:OpenClaw 新增决策模型(decisionModel)角色,作为独立于对话主模型、辅助摘要模型的专用判定层,用于处理边界明确的轻量判断任务,返回强类型结构化结果,替代低效的文本生成式判断。决策模型支持三类输出:choice 分类选项、score 标尺打分、boolean 布尔概率,统一 API 屏蔽底层模型差异,架构采用插件优先设计。
当前支持两大插件后端:ONNX 本地插件,可离线运行 GLiClass、GLiNER 等模型,无需云端密钥;TypeSafe 插件,对接云端 Jev 或本地 Kev(System One)推理服务。决策模型为可选启用,Agent 支持全局默认配置与单 Agent 独立覆盖,置空则关闭该 Agent 决策能力,不会自动回退至对话主模型,原有 Agent 逻辑不受影响。
提供两种调用方式:一是内核内置decision_evaluate工具,Agent 获得权限后可直接在工具链调用;二是插件 SDK 接口api.runtime.decisions.evaluate,插件、钩子可复用 Agent 已配置模型,无需单独管理服务商密钥。单次请求传入证据 state 与批量判定问题,判定规则随请求携带,无需预先注册标尺 rubric。
决策模型适合工单路由、紧急度评估、上下文筛选、技能精选、判断 Agent 是否发言等场景,同时存在严格输入上限,ONNX、TypeSafe 各自有 token、选项数量约束。概率仅为估算值,判定结果不自动授权执行动作;服务异常(超时、缺密钥、限流)返回 unavailable 状态,由调用方自主降级。
开发者可自定义 Provider 插件,实现 DecisionProviderV1 接口即可接入新模型。整套能力尚处于实验预览阶段,插件未正式发布,鼓励社区贡献使用场景与 PR,在真实业务中验证决策模型价值。

10 个关键 Q&A
-
Q:OpenClaw 决策模型是什么? A:独立模型角色,专门做边界清晰的轻量判定,输出结构化选项、分数、布尔概率,区别于生成文本的对话模型。 -
Q:决策模型会替换 Agent 的对话主模型吗? A:不会。属于可选组件,不开启时系统保持原有逻辑运行。 -
Q:支持哪些模型后端? A:ONNX 本地离线模型;TypeSafe 插件支持 Jev 云端、本地部署 Kev。 -
Q:Agent 如何配置决策模型? A:支持全局默认配置,也可以给单个 Agent 单独指定;配置为空字符串则关闭该 Agent 决策能力。 -
Q:有哪两种调用决策模型的方式? A:①Agent 内核工具 decision_evaluate;②插件 SDKapi.runtime.decisions.evaluate。 -
Q:rubric 判定标尺需要提前注册吗? A:不需要,标尺随每次请求一起传入。 -
Q:score 打分代表模型准确率置信度吗? A:不是,只是标尺上的位置值,不是概率。 -
Q:如果决策模型服务不可用会发生什么? A:返回 unavailable 结果,不会自动降级调用对话模型,由调用方自行处理降级。 -
Q:可以开发自定义决策模型插件吗? A:可以,实现 DecisionProviderV1 接口,在插件清单注册模型即可接入统一 API。 -
Q:决策模型判定成功后,会自动执行操作吗? A:不会。判定结果仅作为参考,不自动授予执行动作的权限。
附录一 OpenClaw 中的决策模型
一切都向着 Jev 向好发展!上周 https://x.com/jlehman_ 在 OpenClaw 核心以及插件中落地了对决策模型的支持。本文将介绍我们对决策模型的设计思路,以及你该如何贡献代码,借助这一强大新工具,一起优化 OpenClaw!
OpenClaw 中的决策模型
Josh Lehman 解读:决策模型能实现什么、OpenClaw 为何优先采用插件化架构,以及社区贡献者可以从哪些方向参与。 发布于 2026 年 9 月 22 日・阅读时长 7 分钟 视频:https://youtu.be/zGjDLSAMgYg
构建智能体时,存在大量不需要走对话交互的决策:这条请求该调用哪些工具?哪些消息需要在上下文压缩后保留?用户是不是真的在和智能体对话,还是智能体应当保持静默?
我们可以调用大语言模型来做这些判断,但这会增加用户任务的耗时与成本。当智能体要处理越来越多这类微小判断时,额外的模型调用开销就会变得不容忽视。
上周,Jev 的出现,让很多开发者重新权衡了这笔取舍。今天,OpenClaw 维护者 Josh Lehman 将分享:决策模型为何吸引了他,我们如何把决策模型接入 OpenClaw,以及最有意思的创新将来自社区。
不止是又一个用来聊天的模型
真正巧妙之处,是把 Jev 嵌入到常规的确定性代码里运行。 ——Josh Lehman,OpenClaw 维护者
Josh 的第一个实验思路很直观:开发一个插件,给智能体增加调用 Jev 的工具。方案跑通了,但问题是:要用一个慢速大模型,去判断什么时候调用这个高速 API,效率并不理想。
更有价值的思路,是直接在业务应用代码中调用决策模型。
决策模型接收证据与一组判定标准,返回强类型结果:一个选项、分数,或是某个条件成立的概率。不再需要让模型输出一段文本,再由程序解析意图;应用程序直接拿到可用于下一步执行的结构化答案。这不代表判断绝对不会出错,但给开发者提供了高度聚焦的调用接口。
由 Diogo Almeida 和 TypeSafe 团队推出的 Jev,让这种方案获得大量关注: 它的吸引力,不只是让原有模型调用变快。当一次判定足够廉价、足够快时,你可以把决策模型嵌入到过去根本不会考虑放置模型的位置。应用可以做出更好的判断,且不必把这个判断过程变成一轮新对话。
向开发者交付能力,而非替开发者敲定所有答案
你不必等 OpenClaw 核心维护团队来决定,决策模型应该集成到你的运行框架的哪个位置。 ——Josh Lehman,OpenClaw 维护者
Josh 在实现这套能力时,不需要预先穷尽决策模型所有可用场景,只需要让大家可以上手试验。
OpenClaw 原本就支持自主选择对话大模型;本次沿用同样思路:独立配置一套决策模型,供 OpenClaw 内核和各类插件使用。优先插件化的架构,意味着这套能力并不绑定单一服务商。TypeSafe 适配器既支持云端托管的 Jev,也能对接本地部署的 System One 服务(例如 Jared Palmer 的 Kev)。
对于插件开发者来说,核心是统一的共享 API。通过插件 SDK,插件可以调用 api.runtime.decisions.evaluate,直接使用当前智能体已配置好的决策模型。插件不需要单独对接每一家模型服务商,也不用让用户重复配置多遍。
该接口已合入包含决策模型新特性的开发版本;各服务商配套软件包还待正式发布。文档 https://docs.openclaw.ai/concepts/decision-models 说明了当前可用功能与上手方式。目前只是用于实验的底层基座,并非所有设想场景都已经正式上线。
社区的实验热情显而易见。Vercel 反馈:Jev 在其 AI 网关的采用速度,超过了此前任何一款模型。
这是一项可选实验,而非强制新要求
就算不启用决策模型也完全没问题,系统会保持原有逻辑正常运行。 ——Josh Lehman,OpenClaw 维护者
项目尚处早期。Jev 上周才发布,同类备选模型也在持续增加,我们还在探索 OpenClaw 的哪些模块最适合采用决策模型。
决策模型为可选开启。配置后,支持该能力的功能与插件可以使用它;它不会替换你的对话模型、不会自动后台执行任务,也不会全盘修改智能体行为。不配置决策模型,OpenClaw 照常工作。
另外要区分两件事:应用代码直接调用决策模型,和智能体通过工具调用决策模型。评估接口已经作为 decision_evaluate移入 OpenClaw 核心,不局限于 TypeSafe 或 Jev。Josh 的首个插件实验并非毫无价值,只是没有发挥出这套方案的全部潜力。
目标是:在适合的场景下,实现更快响应、更低成本、更少重试,拿到更好效果。我们需要在真实工作流里验证,而不是想当然地认为只要接入新模型,所有判断就会自动优化。
当然,时间线已经推导出一个很实在的目标: 我们不是要取代麦当劳。我们只求智能体能知道什么时候该闭嘴。
社区可以发力的方向
Peter 的 OpenClaw 智能体 Molty 部署在团队 Discord 里。按 Josh 的描述,Molty 总喜欢在两个人聊天时插嘴,而对方根本不是在跟它对话。大家只能反复让它安静,之后再重新继续对话。
解决办法之一:每次消息进来,先用独立模型判断智能体是否需要回复,再允许它发言。但如果在繁忙频道,每一条消息都额外发起一轮模型调用,会在原本就慢的大模型调用前,再增加一笔开销。
高速决策模型,就能让这个校验方案变得可行。只是一个微小判断,却能极大改善人和智能体共处的体验。
Josh 和我录制内容的时候,社区已经提交了近 15 个 PR,提出在 OpenClaw 各处接入决策模型的方案。其中一个例子:过滤工具与技能定义,让主模型不用花费大量算力筛选哪些能力可用。
我们讨论的其他潜在场景:
-
技能精选:低成本高频审核、合并已习得的技能 -
上下文管理:在上下文压缩阶段识别有效消息,或者缩小历史对话检索范围 -
模型路由:根据用户已配置的模型池,为新任务挑选合适模型
这些都是待探索方向,不是已经完工的功能清单。这也是当下最有意思的地方:维护者不必预判所有使用场景,贡献者也不用等完整路线图定稿,就可以动手尝试。
社区征集贡献
对用户而言,最终目标就是让系统变得更快更好。用户甚至不需要感知背后的细节。 ——Graham McBain,OpenClaw 基金会
对终端用户来说,最理想的状态是:根本不用了解什么是决策模型。智能体响应更快、检索到正确上下文,或是不再随意插话。体验上的提升,远比底层模型名字重要。
对开发者来说,有大量空间可以参与:你可以向 OpenClaw 主仓库贡献代码,或是开发插件复用用户配置的决策模型。统一接口已经就绪,你只需要聚焦你想优化的那部分能力。
如果你感兴趣,欢迎加入我们的 Discord:https://discord.gg/clawd,进入贡献者讨论区,分享你的使用场景。告诉我们:你现在正在为哪些慢速判断付出成本;或是,如果这类判断足够快,你想构建什么功能。
我们尚且不知道决策模型所有适用场景,这正是开放社区共创的意义。
关键词中英对照
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
概念与配置
决策模型:基于判定标准 (rubric) 评估传入证据,返回强类型结果:选项、分数或者布尔概率。适用于有边界的判断任务:请求路由、紧急度打分、条件校验。
decisionModel是一类模型角色,共用一套 API。底层提供商可以使用不同模型架构与推理后端。统一接口不代表它们推理能力、概率输出可以直接互换。
该角色与 TypeSafe AI 适配器,在 OpenClaw 2026.9.5 版本发布后新增。本文档适用于包含该特性的开发版本以及后续正式版。每个提供商页面可查看主机部署要求。
模型角色对照表
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
决策模型在控制面板 UI 有独立的 Decision 选择器。选中的提供商用于显式调用 evaluate 和支持该能力的消费模块。核心工具decision_evaluate遵循该选择 + 常规工具策略。选中决策模型不会启动后台任务,也不会替换对话模型。自动实验功能需要手动开启decision-assistance实验开关;Labs 开关仅为底层闸门,目前暂无自动消费模块;decision_evaluate显式调用不受 Labs 控制。
选择提供商与模型
必须先安装配置提供商插件,再选择模型
-
ONNX 插件:本地 CPU 分类器,常驻子进程。下载 ONNX 模型制品,无需云端 API 密钥。 支持模型:deberta-v3、GLiClass、GLiNER 系列 -
TypeSafe 插件:对接托管 Jev 或本地 System One 服务(Kev)。配置密钥或本地回环地址。云端推理会把证据发送 TypeSafe 并产生计费。
两个插件目前均为未正式发布候选版本。
Agent 配置规则
-
Agent 未单独配置:继承全局默认 decisionModel -
Agent 配置为空字符串 "":禁用该 Agent 所有决策能力 -
全局默认未设置 / 为空:决策模型全局关闭 -
不存在自动降级回主对话模型
本地验证 CLI: openclaw onnx models list查看预置模型 openclaw onnx probe gliclass-edge-v3.0跑通冒烟测试(选择、打分、布尔)
定义一次决策请求
单次请求包含共享 state 与 questions 字典。state 支持文本 / JSON / 数组 /null。question 键作为答案标识,instructions 与 criteria 定义判定规则。判定标准随请求一同传入,无需提前注册。
表格
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
ONNX 模型建议给布尔类型同时编写 true 和 false 描述;证据尽量精简,state + 提示词 + 判定标准会占用 token 预算。
Agent 评估工具:decision_evaluate
当 Agent 配置有效 decisionModel,且满足工具策略、无显式禁用,Agent 会获得decision_evaluate核心工具。未配置 / 置空的 Agent 不会拥有该工具。
调用时传入 state 证据与 questions 批量问题。 每个 question 读取相同 state,无法读取同批次其他问题结果;存在依赖关系需要拆分成多次调用。工具不会读取对话上下文;由当前 Agent 绑定选定模型,输入不能强行覆盖模型选择。
返回结果保留布尔概率、零基小数分数、原始概率分布、可选 usage 用量、模型溯源信息。不会自动生成解释,也不自动授予执行权限。 数据会发送至配置的推理端点,仅发送授权数据。
错误处理
缺失密钥、限流、服务过载、临时服务商报错:工具仍然可用,返回unavailable结果。 配置变更遵循工具 / 上下文刷新生命周期;执行时会重新校验模型选择与权限。取消信号会传递给决策运行时,不会自动执行降级兜底。
在插件中调用决策模型
插件、钩子、自定义工具内可调用 api.runtime.decisions.evaluate插件无需引入提供商 SDK、不用管理 API 密钥。主机自动读取所属 Agent 配置的模型。 入参包含 agentId、purpose 用途标识、rubricVersion 标尺版本、timeout、cancel 信号。 成功返回outcome.result.answers,包含每个 question 的结构化答案、模型信息、用量与溯源。
分数与概率解读
分数是基于标尺的零基位置。例标尺["无中断","轻微阻塞","重要流程阻断","大范围故障"],长度 4,索引 0~3。分数 2.85 代表接近最高严重等级。
该数值是标尺上的位置,不是准确率置信百分比。
ONNX:logits 经 softmax 归一化;Choice 取最大值,Score 为概率加权索引。 TypeSafe:直接保留 Jev 返回标签、分数、概率;四舍五入概率总和不一定严格等于 1。 布尔概率靠近 0 代表倾向 false,接近 0.5 代表模糊。 独立标签请使用多个布尔问题,不要全部放到同一个 Choice。 开发者自行定义动作阈值(例如 probabilityTrue ≥0.9 才升级告警);概率仅为估计,不保证精度。判定结果不等于操作许可。
请求限制 & 不可用结果
可移植标尺建议:最多 32 个问题;Choice 选项 2~64;Score 标尺 2~10 个锚点;证据尽量简短。
-
ONNX:最多 32 问题;单编码输入 512token;批量输入上限 1MiB -
TypeSafe AI:Choice 最多 255;Score 最多 10 级;受服务商批量限制
系统全局限制:单请求 1MiB、20000 JSON 节点、深度 32、最多 256 个问题;每个提供商最多并发 4 请求,最大超时 30 秒。超出限制直接拒绝,不会静默截断。 不可用 reason:disabled 未启用、not-configured 未配置、unsupported-input 输入不支持、overloaded 过载、deadline 超时。由调用方决定跳过 / 延迟 / 业务降级。 ONNX 大模型冷加载在低配机器容易超时;内存充足时保持模型常驻,或者选用更小模型。
开发自定义决策模型插件
插件需要实现DecisionProviderV1接口,调用api.registerDecisionProvider(provider)注册。 manifest 清单声明decisionProviders合约和decisionModels模型元数据,模型 ID 会出现在全局决策模型目录。所有消费端使用同一 evaluate API。 插件负责模型输入转换、网络 / 本地推理、凭证管理、取消时资源清理。isReady()必须同步无网络,仅校验凭证就绪,不检查模型预热。返回真实概率估算,不要强行编造确定性输出。