这场硅谷机器人读书会核心争论:靠摄像头视频,能不能搞定机器人灵巧抓取?
结论:视频擅长教机器人理解场景任务,但看不见被手挡住的接触、受力,精度只有厘米级,做不好指尖精细操作。软数据手套是现在主流,但软材料会形变、漂移、传感器乱跳,接触位置算不准。
核心新思路:最优采集手套得是刚性的。刚性手套结构和机器人机械手完全一致(共用一套 URDF 模型),不用做动作重映射。重映射会丢失真实接触信息,这是很多数据集的大坑。人手戴刚性手套采集,直接镜像给机器人,接触点靠运动学正向计算,不是靠摄像头重建。牺牲一部分佩戴舒适度,换取接触力、接触位置的可靠测量。
两大仿真工具做补充:OmniReset 用多样化重置状态,让强化学习学到各种接触工况,解决仿真里见不到关键状态的问题;Bench2Dex 是评测基准,提醒大家不同机械手不能混用分数,还要用更严谨指标评估。
大模型分工发生变化:GPT‑6 Astra 这类大模型擅长上层任务规划,但解决不了手部精细接触控制。Jev 是低延迟底层动作候选模型,但目前缺少严谨机器人测试。 新闭环 Real2Sim2Real:Astra 写仿真环境,OmniReset 大规模训练,再部署回真实机器人。但前提:仿真模型必须和真实刚性手套‑机械手几何完全匹配,不然白搭。
老项目经验提醒:不要迷信大模型,底层硬件测量、故障重试、机械结构依然决定可靠性。

10 个关键问题问与答
Q1:既然人类视频能预训练机器人,为什么还需要数据手套?
A:视频擅长场景理解,但手会遮挡接触区域,无法直接测量接触力,精度只有厘米级,满足不了指尖毫米级精细抓取,只能做预训练,后训练精细操作必须接触数据做补充。
Q2:现在主流软手套有什么致命问题?
A:软材质受力变形,两次佩戴会漂移;触觉传感器跟着弹性材料滑动,接触位置无法由关节角度推导,接触信息不准。
Q3:刚性手套核心逻辑是什么?
A:刚性连杆位置由关节角度确定,触觉传感器只需要报表面上哪一点发生接触;接触是计算出来,不是摄像头重建出来。
Q4:什么叫重映射?为什么说重映射会 “偷走接触信息”?
A:把人手套动作转换为机器人手动作叫重映射。重映射只对齐骨骼姿态,无法保留真实接触点坐标,后训练用重映射数据,接触标签已经失真。
Q5:Aero‑UMI/Aero‑Hand 设计原则是什么?
A:采集手套和机器人机械手协同设计,1:1 共用 URDF 模型,零重映射,实现 “人手‑戴手套‑机器人手” 动作镜像。牺牲部分舒适度换测量精度。
Q6:OmniReset 解决仿真里的什么痛点?
A:普通强化学习很难采样大量接触丰富的关键状态;通过 4 类多样化重置,让 RL 反向从接近成功状态往外学,大幅拓宽状态覆盖。
Q7:Bench2Dex 最大的提醒是什么?
A:不同机械手硬件不能混用性能结果;不能只看简单成功率,要区分不变 / 等变泛化、阶段完成率;基准数据集本身是重映射采集,不适合原生接触研究。
Q8:GPT‑6 Astra 很强,为什么还搞刚性手套、触觉?
A:Astra 擅长高层任务规划(规划层),但精细手部接触闭环没有被大模型解决;语义能看懂,但是拿捏物体打滑、接触力度搞不定。
Q9:Jev 号称低延迟,能直接拿来做机器人手控制器吗?
A:暂时不行。现有结果是少量仿真样例,缺少严格消融、多随机种子测试;宣传准确率是和别的大模型比对,没有人类真值,需要完整机器人评测协议验证。
Q10:Real2Sim2Real 这套闭环最大陷阱是什么?
A:Astra 生成仿真场景,如果仿真机械手几何、物理参数和真实硬件不一致,哪怕画面看着很像,训练出来策略迁移到真机直接失效,必须保持 URDF 几何严格对齐。

附录 机器人与世界模型读书会:最优数据手套应当是刚性。GPT‑6 Astra、OmniReset、Jev
周六机器人 & 第 29 期世界模型读书会 🎤主讲人:徐(乔)・董(栗壳机器人,Chestnut Robotics),托尼・普拉卡尼斯 主持:朱俊帆、冯奥若拉、黄杰瑞
第一部分・乔・董(栗壳机器人):最优的手套是刚性的
01・已经达成的共识
董没有铺垫基础背景,参会人员对此已有了解。
-
人类视频可以预训练机器人策略。引用文献:《物理智能》,《视觉‑语言动作模型中人类到机器人迁移能力的涌现》(2025);英伟达 GEAR、EgoScale(2026)。幻灯片页脚标注:裸手。核心观点:不是说视频毫无用处,而是视频并不适合用来完成抓取这一最终动作。 - 数据决定架构
,这是第一个核心论断,配有双路径示意图(乔・董,《你能捕获的那只右手》,个人通讯简报,2026 年 6 月): -
第一视角(头戴相机)的图像,向基于视频监督训练得到的世界模型,输出稠密原生视频流。 -
从同样的第一视角画面中,推理得到厘米级精度的动作,输入基于动作监督训练的视觉‑语言‑动作模型(VLA)。
核心信条:世界模型以视频为输入;视觉‑语言‑动作模型以动作为输入。
如果你仅有第一人称视频,你可以训练得到像素层面稠密的世界模型,但无法真正训练得到接触层面稠密的 VLA。从视频提取出来的动作标签属于推理结果,并非实测数据,精度上限仅为厘米级,达不到指尖接触物体边缘时所需要的毫米级精度。
02・相机无法弥合的鸿沟
幻灯片上两行关键词:被遮挡、未被测量。
配图为俯视视角下,拳头压在方块上,相机从上方拍摄。手部自身就会遮挡视野,接触信息完全隐藏。幻灯片底部红色框提出问题:接触力多大?给出答案:视频无法测量力。
这不是临时的传感器缺陷,而是几何层面的固有难题。决定物体是否打滑、形变、就位的接触事件,恰恰是腕部 / 头部相机最难观测到的事件。
三维重建技术持续迭代,但始终存在性能上限。图标题为接触性能上限:从视频恢复得到的动作精度不断提升,但最终会收敛于一条虚线代表的上限。这个上限 “由相机观测能力决定,而非算法能力”。 幻灯片给出数据:无标记点追踪对比标记点追踪,关节角度平均误差 10.9°。 来源:马焦尼、阿泽维多‑科斯特、杜兰德、巴伊,《Sensors》期刊,25 卷,论文 1079 号(2025)。 幻灯片注明限制条件:仅为四相机配置、15 名受试者的实验结果,并非普适理论边界。
图下这句话值得所有 “靠更好手部追踪就能解决一切” 的讨论引以为戒:
再好的重建算法,也无法还原从未被记录下来的信息。
力从未被记录;自遮挡下的手部接触位置从未被记录;自遮挡下亚度级别的关节姿态从未被记录。再优秀的优化器也不能凭空生成测量数据。
因此:接触数据是视频数据的补充,而非替代品。
-
预训练阶段:视频带来广度,覆盖物体、场景、各类人类任务; -
后训练阶段:接触带来精度,记录手和物体接触的位置与作用力。
接触数据建立在第一视角视频之上,并不替代视频。这就是栗壳机器人整套技术栈的核心理念。不要舍弃 Ego4D 规模的视频数据集,也不要幻想视频可以充当力‑力矩传感器。
03・尖锐观点:软性是问题根源,而非特性
软性是数据手套一切问题的根源。三张示意图展示三类故障,根源同源:
- 漂移
同一只手套两次佩戴,得到的运动学模型不一致,两次采集会话之间存在偏差。 - 形变
“接触点到底在哪?” 柔性表面受力会发生形变,接触位置不再单纯由关节角度决定。 - 噪声
传感器附着在可形变基底上;触觉单元会随着布料 / 弹性材料相对骨骼发生滑动。
三者根源来自同一个设计选择。页脚标注 UMI(人机交互采集设备)。软性手套看似对人类更友好,但对测量非常不友好。
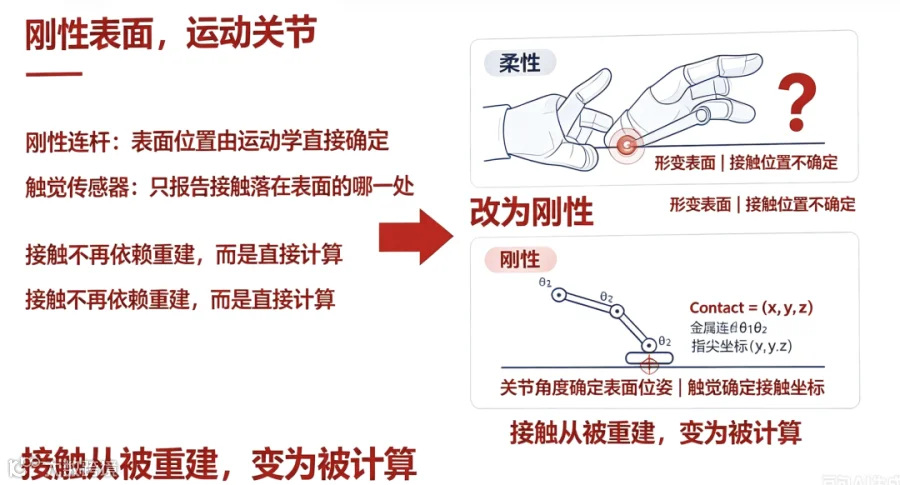
刚性表面 + 可运动关节,构成刚性手套两大核心特性:
-
刚性连杆意味着表面位置完全由运动学计算确定; -
触觉传感器只需要报告接触落在该表面的哪一处。
软性方案示意图:表面发生形变,接触位置不确定,接触区域标注问号;箭头标注改进方向:改为刚性。 刚性方案示意图:由关节角度确定表面位置,触觉传感器确定表面上的接触坐标。
已公开发表的典型实例:ART‑Glove,林、赵,卡内基梅隆大学,arXiv:2606.16370(2026)。(配图:乔・董,2026)
点睛金句:
接触不再依靠重建得到,而是直接计算得出。
这是整场报告的核心。重建属于逆问题,受相机能力限制存在性能天花板;而计算则是正向运动学,触觉传感器部署在位姿已知的刚性表面上。
选择刚性手套必然要付出代价,是一种取舍权衡: 天平左端:软性手套带来的活动自由度;天平右端:刚性手套带来可靠测量。团队选择向测量一侧倾斜。
代价:采集数据的场景广度有所损失,但换来留存数据的高可信度。刚性人机采集设备无法适配所有人手尺寸,不能让人连续佩戴八小时完成各类厨房家务。董的判断:后训练阶段不需要如此宽泛的数据广度,需要的是高可信的接触数据。
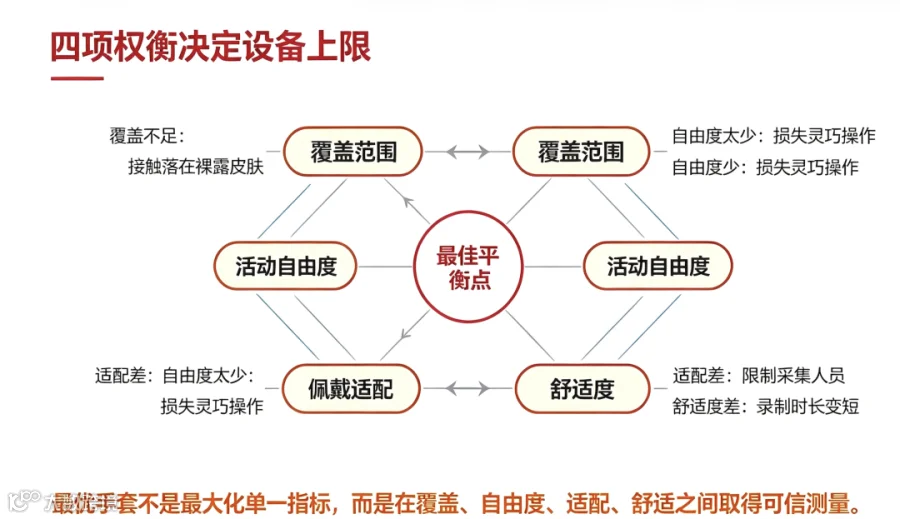
四项权衡要素决定设备上限,菱形示意图标题:最优平衡点,标注每一项投入不足带来的故障模式:
- 覆盖范围
不足则接触发生在裸露皮肤上,没有传感器采集; - 活动自由度
关节过少直接损失灵巧操作能力; - 佩戴适配性
适配差直接限制能够采集数据的操作人员; - 舒适度
舒适度差,单次录制时长变短。
提升任意一项指标,都会给其余三项带来压力。(配图:乔・董《数据手套应当是刚性的》2026)
这不是一句口号,而是完整的产品需求文档。
-
只追求覆盖不考虑舒适:操作员只能录制 20 分钟就无法继续; -
只追求自由度不考虑适配:仅有特定操作人员手部可以输出有效的机器人统一描述文件(URDF)对应数据; -
只追求适配不考虑覆盖:用来稳固工具的手掌接触事件完全无法被传感器捕获。
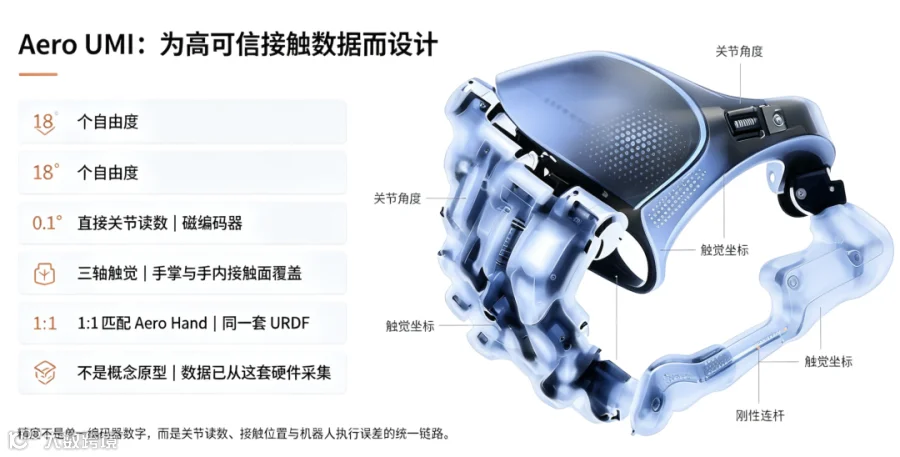
Aero UMI 就是瞄准该平衡点打造的硬件设备。公开参数见官网 chestnut.bot/aero‑hand,幻灯片展示规格:
-
18 个自由度; -
通过磁编码器实现 0.1° 直接关节读数; -
三轴触觉传感器,覆盖手掌与手内接触面; -
和 Aero 机械手一一对应,关节完全匹配同一套 URDF。
这不是概念原型,团队的数据就来源于这套硬件。很多刚性手套相关报告只停留在渲染效果图,而本项目的采集设备已经投入实际数据采集。
04・推论:重映射会丢失接触信息
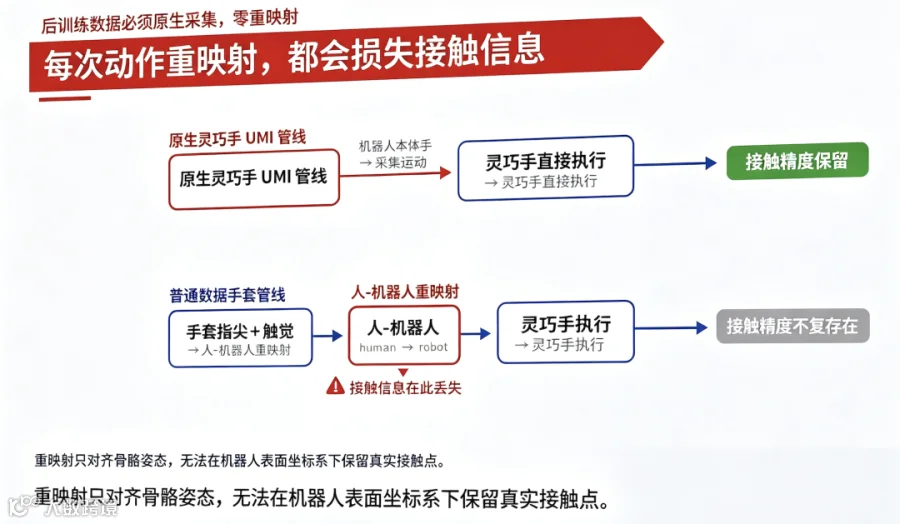
每一次动作重映射,都会损失接触信息。两套技术管线对比(乔・董,2026 年 6 月)
- 原生灵巧手人机采集管线
机器人本体手部几何结构采集运动,不存在重映射步骤,灵巧手直接执行动作。接触精度得以保留。 - 普通数据手套管线
手套指尖、触觉传感器采集运动;经过 “人‑机器人重映射” 环节做动作映射,再交由灵巧手执行。重映射方框上红色标注:接触信息在此丢失,接触精度不复存在。
后训练数据集必须是原生采集,零重映射。
这是工程实践准则。预训练可以使用视频推理出来的动作;但后训练阶段,也就是学习手部与物体接触位置、接触力度的阶段,无法承受运动学重映射带来的损耗。重映射只对齐骨骼姿态,无法在机器人表面坐标系下保留真实接触点。
由此引出近乎宣言式的结论:
手套的几何结构必须等于机器人手部几何。先设计采集设备,再衍生出机器人机械手。
大多数实验室的做法:先设计性能优秀的机械手,再寻找可以驱动机械手的数据手套。栗壳机器人反其道而行:测量设备是第一优先级,执行器设备是它的孪生版本。
两者协同设计,作为一套整体开发。幻灯片带有 IROS 2026 标识:栗壳机器人 —— 复刻人类灵巧性。Aero UMI 采集手套、Aero 机械手协同设计,消除实体形态差异。配图风格类似《亚当的创造》:戴着 UMI 手套的人类手指伸向机器人手指。目标不是 “两者相似”,而是完全镜像复刻。
同一个任务,三组画面:裸手操作、佩戴 UMI 手套操作、机器人操作。 同一套动作,三套实体载体,中间没有任何转换。这就是 “消除实体形态鸿沟” 的实证标准。人类视频、佩戴 UMI 的人类视频、机器人视频,三者运动逻辑完全一致,全程不引入重映射。
05・保证形态一一对应的工程实现
演示效果是一整条链路,董将其画为四个方框,三处连接节点: 人手 → 佩戴适配 → 可穿戴测量设备 → 测量精度 → 机器人执行 → 标定 → 可训练片段
- 佩戴适配
设备不能改变人手本身动作姿态; - 精度
包含三项完全不同的指标,不是单一数字; - 标定
基于视觉的主动逐关节标定;
链路下方标注时序约束:所有数据流必须共用同一时钟,否则全部数据失去意义。
收尾总结:整套演示链路性能取决于最薄弱的那一环。
“精度包含三项完全不同指标” 这一点很容易被忽略,但至关重要。
三项指标分别是:关节角度读取误差、刚性表面接触位置误差、同一套 URDF 下机器人执行误差。只引用编码器分辨率 0.1° 就宣称整个系统高精度,是很多论文的常见误导手段。
几何完全一致,因此机器人手部位姿是直接确定的,不需要求解。 三张画面:办公室内红黄金鱼玩偶;原始录制画面;把机器人手按照已知位姿叠加到录制场景的画面;重建渲染画面。
参考管线:DexUMI,徐等人,CoRL 2025。 栗壳机器人新增:标定、仿真、多阶段图像修复。
叠加渲染环节无需求解逆问题,位姿已经确知。这就是 “接触通过计算得到” 的可视化实现。因为 UMI 手套与机械手共用同一 URDF,不需要求解逆问题反推机器人手部位置,只需要通过正向运动学把机械手投影到录制相机画面,再做图像修复。GAIN3D 是团队公开规划中的几何感知图像修复算法:输入人类演示数据,输出机器人视角像素画面,全程无重映射。
06・如何验证这套方案真正生效
幻灯片给出评估方案,而非最终结果;报告坦诚最终效果会随着产品正式发布一并公开。
实验设置:本项目采集数据集 → 通用策略模型 → Aero 机械手。
两组消融实验,必须完成验证:
-
触觉传感器:开启 / 关闭 -
图像输入:重建生成图像 / 原始图像
策略模型主干引用:齐等人,Diffusion Policy,RSS 2023。
这是整套验证协议,结果随产品发布公开。 可以理解为要完成 2×2 对照实验:原生触觉输入是否提升任务成功率?在几何匹配前提下,重建机器人视角图像相比原始人类视角图像是否带来增益。 如果关闭触觉之后性能没有下降,则刚性手套的核心假说就站不住脚;如果重建图像对比原图没有提升,则 “直接放置手部,而非反推求解” 的管线就只有表面效果。
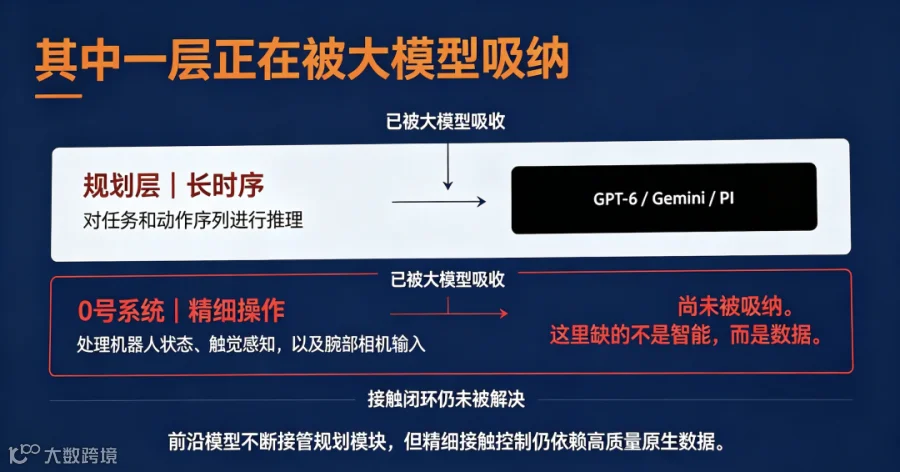
07・展望:高层智能已经被大模型吸纳;接触层面能力尚未被吸纳
系统分为两层架构:
- 规划层(长时序)
负责任务推理与任务序列规划。这部分能力已经被 GPT‑6、Gemini、Physical Intelligence 模型吸纳。 - 0 号系统(精细操作层)
处理机器人本体状态、触觉感知、腕部相机输入。尚未被大模型吸纳。
缺失的不是智能,而是高质量数据。
报告中最精辟的一句话,引出后续全部内容:前沿大模型不断接管规划模块,但接触闭环还没有被大模型解决。现存短板不是 “我们需要更强的 VLA 模型”,而是测量层面的问题:需要部署机械手本体上原生、刚性、时间对齐、零重映射的接触数据。
后续分享内容,介绍领域内如何补齐这块短板:仿真领域的 OmniReset、评测基准 Bench2Dex、0 号系统控制器 Jev,以及 Astra 大模型结合计算机使用能力。
第二部分・OmniReset:缺失的数据,是智能体曾经访问过的系统状态
论文《通过多样化重置与大规模强化学习涌现灵巧操作》,尹、威斯布鲁克、张、特兰、达尼诺、希拉姆卡尔、姆比齐沃‑蒂亚波、巴加里亚、刘、马林斯、科洛博夫、古普塔。华盛顿大学、英伟达、微软研究院,ICLR 2026,arXiv:2603.15789。项目主页:weirdlabuw.github.io/omnireset
乔・董的报告主题是如何采集人类手部测量数据,让孪生机械手完成后训练。OmniReset 解决另一个互补的数据稀缺问题:即便在仿真环境中,在线强化学习也很难访问到大量充满接触交互的状态,因此无法学习出这些状态对应的操作技能。
诊断结论:大规模并行物理仿真已经可以很好缩放 PPO 算法。真正没能实现规模扩展的,是交互状态流形的覆盖度。传统方案只会遍历一小部分状态空间,性能趋于饱和;研究人员就会增加演示数据、课程学习、奖励函数设计。而 OmniReset 提出:以上做法,是把状态覆盖问题错误当成监督学习问题来处理。
完整技术方案,完整链路:
- 生成多样化重置状态
:为 PPO 自动生成重置状态,分为四类,而非人工编写课程学习: -
接近目标:物体接近目标位姿,夹爪靠近物体,几乎快要完成任务; -
已抓取:机器人已经稳定握住物体; -
靠近物体:夹爪贴近物体,进入接触状态; -
到达状态:夹爪随机放置,物体在工作空间任意位置。 - 大规模基于状态的强化学习
:使用 64000 以上并行仿真环境运行 PPO。不需要演示数据、不需要奖励塑形、不需要人工课程。一套固定超参,一套统一奖励函数适配大量不同任务。 - 向感知端蒸馏模型
、得到基于 RGB 图像的学生策略,加入大量视觉随机化:光照、背景、物体外观、机器人外观、工作台纹理、相机位姿与视场扰动。 - 部署
零样本从仿真迁移到真实硬件,仅输入 RGB 图像。
学习机制核心:传统 RL 是从初始状态向前学;多样化重置让模型反向学习,从靠近目标的状态开始,逐步向外扩展,直到掌握整个工作空间。课程不是调度出来的,而是重置状态分布本身带来的。即便不复用代码,这个思路也极具借鉴价值。
“涌现能力” 的实际含义,不是空泛概念,对应具体行为
-
非预抓取策略,例如直接利用孔洞本身定位,调整销钉姿态; -
受到扰动时稳健重试; -
在没有任务先验知识的前提下,把多个子技能拼接成长时序行为; -
初始条件覆盖范围是对比基线(基于演示的课程学习)的 300 倍以上,包含基线完全无法求解的工作空间边缘初始状态。
训练任务实例:桌腿拧螺丝装配、抽屉装配、销钉插空、墙上摆正矩形物体、方块堆叠、“生日派对任务” 把纸杯蛋糕放到盘子上。评测分为简单模式(受限初始化)、困难模式(完整工作空间随机初始化)。
值得关注的真实硬件实验结果
基于 8 万条仿真轨迹训练得到 RGB 蒸馏策略,零样本部署到真实硬件:
-
销钉插入:85.37% 成功率 -
桌腿拧螺丝:56.36% 成功率 -
抽屉插入:15.38% 成功率
作为对比,基于 100 条演示数据训练的行为克隆 Diffusion Policy 基线,以上任务综合成功率大约只有 2%。
抽屉装配的结果很有现实意义:OmniReset 并没有彻底解决装配任务。但它第一次把高难度初始化分布纳入可研究的范畴。
和栗壳机器人观点的对照
OmniReset 并没有解决乔・董提出的接触测量上限问题;蒸馏得到的策略只使用 RGB 图像,触觉不在回路内;部署的机器人也不是搭载孪生采集手套的 18 自由度触觉机械手。
OmniReset 解决的是 “缺失的不是智能,而是数据” 的另一半问题:回放缓存中是否包含足够多样的系统状态。如果重置分布本身就不包含防止销钉打滑的手内重抓取状态,哪怕 GPT‑6 规划能力再强,也无法调用从未被优化过的技能。
两套思路结合的价值:
栗壳机器人:后训练数据必须和部署机械手原生匹配,零重映射。 OmniReset:训练状态必须包含大量成功附近的接触状态,否则算力再高也是浪费。
如果做一个栗壳风格的 OmniReset 版本,就不再是 RGB 图像上跑 PPO,而是在 Aero 机械手的 URDF 模型上采样多样化重置状态,使用和 UMI 采集设备完全一致的三轴触觉通道;得到的涌现策略直接适配实体机械手。这篇论文尚且还不存在,但会是极具竞争力的后续工作。
需要认清局限:64000 并行仿真环境算力开销巨大,小实验室很难负担;需要能够指定目标姿态;仿真到现实迁移高度依赖视觉随机化,而不是真实接触物理的对齐;该方案也并不打算替代人类视频预训练,只是替代传统的窄范围强化学习。
第三部分・Bench2Dex:这份基准终于承认不同机械手之间不能直接互相替代
论文《Bench2Dex:跨多种灵巧手的视觉‑触觉双手操作评测基准》,杨、张、张等人;通讯作者贾晓松、严俊驰。上海交通大学、复旦大学、香港大学、启元机器人、中关村实验室、COWARobot、南洋理工大学,arXiv:2609.15726,2026‑09‑14。项目主页:bench2dex.github.io
如果说 OmniReset 解决同一实体形态下如何生成灵巧行为,Bench2Dex 直面的现实:不能把 A 机械手策略的结果,直接当成 B 机械手的性能结果。
开篇提出的问题,和董对手套的批判属于同一逻辑,针对仿真领域:
-
触觉硬件尚未形成行业统一方案; -
不同机械手的手指结构、接触表面、传感器布局各不相同; -
仿真触觉依旧和真实硬件传感器存在差距。
因此想要开展跨机械手的视觉‑触觉算法研究,首先必须统一观测数据格式。
项目具体实现
-
包含 12 套机械臂‑灵巧手实体模型,手指数量、手掌几何、腕部结构、运动学参数各不相同。 -
26 个长时序双手任务:工具使用、带铰接结构物体、多阶段日常操作。典型示例是微波炉四步任务:开门、把法棍放进碗、把碗放进微波炉、关门。其余任务包含酒杯托盘平衡、拼图装配。 -
在 26 种【任务‑机械手】组合下采集约 1300 条人类遥操作演示。 -
基于英伟达 Isaac Lab / Isaac Sim 搭建。 -
每条片段同步保存 8 种对齐模态,存储为 HDF5 格式:RGB、深度图、关节与物体状态、视觉触觉图像、2D/3D 包围盒、占据栅格、指令动作、单步观测。
统一触觉接口(容易被误用的部分)
作者并不声称可以完美模拟 GelSight、DIGIT 或者任意一款真实触觉传感器。该基准将局部接触几何转换为类图像触觉观测:每个触觉点位每一帧输出一张 8 比特触觉图像。 底层物理量是光线投射得到的接触距离:
-
距离小于 0.5 毫米:量化精度 0.005 毫米每档位; -
距离大于 0.5 毫米:量化精度 0.03 毫米每档位; -
8 比特数值饱和上限约 5.15 毫米。
最终输出经过高斯平滑得到触觉图像。
这是一套通用交换格式,并不是真实触觉传感器的数字孪生。作者明确说明:仿真触觉不能替代真实触觉硬件;在硬件方案尚未收敛的阶段,该基准用于算法开发。任何人把 Bench2Dex 解读为 “仿真触觉问题已经解决”,都是误读论文。
遥操作链路,也是董会提出质疑的地方
采集端:Manus 手套(25 节点手部骨骼)+ ARKit 腕部数据流。 重映射链路:骨骼关键点转为 21 个 MediaPipe 格式关键点,再通过 DexPilot 求解手部关节,Pinocchio 逆运动学求解机械臂。
同一套人类操作接口驱动 12 套完全不同的机械手,每一次都要做重映射。 这正是董幻灯片上红色标记的环节:接触信息在此丢失。Bench2Dex 对此完全坦诚:为了让同一个人可以驱动 12 种不同形态机械手,代价就是 1300 条演示全部经过重映射。这些数据适合研究跨机械手泛化策略,不适合用来获得原生真实接触标签。
这不代表项目没有价值。栗壳机器人和 Bench2Dex 是互补而非竞争:Bench2Dex 衡量视觉‑触觉算法能否扛过实体形态变化;而栗壳机器人的后训练数据集从根源上避免实体形态发生变化。
有望成为行业标准的评测设计
任务成功不能只看视频画面看起来完成。
- 稳定成功率
目标状态必须维持一段时间,默认 0.5 秒驻留时间; - 锁止阶段完成率
满足依赖关系的子里程碑,达成并且维持,即便后续被扰动也认定该阶段完成。不会出现四步微波炉任务完成三步就直接记为 0 分; - 效率指标
达成稳定成功的平均耗时; - 安全指标
安全成功率、严重违规率、物体掉落率,高速运行代理指标; - 面向接触任务补充指标
运动学抓取稳定性指数。
泛化能力做明确区分,而不是笼统描述为 “场景随机化”:
- 不变轴
正确动作不应改变的维度:背景、桌面纹理、光照、干扰物体、相机位姿; - 等变轴
正确动作需要随之改变的维度:物体位姿、桌面高度、工作空间几何。
四类评测通道:无扰动(和参考场景完全一致回放)、等变扰动、不变扰动、全扰动(完全独立场景采样,没有参考锚点)。这套划分可以区分策略究竟只是对纹理不变,还是真正理解物体位姿。
基线实验数据
完整评测共计 20800 次仿真运行:26 个任务‑机械手组合,每个 50 片段,4 种通道,4 种策略。 在无扰动通道,每个策略 1300 片段条件下结果:
-
GR00T N1.5:631 次成功,48.5%; -
ACT:383 次成功,29.5%; -
π0.5:355 次成功,27.3%; -
Diffusion Policy:168 次成功,12.9%。
ACT、Diffusion Policy 在 Bench2Dex 数据集从零训练;π0.5、GR00T N1.5 基于公开权重微调。 加入全部扰动之后综合成功率出现合理下降。全扰动条件下 GR00T 整体最高,但 π0.5 在不少具体任务上表现领先。 这恰恰证明:报告结果必须分任务、分机械手。不说明使用哪一款机械手的灵巧操作实验数据,是无效结果。
站在董的视角,如何解读 Bench2Dex
-
跨机械手评测现在有公共工具,各个实验室不必从零搭建 Isaac 仿真场景; -
“触觉转图像” 是算法研究接口,不等同真实物理; -
经过重映射的遥操作会系统性低估原生接触数据的效果。因此,如果用 Bench2Dex 协议评估栗壳风格原生 UMI 数据集,必须同步做重映射对照组,但是绝大多数人会省略这个对照; -
“锁止阶段完成率”、不变 / 等变扰动通道,应当替代简单的 “50 次测试的成功率” 评测范式。
第四部分・如何评估 Jev 模型(以及为什么目前公开得分和机械手能力无关)
2026 年 9 月中旬 TypeSafe 发布的 Jev,属于0 号系统模型:它不生成大段文本,在低延迟、低成本约束下从结构化动作集合中做选择,输出保证符合模式约束。
亮眼数字,以及背后真实基础: TypeSafe 内部四项业务基准(安全事件响应、智能代理观测、发票处理、客服),Jev 达成 67.8% 匹配度;单案例成本约 0.0004 美元,耗时 0.4 秒。
独立验证数据:端到端延迟 70‑500 毫秒,输入 token 成本约 4 美元每百万 token;外部 37 份文档共计 777 条判断,全部在 0.7 秒内返回。
但是这个准确率没有人类真实真值作为参照;参考标准是 GPT‑6 Astra 与 Claude Fable 5.1 高思考模式输出结果的平均值。Jev “准确率” 只是和前沿大模型输出的一致性,不等于客观正确性。 TypeSafe 团队也承认:测试工作流由自家能力评估团队搭建,存在引入偏见的可能性。
宣传的 “快 193 倍,便宜 444 倍” 是和最慢最贵基线对比;和同级 Terra 系列模型对比,优势缩小至约快 25 倍、便宜 76 倍;依然可观,但不是宣传标题的量级。
校准效果只有口头断言,没有校准曲线、可靠性图;域迁移条件下性能没有测量。难度更高的发票任务 Jev 得分 61.8%,而 Terra 达到 74.7%。
这只是办公业务评测,真值来自模型打分。几乎不能证明 Jev 可以胜任董所说的 0 号系统精细操作层。
目前公开机器人相关实验规模很小,高度依赖外部封装环境,很容易被过度解读:
-
openroboto‑ai/jev‑robot‑control:MuJoCo 仿真 xArm7 机械臂,任务只有把苹果放到盘子;笛卡尔直接控制 + 夹爪;仅零号随机种子单次实验。Jev1.13 完成放置消耗 113 控制周期,开销约 1.9 美分,墙钟时间 182 秒,仿真时长 36 秒。GPT‑6 Astra 低推理模式 106 周期完成,开销 5.93 美元,墙钟 707 秒,仿真 34 秒。GPT‑4.1 mini 达到 160 周期上限失败。Jev 开销大约是 Astra 的 1/315,墙钟耗时约 1/4;Astra 控制周期略少。这不是成功率评估,仅仅是三次运行记录。 -
MindStudio 仿真机械臂演示:当封装环境已经提供精确几何、触觉、可用控制、预测效果、上一步动作结果时,Jev 可以把红色方块放入对应孔洞。这是在 0 号系统问题已经被外部解决的前提下运行,并不是从零处理感知输入。 -
Minecraft、开放式计算机使用样例,暴露出另一面:缺少上层规划器,Jev 会陷入循环,反复挖坑、批量合成工作台。
完全契合董提出的架构:Jev 适合做快速电机动作选择,搭配 Astra 负责长时序规划。规划层被大模型吸纳,0 号精细操作层还没有。
真正用来评估 Jev 机械手能力的实验协议
想要证明 “Jev 可以作为 0 号系统控制器”,封装环境不能像发票路由任务,要对标 Aero UMI 与 Aero 机械手的硬件条件。
- 固定本体模型
锁定一套 URDF;优先选用采集手套和机械手 1:1 匹配的硬件(栗壳的原则)。跨机械手结果需要放到 Bench2Dex 表格中单独列出。 - 固定观测输入契约
0 号系统最低输入集合:本体感知、手掌‑手内三轴触觉、可选腕部相机、带统一时间戳的接触事件。如果直接向 Jev 输入物体真实位姿,就不再测试 0 号系统,而是给规划器开物理外挂。 - 分层消融实验
分别报告:仅 Jev 负责接触闭环(抓取稳定、打滑恢复、插入力控制);Astra/Gemini 做规划 + Jev 作为 0 号系统;仅 Astra 整套策略。要区分混合架构的性能提升究竟来自规划器还是底层控制器。 - 使用 Bench2Dex 完整评测维度,拒绝单一成功率指标
区分不变 / 等变扰动;带驻留时间的稳定成功率;多任务锁止阶段完成率;安全指标(掉落、硬碰撞、速度);抓取稳定性等接触相关诊断指标。“把苹果放到盘子” 只能作为玩具演示。 - 报告 Jev 被宣传的核心稀缺资源指标
墙钟时间、仿真时间、控制周期数量、token 开销 / API 花费、时间抖动。一个办公任务 0.4 秒响应的模型,遇到触觉尖峰卡顿 800 毫秒,就不适合作为 0 号系统。 - 不能只跑一个随机种子就对外发布
。公开 Jev 对比 Astra 的表格只用了 seed‑0。至少 20 组不同随机种子,场景生成器、动作模式、超时条件全部统一。成本排名会随着服务商定价变化;成功率会被接触噪声改变。 - 消融特权输入通道
触觉开启 / 关闭;重建图像 / 原始图像;物体真值位姿开启 / 关闭。复用栗壳产品发布时的消融协议。如果把几何真值隐藏,只保留触觉单元和关节数据,Jev 优势直接消失,则 Jev 只是廉价规划器,而不是接触控制器。
在完成这套实验之前,“Jev 机器人能力到底如何” 还是尚未回答的科学问题,市面上只有营销宣传。
第五部分・GPT‑6 Astra、计算机使用能力,为什么 real2sim2real 会成为下一个规模化方向
董的展望幻灯片已经把 GPT‑6 归类到规划层。一个值得重视的点,并不是 “Astra 可以遥控 YAM 机械臂”,而是:
具备计算机使用能力的 GPT‑6 Astra,可以直接生成 OmniReset 训练所需要的仿真环境。
Astra 现有能力(附带限制条件)
2026 年 9 月公开的具身评测参差不齐,高度依赖封装环境,距离人类遥操作差距仍然很大。不同实验结果差距巨大,这本身就是关键信息:
-
Robocurve / Inspect Robots,双臂 I2RT YAM 机械臂,20 次实验:把红色方块放入碗中,Astra 19/20(95%);Fable5.1 8/20(40%);Fable5 仅 1/20,token 与开销更低。拼块入槽任务 Astra 与 Fable5.1 都只有 2/20。简单任务优势明显;高精度接触任务仍未解决。 -
StationeryBench(同一平台难度更高),五项双臂文具任务,每项 100 次实验:Astra 总共 7/100 完成;MolmoAct2 全部失败。平均进度得分 Astra46 分,对比基线 12 分(满分 100)。分项:拧开马克笔 5/20;空中尺子交接 1/20;抽取中间便利贴 1/20;回形针倒入抬高的碗、开盒‑取橡皮‑关盒两项任务全部 0/20。单次实验开销约 1.21‑1.93 美元。这是 Astra 讨论中最有现实意义、却极少被引用的数据。 -
Pantograph Pandroid 移动双臂机器人,8 项任务,160 次 rollout:Astra36%,Fable5.1 15%,统计显著;遥操作仍然 100%。 -
MolmoSpaces‑v1 子集,200 片段:Astra70.5%;Cosmos3 53%;MolmoAct‑2 38.6%;π0.5‑OSS34.5%。 -
RoboLab,10 个单臂任务:有报告直接使用 Astra 达到 49/50;RoboDojo 双臂任务直接运行 Astra 仅 26%;搭配 π0.5 混合方案提升至 48%,GPT 仅在 14.4% 控制步介入纠错。
要同时看待 95% 和 7% 这两组数字,这是同一个模型跑在同一个机器人上得到的结果。规律跨多个实验室得到复现:长时序语义规划能力已经被大模型吸收;高度依赖接触的精细操作还没有。这正是董那张展望幻灯片给出的实测印证。只引用 95% 成功率,属于挑选任务展示效果。
被低估的方向:把计算机使用能力当做仿真编译器
real2sim2real(真实‑仿真‑真实)长期属于小众研究,因为搭建仿真环境需要大量图形、美术资产开发工作。拥有计算机使用能力的前沿大模型改变瓶颈:
-
观察真实采集片段(UMI 输出视频 + 触觉 + 关节,甚至普通手机视频); -
调用桌面软件:打开 Isaac/MuJoCo/USD 编辑器,摆放资产,设置质量,编写重置采样器,配置奖励函数,输出和机械手匹配的 URDF 文件; -
自动生成 OmniReset 四类重置分布(接近目标、已抓取、靠近物体、到达),不需要研究员逐条手动编写; -
在 64k 并行环境大规模运行 PPO 或者世界模型推演; -
把策略蒸馏回真实机械手。
这就是字面意义上的真实‑仿真‑真实闭环:真实演示定义任务,大模型构建仿真环境,在仿真中大规模训练,策略回到同一个几何本体的真实硬件。
相比又一个 VLA 模型权重,这条路线潜力巨大的原因:
-
OmniReset 已经证明只要重置状态覆盖足够,增加并行环境就可以持续提升行为能力;真正稀缺的不是 PPO 代码,而是重置分布与场景的定义。 -
Astra 级别的模型已经可以操作 IDE、浏览器、文件系统。搭建厨房 USD 场景、写重置脚本,属于计算机使用任务,不属于底层运动控制,恰好落在已经被大模型吸纳的那一层。
闭环内部依然必须遵守栗壳机器人的约束:如果仿真机械手和真实机械手不一致,就回到重映射问题,接触信息被损耗。大模型生成仿真环境,必须使用 Aero 机械手的 URDF,而不是通用 Allegro 机械手。
Bench2Dex 就作为生成仿真环境的单元测试套件:必须满足驻留时间稳定成功率、不变‑等变扰动评测;如果机械手形态处理马虎,就触发 12 种机械手的性能告警。
预期会遇到的失败模式:Astra 生成的场景视觉上看着合理,但接触物理错误;物体质量偏差三倍、摩擦系数导致销钉 “粘死”;触觉图像和三轴 UMI 采集设备覆盖范围不匹配。StationeryBench 已经看到这类失败:倒回形针 0/20 不是规划问题,是接触物理问题。因此,栗壳那套消融实验(触觉开关、重建图像 vs 原始图像),必须放在仿真生成步骤之后,而不能被仿真生成环节替代。
real2sim2real 想要真正成为主流,前提是生成的仿真环境是忠于测量数据的数字孪生,而不是一个画面好看的游戏。刚性、URDF 匹配的数据采集手套,是判断孪生仿真是否可信的前提;多样化重置是使用孪生仿真的手段;带计算机使用能力的 Astra,让我们可以产出远超博士生人力数量的孪生仿真环境。
第六部分・后记:经典方案的经验遗产
托尼・普拉卡尼斯在机器人中心分享 ICRA2013 的 PR2 机器人买咖啡项目报告 ——《替代办公室实习生》(普拉卡尼斯、利珀、索尔兹伯里)。
整套系统没有 GPU。全部运算运行在两台四核服务器,每台 24GB 内存。放到今天,一台小型迷你主机就可以完成。算法从来不是受限于 4090 显卡。
柔顺特性来自机械结构,不是学习得到。单臂 1.5 千克,配重平衡搭配高减速比齿轮。依靠这套机械设计,机械臂就可以触碰门、碰到行人,不需要力‑力矩大模型。
任务计划是直接写代码,不是模型推导。Willow Garage 团队拥有 T‑REX 符号世界模型的时序反应执行器,但他们刻意没有使用。而是直接写脚本,模拟任务规划器输出序列:导航、拿起袋子、袋子换钱、导航、排队、拿钱换咖啡、返回、放下。团队整个夏天的工作集中在地图、门、电梯、物体交接逻辑,而不是 “让模型写计划”。
物体交接逻辑不需要视觉:递出物体:伸出机械臂,等待,当机械臂偏转足够就释放;接过物体:等待,当腕部相机画面发生大幅变化,或者人推机械臂,就执行抓取;之后检测夹爪是否闭合到稳定位置,如果失败,整套流程重试。故障检测 + 重试就是可靠性来源,而不是更优秀的检测算法。
世界模型是允许手动修改栅格地图。地图由人工遥控机器人录制,运行时不再改动;定位只依赖静态地图融合里程计;门手动标注;偶尔直接像修图片一样编辑地图。实践经验:建筑物没有翻新,地图就不会失效,不需要持续重建地图。
代价地图作为数字孪生:静态地图加上来自地面、倾斜激光雷达的动态障碍物;障碍物向外膨胀机器人半径,规划器把机器人当做质点;膨胀区外设置部分代价值,让路径自动远离墙体。
光线投射逻辑保障地图持久性。激光雷达返回两个信息:该端点有障碍物;射线路径全部无遮挡。只写入障碍物端点:行人走过就会在地图上留下一堵虚拟墙;清理过于激进,又会遗忘已经被挡住的通道,机器人循环。正确做法:标记命中点障碍物,沿着激光射线清除中间栅格。
最优路径和平滑轨迹分属两个模块。全局 A * 规划 1Hz 运行,严格最短路径,附带故障恢复,处理目标落在障碍物内、目标不可达;输出栅格化折线路径。局部规划器在同一份代价地图上做短周期动力学仿真采样轨迹;靠近障碍物就减速保证可以急停;经典控制器以 1000Hz 频率跟踪轨迹。三层时间尺度,两套机器人模型。
多层楼层处理方式:多张 2D 地图构建图网络,Dijkstra 算法跨图寻路;门、电梯作为图边上的插件动作。这套实现最终发布为 multi_map_navigation 导航包。
安全策略: clearance‑to‑speed 距离‑速度规则 + 机械屈服结构。不是依靠学习得到碰撞预测器。
通向 2026 的启示:当年开发 ROS v1 测试基础设施、这套 PR2 咖啡系统的工程师,后续为 PaLM‑E 搭建云机器人底层,如今正在为前沿物理 AI 做软硬件打包。没有整套系统被彻底替换,而是一层层往下复用。买咖啡项目证明:当建筑、电梯、真实路人出现在现实环境,底层基础模块依然必须可靠。
第七部分・整套技术栈重新梳理
- 预训练仍然建立在视频之上
世界模型摄入第一视角视频;VLA 摄入厘米级精度推理动作。Physical Intelligence、GEAR/EgoScale 已经验证这一层方案,不再重复铺垫。 - 相机永远记录不到完成抓取的关键信息
被遮挡、无法测量。力不是像素。引用四相机实验无标记追踪存在 10.9° 关节误差。再好的重建,不能还原从未记录的数据。 - 接触数据是补充,不是替代
视频带来广度,接触测量带来精度。 - 软性手套根源缺陷:漂移、形变、基底噪声。刚性连杆让表面位姿由运动学确定;触觉传感器只报告刚性表面上接触点。接触通过计算得到。ART‑Glove 是已发表验证;栗壳 Aero‑UMI 实现 18 自由度、0.1° 读数、三轴触觉、1:1 机械手匹配。
- 取舍代价:牺牲部分活动自由度,换取可信测量。覆盖范围、自由度、适配、舒适度四者相互制衡;产品追求平衡点,而不是单一指标最大化。
- 重映射会偷走接触信息。后训练数据集必须原生采集,零重映射。先设计采集设备,再衍生机械手。一套动作,三套实体载体,中间无转换。DexUMI 式叠加渲染,搭配标定、仿真、多阶段图像修复 —— 因为位姿已经预先确知。
- 演示链路性能取决于最薄弱环节:佩戴适配、三项不同维度精度、逐关节标定、统一时钟时序。
- 验证效果依靠完整实验协议,不是宣传视频。Diffusion Policy 作为基准学生模型;做触觉开关、重建图像对比原始图像消融;最终效果随硬件产品发布。
- 规划层被 GPT‑6、Gemini、PI 吸纳;0 号精细操作层没有。短板不是智能,而是高质量数据。
- OmniReset 解决仿真中缺失状态生成:四类重置分布,64k 环境 PPO,RGB 蒸馏;初始条件覆盖提升 300 倍;真实硬件销钉插入 85%,拧腿 56%,抽屉装配 15%。
- Bench2Dex 纠正机械手评测误区:12 套实体、26 个双手任务、1300 条经过重映射的遥操作演示;几何生成触觉图像;稳定成功率、锁止阶段完成率、不变‑等变扰动通道。无扰动条件 GR00T N1.5 达到 48.5%,但这不等于触觉方案的胜利。
- Jev 想要成为 0 号系统控制器,前提是固定 URDF、完整触觉观测、混合‑单独消融实验、多随机种子、Bench2Dex 全套评测指标。目前宣传准确率只是和两大前沿模型输出做比对,不存在人类真值;现有少量仿真样例不足以下结论。
- Astra 加上计算机使用能力,可以生成 OmniReset 训练所需要的仿真环境,这才是 real2sim2real 真正的规模化故事;前提是生成仿真的几何,必须和采集真实片段的手套‑机械手保持一致。同时要同时看待 Astra95% 高成功率与 7% 低完成率,两者来自同一个模型。
最优的手套应当是刚性的,因为高质量后训练数据集来自计算,而不是重建。其余所有技术,包括多样化重置、跨机械手基准、0 号系统控制器、可以自建仿真的前沿规划大模型,全部建立在一个前提之上:你是否真正测量到了你想要模型学习的接触信息。
机器人第 29 期读书会,2026‑09‑19。 报告人:乔・董(栗壳机器人);托尼・普拉卡尼斯(机器人中心)。 讨论论文:OmniReset(ICLR2026 arXiv:2603.15789);Bench2Dex(arXiv:2609.15726);DexUMI(CoRL2025);Diffusion Policy(RSS2023);ART‑Glove(arXiv:2606.16370);Maggioni 等人 Sensors 25:1079(2025)