


围绕 B300 的讨论,往往从现货价格和交付周期开始。但要理解企业为什么愿意为新一代芯片付费,需要先分清两个问题:供需紧张可以带来价格溢价,硬件升级则决定它能完成什么任务,以及完成任务的效率。
本文选取 NVIDIA 的 H100、H200、B200、B300,以及 AMD 的 MI355X,从显存容量、显存带宽和计算能力三个维度,解释这些芯片的性能差异。
先看它们的发布时间与核心参数。这几款产品横跨数年,既有同一架构的升级,也有架构换代;比较时,需要统一配置、计算精度和统计口径。
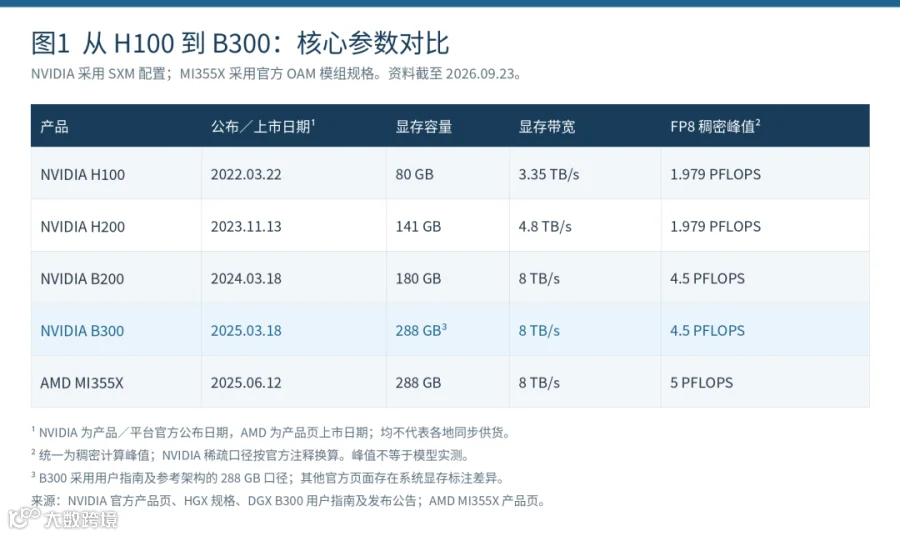
图中发布日期来自官方公告或产品页,不代表所有地区同步供货。计算能力统一采用FP8稠密峰值,避免将不同统计口径直接比较。
其中,B300的288GB采用官方用户指南与参考架构口径,部分官方营销页面存在不同系统显存标注,具体设备应核对配置
1
显存容量
首先决定模型和缓存能放下多少
一部标注“12GB+256GB”的手机,12GB是运行内存,256GB是存储空间。GPU显存承担的角色更接近运行内存,要容纳计算过程中使用的模型数据。
以12GB手机运行内存为参照,H100的80GB约相当于6.7部手机的容量,B300的288GB相当于24部。这个比较只说明容量差异,不代表这些手机组合起来能获得相同的计算能力。
更有业务意义的例子,是一个700亿参数模型的部署。按照BF16格式,每个参数占两个字节,仅模型权重就约需:
700亿 × 2字节=140GB
把这140GB放到不同芯片上,显存容量带来的区别就很直观。

H100的80GB无法让全部权重同时驻留在单卡显存;H200的141GB扣除权重后,账面上仅剩1GB;B300和MI355X的288GB则留下了148GB的账面空间。
这只是简化容量测算,未计入缓存、临时工作区及其他运行开销,不能据此保证单卡可运行。采用量化或其他部署方式后,需求也会变化。
显存扩大,有机会减少模型跨卡切分,也有机会容纳更多并发请求需要的缓存。因此,显存增加带来的价值,可能同时体现在部署方式和服务能力上。
但容量充足,只解决了其中一个问题。
2
H100的显存带宽为3.35TB/s,H200为4.8TB/s,提高约43%;B200和B300均为8TB/s,约为H100的2.39倍。
如果把256GB视为一部手机存满的数据量,单纯换算数据规模,3.35TB/s约相当于每秒搬运13部手机的数据,8TB/s约相当于31部。
这个类比描述的是GPU内部显存访问的理论带宽,不能当作手机实际拷贝速度,也不能直接换算成AI回答速度。

大模型生成输出时,需要反复读取权重和缓存,部分任务会受到数据搬运速度的限制。计算单元即使有很高的理论能力,也可能因为等待数据而无法充分发挥。
经典的Roofline性能模型指出,实际性能同时受到计算峰值与数据搬运能力的约束。这也是为什么分析芯片时,需要把算力和带宽放在一起看。
3
从参数总览可以看到,H100与H200的FP8稠密计算峰值均约为1.98 PFLOPS,B200与B300均为4.5 PFLOPS。按这一口径,B300约为H100的2.27倍,与B200相同。
这说明产品升级可以集中在不同环节,型号变化并不意味着所有指标同步提高。
B300相比B200,一个重要变化体现在FP4计算上。按官方八GPU系统规格,稠密FP4峰值由72 PFLOPS提高至108 PFLOPS,增加50%;本文采用配置的单GPU显存则从180GB增至288GB,增加60%。([www.nvidia.com][5])
低精度格式用更少的位数表示数值,可以减少部分数据的存储与搬运需求,并利用相应硬件提高计算效率。但模型能否使用这种格式,需要同时验证软件支持和输出质量。
因此,B300在更大显存和特定低精度计算方面的提升,对部分大模型任务具有实际价值;收益大小取决于任务原本受到什么限制。
AMD的MI355X提供了另一组值得比较的参数。它于2025年6月12日上市,拥有288GB显存、8TB/s带宽,以及5 PFLOPS的稠密FP8峰值。
其显存容量和带宽与本文采用的B300配置相同,FP8理论峰值则高约11%。这一差距只能描述指定计算口径,不能据此判断所有模型上的性能排名。
具体模型的表现还受到算子实现、软件版本、批量大小和多卡通信的影响。准确的横向测试,需要使用相同模型、相近质量要求和一致服务条件,观察吞吐量、响应时延以及系统功耗。
对算力业务而言,值得验证的问题是:同一个模型,在相同质量和响应时间要求下,哪套系统能够稳定完成更多任务,以及每个任务需要多少资源。
理解芯片升级,可以按这个顺序展开:先看模型能否装下,再看数据搬运和计算的瓶颈,最后用实际任务验证收益。至于现货价格是否合理,还需要另行核实配置、交期、供需与服务条件。
香港Web3金融游学汇专注AI算力与加密金融教育,致力于打造国内领先的AI+Web3产业研学与咨询服务品牌。项目链接上海交通大学、香港大学、香港科技大学等高校及一线产业机构资源,聚焦AI算力供应链与交付、稳定币、美股代币化、RWA及代币化基金,通过产业研学与业务负责人深度交流,帮助企业家及上市公司高管获取真实产业信息、建立可信合作关系,为企业战略升级、业务拓展与合规出海提供认知支持和实践参考。
