


最近一些日子老王一直更新关于AI产品相关必懂的概念,主要是为了提醒大家一件事:未来每个产品经理都将具备使用AI并用于自己产品设计的能力,基础概念的理解对后续的工作有很大的帮助,不要被时代抛弃,该学得学!
我们开始!今天讲Token!
很多人以为Token就是单词,或者一个汉字就是一个Token。这种理解在做vibecoding和AI对话时,会让你在计算成本和上下文窗口时吃大亏。因为Token根本不是文本,它是大模型理解世界的数字索引。
我们慢慢来!
1. Token的本质
Token到底是什么?
Token是大语言模型输入数据的最小单位,它本质上是一个整数索引,指向一个高维向量。
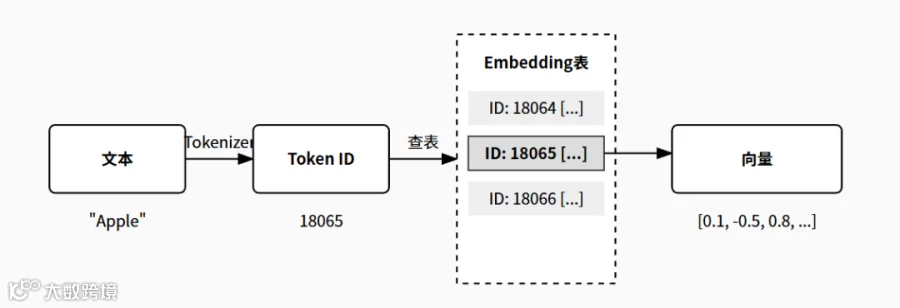
模型不认识苹果这两个字,它只认识苹果在词表里的编号。词表的英文是Vocabulary,简称Vocab。比如在GPT-4的分词器里,apple对应的ID是18065。模型看到18065,就会去查找这个ID对应的向量。这个向量包含了apple的语义信息。
这里有个误区,很多人觉得Token是切割后的字符串。完全错了。Token是查表用的ID。模型训练的时候,学习的是ID之间的概率关系;推理的时候,输出的也是ID的概率分布。
如果不理解这一点,你就无法理解为什么Prompt Engineering中微小的措辞变化会导致输出结果天差地别。因为词变了,ID就变了,索引到的向量也就变了,整个推理路径自然就变了。
深入讲一下这个过程。
当我们将一句话输入给模型时,实际上发生了三次转换。
第一步,分词器把文本切分成一个个Token ID,这叫Tokenization。
第二步,模型第一层把每个ID映射为一个高维向量,这层叫Embedding Layer,输出的向量通常有4096维,是一个稠密的数字列表,代表了该Token在语义空间中的位置。
第三步,Transformer层对这些向量进行计算,捕捉上下文关系,最终生成输出。
如果你把Token当作字符处理,就完全丢失了语义的维度。
举个实际案例。
我们在做RAG系统时,经常遇到截断问题。RAG全称是检索增强生成,核心思路是先检索相关文档,再把文档内容塞进Prompt让模型生成回答。如果你按字符数去截断文本,很可能会把一个Token切成两半,导致解码乱码或者语义丢失。
正确的做法是,必须使用模型对应的Tokenizer将文本转为ID列表,然后在ID层面进行截断,最后再解码回文本。这才是符合模型底层逻辑的处理方式。
2. 分词原理:BPE算法
那文本是怎么变成Token ID的?这就涉及到了Tokenization,也就是分词。
目前主流大模型都使用BPE算法。BPE全称是Byte Pair Encoding,中文叫字节对编码。
BPE的运行逻辑非常暴力且高效:它统计语料库中字节对出现的频率,把最常出现的字节对合并成一个新的Token,从字符级别通过不断的合并,最终构建出词表。这个过程没有语法规则,纯粹基于统计。
比如我们看unhappiness这个词。最开始,它是11个字符:u-n-h-a-p-p-i-n-e-s-s。算法发现p和p经常一起出现,合并成pp。发现h和a经常一起出现,合并成ha。通过成千上万次迭代,最终可能将其拆解为un、happi、ness三个Token,分别对应前缀、词根和后缀。
BPE的好处是压缩率高,常用词对应1个Token,生僻词对应多个Token。这就保证了词表大小是可控的,通常在3万到10万之间。
但有个事儿你得知道,中文和英文在分词上有巨大差异。
英文单词通常由词根词缀组成,BPE能很好地切分。而中文是表意文字,很多字本身就是最小语义单位。
早期的模型对中文支持不好,因为训练语料里中文很少,BPE算法学不到中文的统计规律,导致一个汉字可能被切成2到3个Token。
这些Token其实是UTF-8字节编码片段,毫无语义可言。这就导致中文推理成本极高。
现在的模型针对中文做了优化,扩大了中文词表,基本能做到一个汉字对应1个甚至更少的Token。常见词组可能就是一个Token,比如人工智能在某些模型里就是单个Token。

再看个案例。
计算API调用成本的时候,如果你简单按1个汉字等于2个Token去估算,在GPT-4上可能差不多,但在专门优化过中文的国产模型上,你可能多算了50%的钱。
真正严谨的做法,是调用模型官方的Tokenizer接口,实测一段业务文本的Token数量,算出准确的Token/Character比率,再去估算成本。这不仅关系到钱,还关系到你的Prompt是否会超出上下文限制。
3. Token数量决定了计算成本
搞懂了Token是什么和怎么来的,最后要讲讲它怎么影响性能。
为什么大模型的上下文窗口那么贵?为什么从4k扩到128k这么难?
核心原因在于Attention机制的计算复杂度。
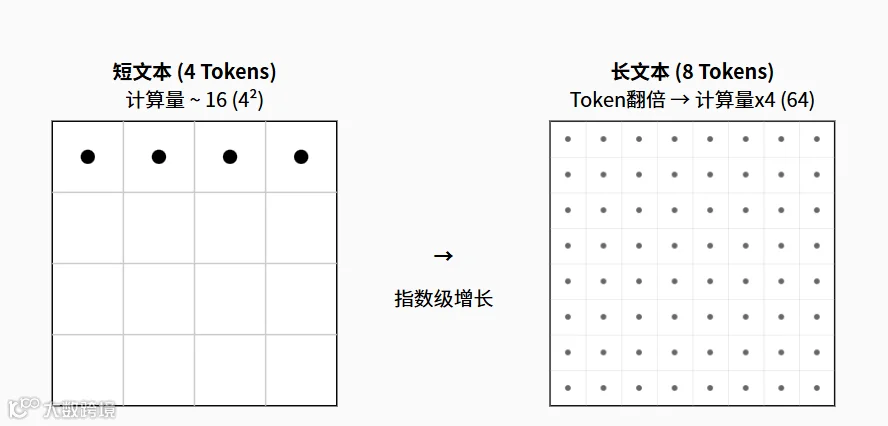
在Transformer架构中,Self-Attention机制要求每个Token都要去关注序列中的其他所有Token,以计算它们之间的相关性。Attention矩阵的大小是Token数量的平方。
这意味着,如果Token数量翻倍,计算量和显存占用不是翻倍,而是翻4倍。如果你输入10万个Token,Attention矩阵的大小就是100亿级别。
这就是为什么长文本处理极其消耗资源,也是为什么API价格通常分为Input Token和Output Token,且长文本价格往往更昂贵。老王很小的一个问题用大模型对话,一次大概1块人民币。
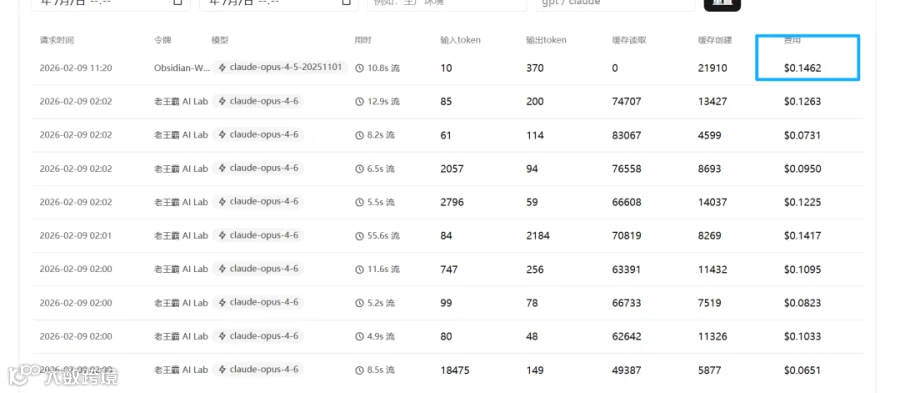
还有一个关键概念叫KV Cache。为了加速推理,模型会把之前计算过的Key和Value矩阵缓存起来。这个缓存的大小是随着Token数量线性增长的。当上下文很长时,KV Cache甚至会占满显存,导致模型内存溢出崩掉。
我在做技术选型的时候,从来不盲目追求超长上下文。
如果你的业务只需要处理5k Token的文本,用支持128k的模型不仅浪费,而且通常推理速度更慢。更要命的是,精度在长文本的首尾部分还可能下降,业界管这叫Lost in the Middle现象,就是模型对中间内容的关注度比首尾低。
我的建议是,尽量通过RAG或预处理手段,精简输入Prompt的Token数量。这不仅是省钱,更是为了提高模型的注意力密度,让它聚焦在真正关键的信息上。
写到最后
Token是模型计算资源的度量衡。
理解Token,才能理解为什么Prompt长度有限制、为什么API按Token计费、为什么同样的内容中文和英文成本不同。
懂了原理才知道什么场景省Token、什么场景不用省。别被工具牵着走。