


大家好,我是老王。
最近沉迷做 AI 视频,一来是想让自己的口播视频更加精致,再者想做一些炸裂的动作视频。
的确,做了很多废片,因为我一直用一整段提示词当参考,这等于把一大堆东西一起塞给模型。
人物长什么样、穿什么衣服,场景是什么色调、光从哪边打过来,背景音乐踩的什么节奏,多个人在什么位置,怎么动的,镜头怎么走的。
模型肯定是分不清的。
直至我用了 LibTV 以后,豁然开朗了,看看我的成龙动作打片。
这段视频,主要用 LibTV 的深度动作捕捉能力,复刻原视频动作,再转成白模后,输入提示词,直接是完美复刻动作,非常爽。
接下来,我带着大家实测梳理一下,这两类视频制作方法,必须给你省下一大笔费用。
LibTV 的深度动作捕捉,是把画面里跟动作无关的信息全部剥掉,只留一套带深度的空间骨架的白模,再让模型照着这个骨架去演一遍。
白模是一套没有任何材质贴图的三维灰模。人物是胶囊体和方块,场景是简单几何体,不打光,不上色,不贴图。
画面上剩下的只有三样:
-
人物在空间里的位置 -
人物的运动轨迹 -
机位的运动轨迹
参考越干净,模型要猜的部分就越少,抽卡次数自然往下掉。这不是什么玄学,就是信息量的问题。
这次老王测了 3 段动作戏,非常刺激,分别是只狼 boss 战,成龙打斗视频,还有蔡徐坤的多人舞蹈。
先说第一个。
经典战斗复刻
第一段用的是只狼的实机录屏,玩家跟苇名一心缠斗,弹反、踩刀。要做的事是,把这段动作和机位原样保留,替换新的角色。
流程很简单,选中参考视频,走一遍深度动作捕捉
画布上选中刚传上来的那段录屏,点开逐帧拉片的下拉菜单,在里面选深度动作捕捉。

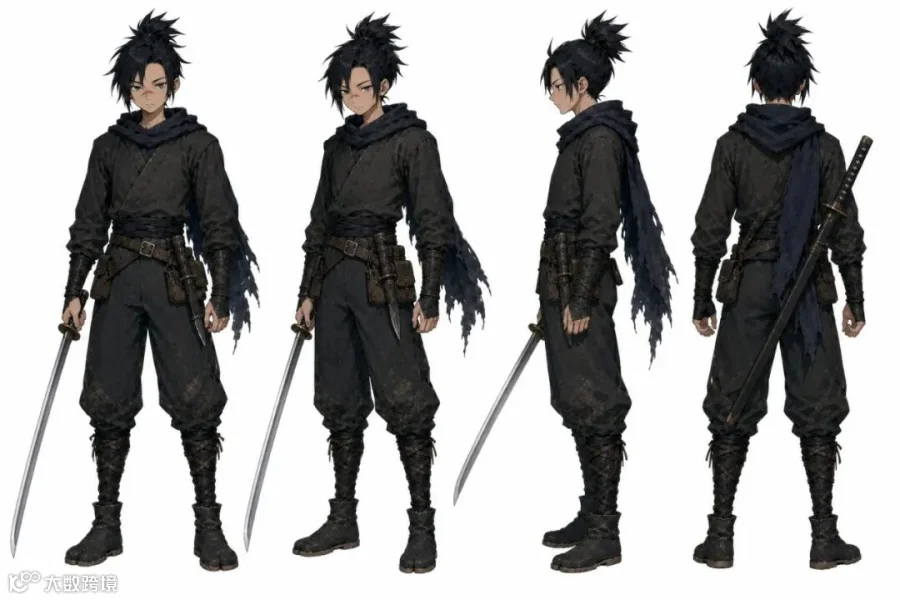
出来的白模视频是,两个灰扑扑的小人,没有贴图没有光影,只有位置和动作。原片里的铠甲、血条、调色、BGM,在这一步全被扔掉了。使用的角色素材如下。
进攻方:
Boss:

接下来,在画布上新建图片节点,上传 2 张角色素材图。
然后建一个视频节点,把刚才那个深度参考节点、人物图、场景图一起连上去,搞定。
后续不用管动作了,两张人物素材图会照着白模里那两个小人的走位,去演,弹反、踩刀、处决等动作。
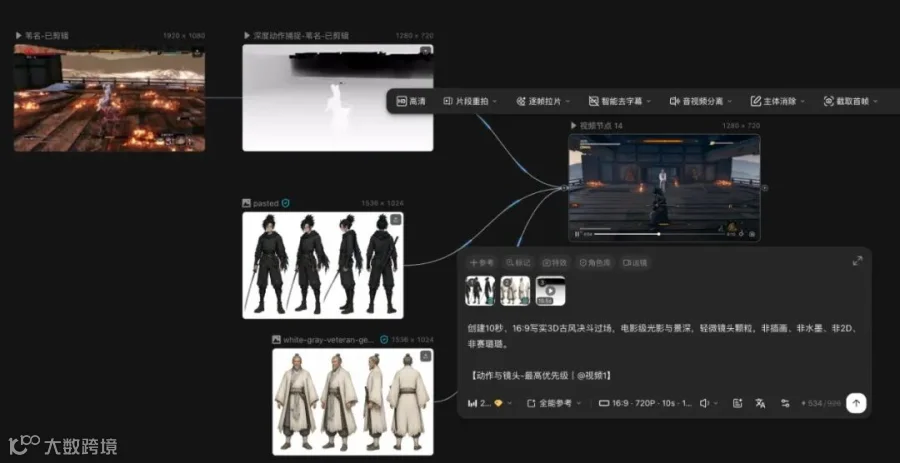
提示词这么写。
创建10秒、16:9写实3D古风决斗过场,电影级光影与景深,轻微镜头颗粒,非插画、非水墨、非2D、非赛璐璐。
【动作与镜头-最高优先级|@视频1】
严格以@视频1(画布上方「深度动作捕捉」节点,约10.5秒)作为时间线、镜头构图和全部战斗动作的唯一基准。人物站位、走位、挥剑轨迹、格挡节奏、对峙停顿、踏刃跃起、收尾段落须完全复刻,不增删动作,不改顺序,不自行编排招式,不切换镜头,不改变机位角度与运动速度。
不得引用画布左上角成片预览视频,仅以@视频1为准。
【角色绑定-按@视频1空间位置|@图片1 @图片2】
@视频1中前景、背对镜头、体型较小的灰模 = @图片1(画布中间「pasted」角色三视图):青年剑客,发髻,深蓝围巾,深色劲装与护胫,单臂或机关臂,右手持刃,精悍体型。
@视频1中中景、面向镜头、体型略大的灰模 = @图片2(画布下方「white-gray-veteran」角色三视图):花白发髻、灰白长须,白灰长袍,深色腰带,持长刃,比@图片1仅高约一头,不得巨化。
全程两人同框缠斗,不得只剩一人,不得特征混合或互换;机关臂/单臂仅属@图片1,@图片2不得有义手。
【环境-跟随@视频1空间,无单独环境图】
场景为开放式木质地台决斗场:深色磨损木板地面,低矮木质围栏,围栏外远山薄雾,暮色阴天冷色天光;地面局部橘黄火光跳动,火星向上飘升,暖光映在木板与人物身上。空间结构、围栏位置、地面范围与镜头构图严格跟随@视频1,建筑与栏杆刚性稳定,不得弯曲、融化或消失。
【连贯性-极高优先级】
双角色面部、体型、服饰、武器全程一致;脚步落地、重心转移、挥剑惯性符合真实物理;火光与火星不遮挡面部与刀路。
【战斗特效-叠加在@视频1节奏上,不遮挡动作】
刃击交击点短促金橙细火花,一闪即灭,无气浪无冲击波。
对峙弹开瞬间火花略亮,由@图片1角色完成,@图片2被推开,不得互换。
踏地跃起时靴底扬起木屑与细尘,火星微溅,无脚下光圈。
收尾命中短促血雾后落下,不遮轮廓。
禁止大面积运动模糊、尘土遮脸、人物糊成一团。
【保持原始镜头构图】
完全跟随@视频1的过肩视角、景别与运动,提示词中不写任何运镜描述。
【避免】
肢体缺失、面部变形、穿模、漂浮、瞬移、动作篡改、角色互换、体型失控、镜头切换、UI、血条、锁定标记、道具栏、字幕、水印。
▲ 上下滑动查看全文
看一下成片
弹反那一下的停顿、踩刀那一下的机位下压、处决前一帧的静止,全都复刻成功了,而且节奏跟原片对得上的。
两个人从头到尾没糊在一起,换成水墨风也没把动作带歪了,牛笔!!!
白模只管动作和走位,管不到细节的。刀刃相击的火星、衣摆的飘动,这些还得靠提示词补的,老王来回试了几版提示词,才把火星加上去。
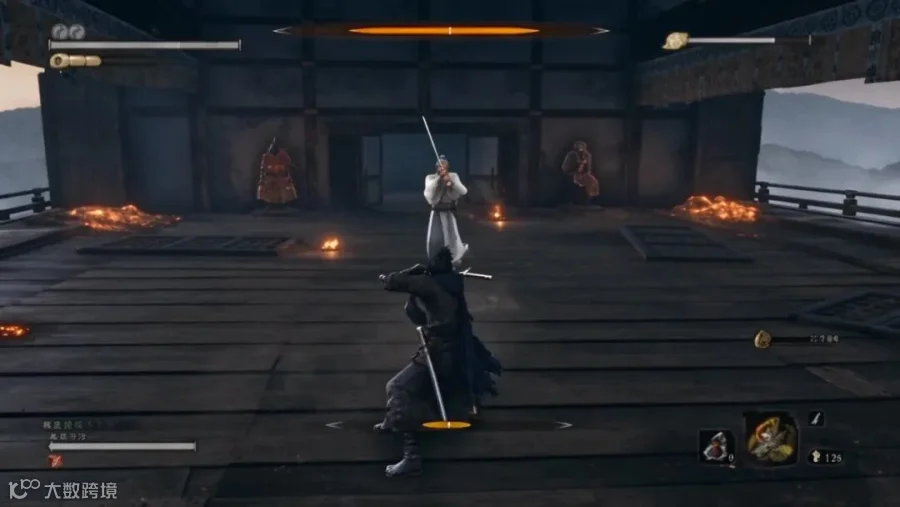
我们换一个更加复杂打斗场景,使用成龙的功夫电影进行模拟。
角色 1:

角色 2:

仍然使用深度动作提取功能,最终我们看一下成品视频,
用相同的方法,我们在测试一下舞蹈,然后生成迈克尔杰克逊的舞蹈视频,成品看这个。
多人舞蹈复刻
第二段上点强度,搞一段蔡徐坤 old school 多人街舞的过场。
蔡徐坤是主角,画布里另外传了三张不同 IP 角色的图,分别是舞团成员乙丙丁。整段要在 10 秒里完成一个 old school 招牌动作组,从主角起手到队伍展开到齐舞卡点到定格收势。
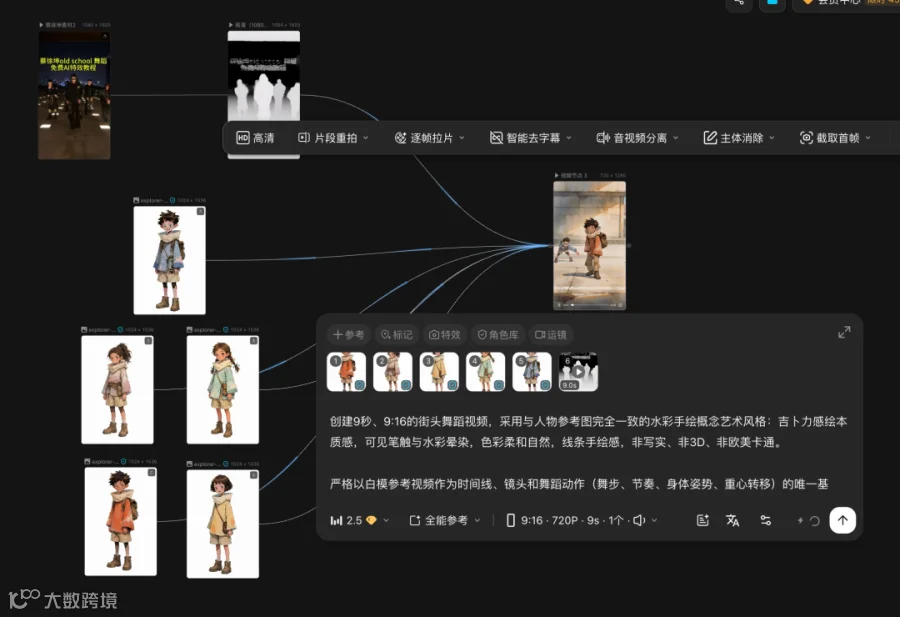
这段跟单挑最大的区别在素材分解
先把参考舞蹈视频丢进画布点深度动作捕捉,拆成分镜片段,然后按秒数跟踪人物的动作。
画布里换一段四个人的 old school 白模动作视频,命名改成 ABCD,后面智能引用要靠这个名字认人。

剩下的跟只狼那段一模一样,白模视频丢进画布,人物图连上去,写提示词,生成。
提示词这么写。
创建9秒、9:16的街头舞蹈视频,采用与人物参考图完全一致的水彩手绘概念艺术风格:吉卜力感绘本质感,可见笔触与水彩晕染,色彩柔和自然,线条手绘感,非写实、非3D、非欧美卡通。
严格以白模参考视频作为时间线、镜头和舞蹈动作(舞步、节奏、身体姿势、重心转移)的唯一基准。完全复刻,不增删改任何动作段落。运镜与构图完全由白模决定,不切镜、不跳切。
【角色绑定——外貌严格以对应参考图为准】
主角(@参考图1 / 图1):9-11岁男孩自然探险者,画面C位领舞。微卷深棕黑发,琥珀色大眼睛,雀斑,开朗笑容。超大蓬松奶油色高领围脖。铁锈橙红棕宽松连帽外套,内搭白色短袖。卡其米色短裤,白色短袜,棕色厚底系带登山靴。旧棕色皮质大背包稳定背在身后。绑定白模中领舞/中心舞者,全程为视觉焦点。
配角A(@参考图2):女孩。奶油米白连帽外套,卡其短裤,棕登山靴,棕色斜挎皮袋。绑定白模左侧舞者位。
配角B(@参考图3):女孩。芥末黄连帽外套,卡其短裤,棕登山靴,棕色斜挎皮袋。绑定白模右侧舞者位。
配角C(@参考图4):男孩。薄荷绿连帽外套,卡其短裤,棕登山靴,棕色斜挎皮袋。绑定白模后排舞者位。
配角D(@参考图5):男孩。浅天蓝连帽外套,卡其短裤,棕登山靴,棕色斜挎皮袋。绑定白模其余舞者位。
【一致性要求(极高优先级)】
全程保持主角与全体配角形象一致:面部、儿童头身比、体型、服饰颜色与参考图逐帧一致,禁止换脸、变脸、成人化、服装变色或画风漂移。水彩手绘质感、笔触风格从头到尾统一。主角背包与配角挎包稳定附着,不可脱落、消失或穿模。双手自然参与舞蹈,不额外手持道具。白模有几人就渲染几人,人数与站位全程不变。
舞蹈步伐与重心转移符合真实物理规律,脚踩实地面,无漂浮、瞬移、穿模。
保持街头背景环境刚性:城市街道、水泥路面、街边建筑、自然日光。背景几何结构稳定,禁止弯曲、融化或消失。保持原始镜头构图。
避免:欧美卡通风、3D渲染感、写实照片感、肢体多余或缺失、面部变形、五官漂移、背包穿模、背景扭曲、动作篡改、镜头切换、水印、字幕、UI元素。
▲ 上下滑动查看全文
跑完一次过。
这个白模的方法,让四个人从头到尾都没少,谁前谁后也对得上,齐舞卡点的时候队形也没乱。多人舞蹈最容易崩坏的数量和队形问题,真被白模搞定了。
老王的视频一般是口播加素材混合的形式。
A-roll 是老王本人对着镜头讲,B-roll 是生成的素材案例、产品截图、对比画面,一段一段往里加,但剪辑却不省事儿。
每一帧口播和每一段素材该怎么切,什么时候切,镜头要不要放大,节奏卡不卡得上,跟原片风格统一不统一,要一点点调。
所以真的很需要智能剪辑功能,我们今天就来实测一下 LibTV 的智能剪辑口播的能力。
这次拿老王自己一条讲 AI 视频的口播来测。口播视频 3 分钟左右,中间要插十来段案例素材。以前这种活得手动拖两小时。
口播原片丢进画布,先让 AI 把气口切干净
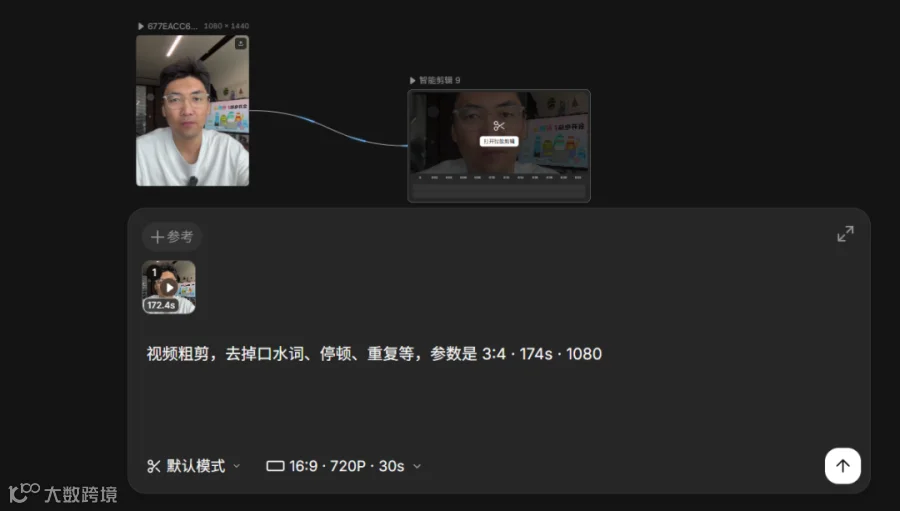
上传口播原片,先跑一遍自动粗剪。这一步只干一件事,把停顿、气口、说错的废话、重复的口癖全切掉。
先创建智能剪辑的节点,把我们的口播视频上传进去并连接到智能剪辑的节点,输入这段提示词
视频粗剪,去掉口水词、停顿、重复等,参数是 3:4 · 174s · 1080
为什么先切气口。
素材是按讲的内容去配的。嘴上还在嗯嗯啊啊,画面就已经滑到下一个案例,观众会觉得跳的。气口干净了,后面素材的进出点才好确认。
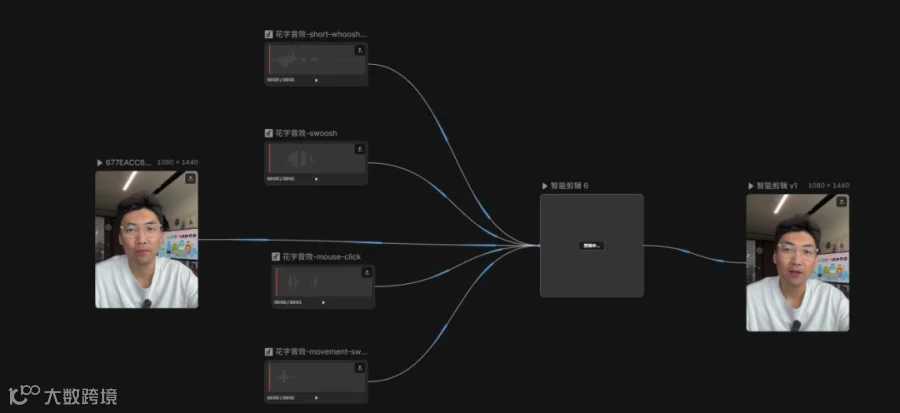
把 B-roll 素材丢进去
素材分三类:
-
操作视频 -
产品截图 -
资料视频
一条条传进画布,按讲的顺序排好。
素材不用卡秒数,进点和出点交给 AI 去对。AI 拿着第二步拆出来的内容标记,把素材一段段填进去,自动对齐。

导出前自己过一遍
自动剪完不等于能发的,我们还需去检查一下,比如素材进出点卡得对不对,有没有在半句话中间剪辑坏掉,画面和口播对不对得上,可别讲 A 功能配了 B 画面。
全部正确了,才能使用发布的。那我们简单看一部分视频的素材
不过 AI 剪辑视频最好能够给清晰给出指令,什么位置插入什么素材,如果单纯让 AI 猜,会有抽卡的可能性。
几段视频做完,老王感觉 LibTV 这次更新的能力非常强力。深度动作捕捉能力还可以把参考视频里那些跟动作无关的信息全都剥离掉,让模型不用猜了,基本可还原复杂的场景动作。也就是,AI 生视频可以做到可控性了。
智能剪辑能力,大大提高了剪辑的效率,合理的素材和口播视频,只需要简单调整,就能达到可以发布的质量。
不过,这条路没有消灭抽卡,它减少的是把不确定变成确定性了。