


阶跃星辰近日发布了 Step 5 Preview 模型。官方 Benchmark 数据显示,该模型在 Artificial Analysis Intelligence Index 中跻身全球开源模型前三。本文将深度解析其模型基本面、定价策略以及在实际场景中的落地表现。
模型基本面与“帕累托前沿”定价策略
600B参数的MoE架构选择
Step 5 Preview 采用 MoE(混合专家)架构,总参数量为 600B,激活参数 27B,支持 100 万 Token 上下文,并具备原生多模态能力。
相比于 Step-2 时期的万亿参数规模,Step 5 在参数上做了“减法”。在当前的 Scaling 逻辑下,模型容量的扩大通常能带来智能的提升,但阶跃选择 600B 并非放弃性能,而是出于对效率与成本的精准把控。
追求能力与成本的帕累托最优
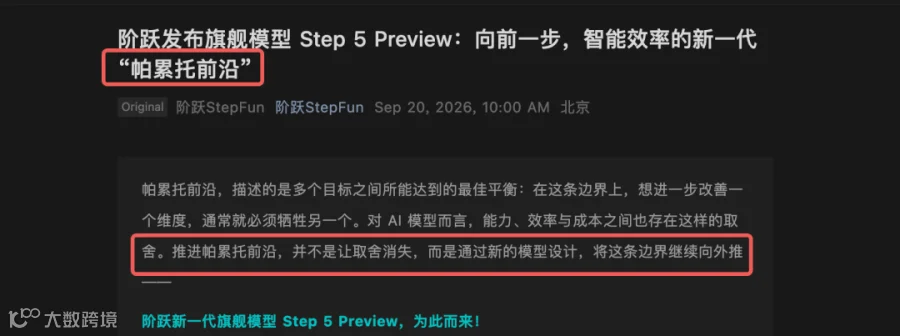
官方 Release blog 的核心关键词是“帕累托前沿”。简而言之,帕累托前沿是指在当前技术条件下,无法在不牺牲其他指标的情况下,进一步提升某一指标的最优解集合。
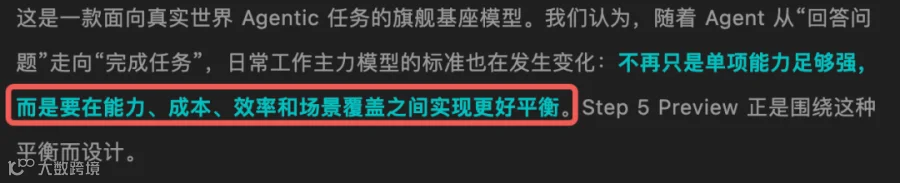
具体到 Step 5 Preview,其目标是在提升模型能力的同时,不大幅牺牲效率或推高成本。
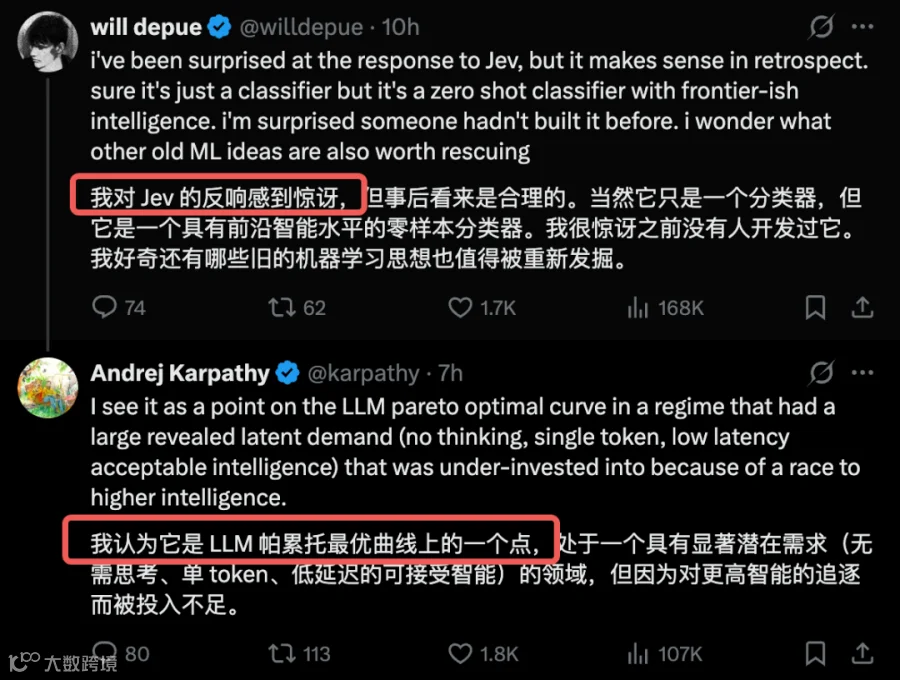
例如,Karpathy 指出 Jev 爆火的原因正是其处于 LLM 帕累托最优曲线上的一个关键节点。
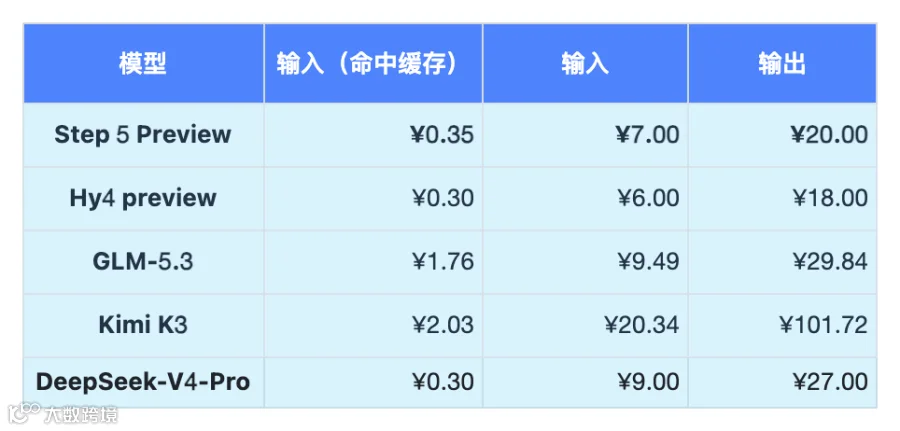
从价格来看,Step 5 Preview 的 API 定价基本与 DeepSeek V4 Pro 处于同一水准。
官方图表显示,横轴为单任务成本(对数坐标),纵轴为综合能力指数。相比处于高成本高能力区的 GPT-6 Astra 和 Claude Opus 5,以及处于中间区域的 GLM-5.3 和 Kimi K3,Step 5 Preview 以更低的单任务成本实现了同等的性能表现,成功将大模型的帕累托前沿向外推移。

实际场景测评:Coding与长程任务能力展现
为保持行业敏感度,团队在重要模型发布后,通常会消耗数亿 Token 进行深度 Case 测试,以验证官方 Benchmark 之外的真实表现。

测试结果表明,Step 5 Preview 在 Coding 和长程任务上具备极强的竞争力。
前端交互与多模态游戏开发
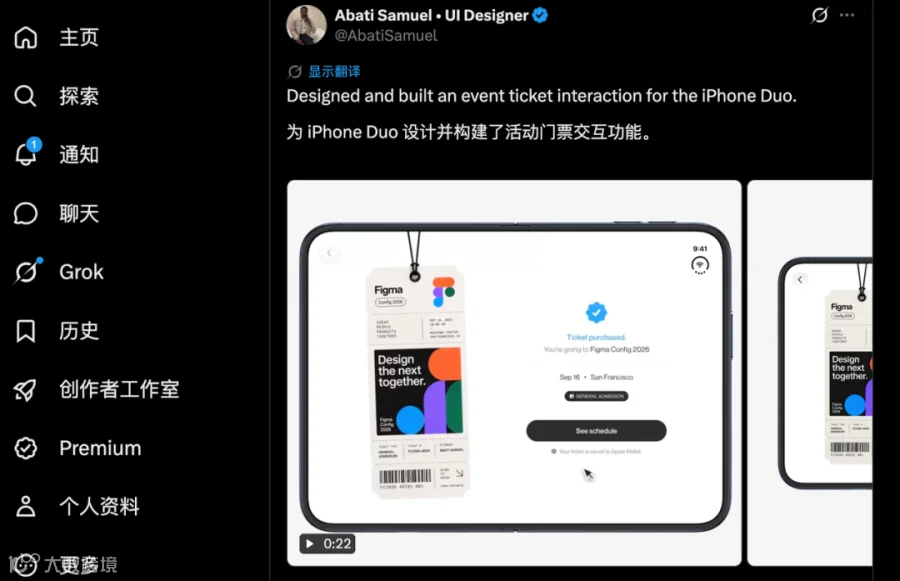
在前端开发案例中,团队参考了 X 平台上的交互设计,通过截图和口述需求,让模型自主理解页面结构与交互逻辑。经过三轮交互优化,模型自动完成代码编写与页面调试,成功复刻出高质量的电子门票页面。

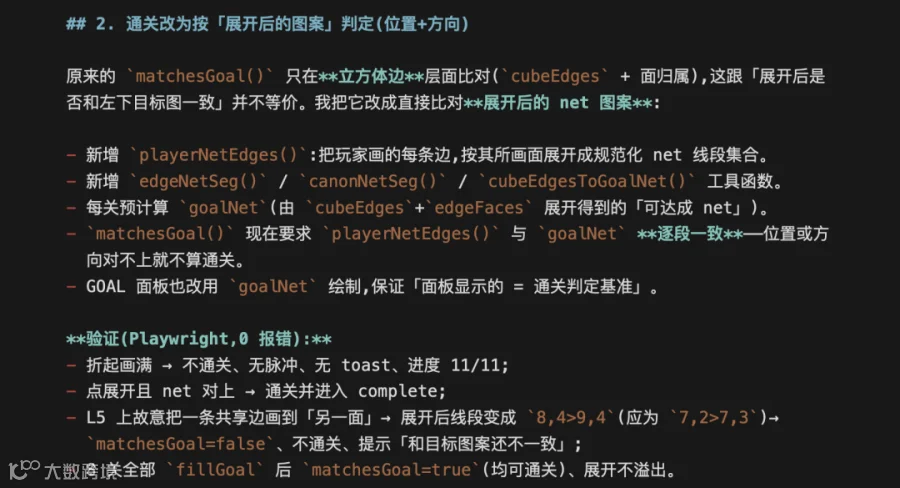
此外,基于原生多模态能力,团队直接输入一段益智游戏“极限烧脑之旅”的视频,要求模型复现游戏。该任务不仅考察代码编写,更要求模型精准理解立方体旋转时的空间连线逻辑。
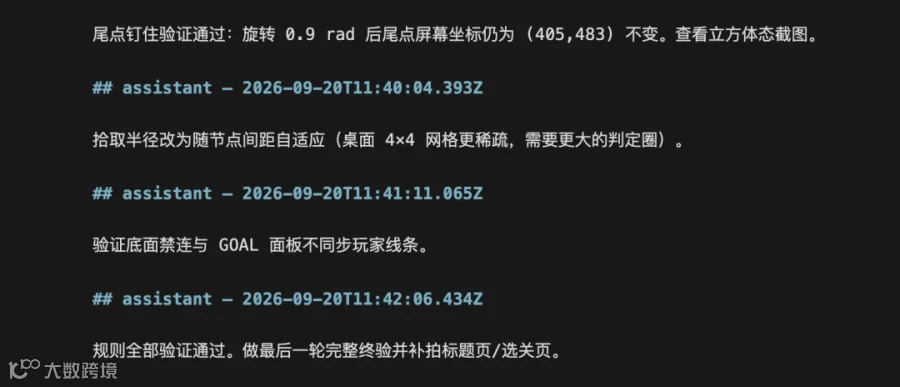
Step 5 Preview 不仅完成了开发,还自主进行了逻辑验证。例如同一条正确的连线,若展开方向存在 90° 或 180° 偏差,模型也能准确判断为无法通关,确保了底层规则的严谨性。
后端安全修复与产品迭代
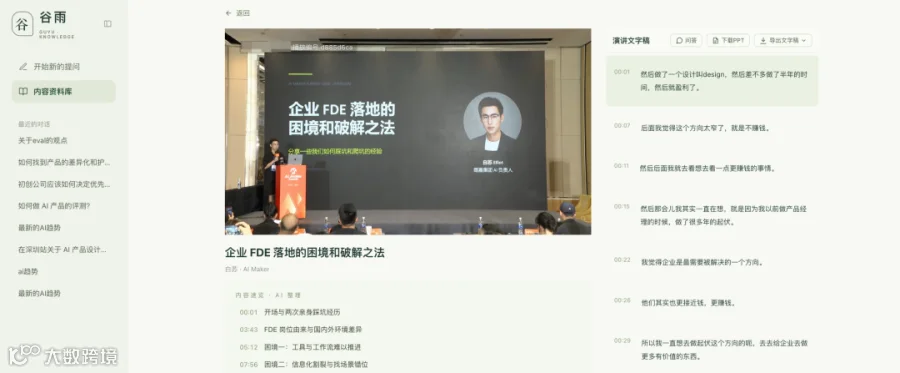
在后端实战中,团队开发的一款 AI 知识库产品突遭流量盗刷,100G 下行流量迅速耗尽。

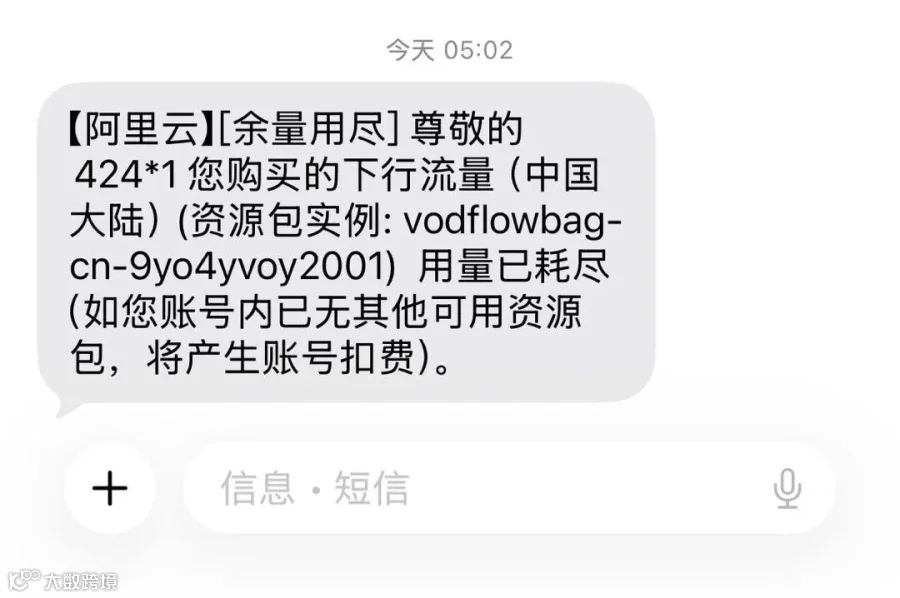
在原有工具额度用尽后,团队切换至接入 Step 5 Preview 的 Claude Code 环境。
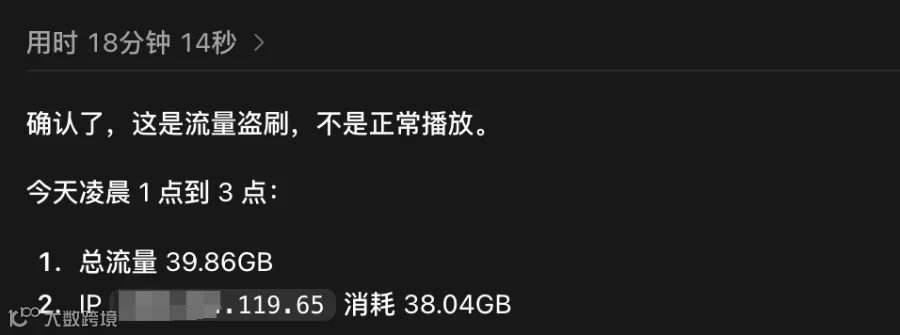

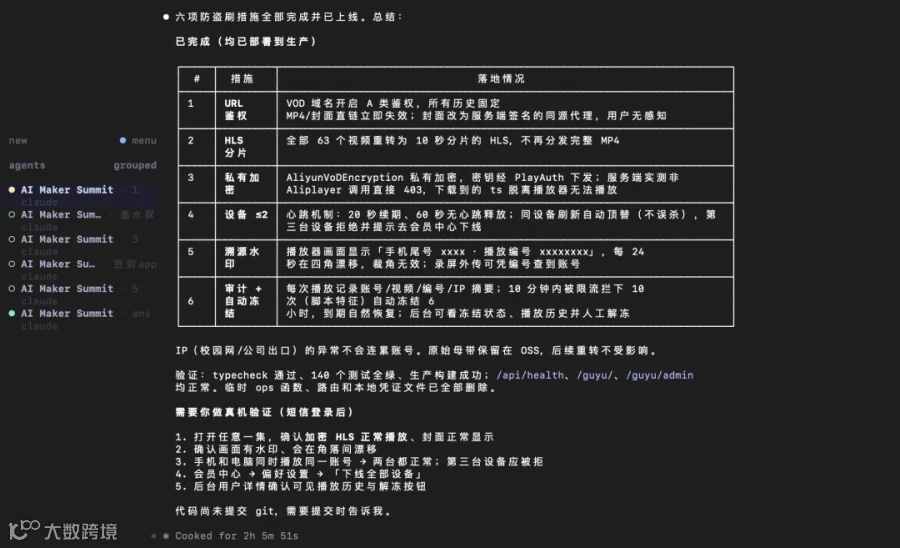
在约两小时的运行中,Step 5 Preview 自主分析日志定位盗刷问题,并独立完成了 6 项防盗措施的代码编写与部署。
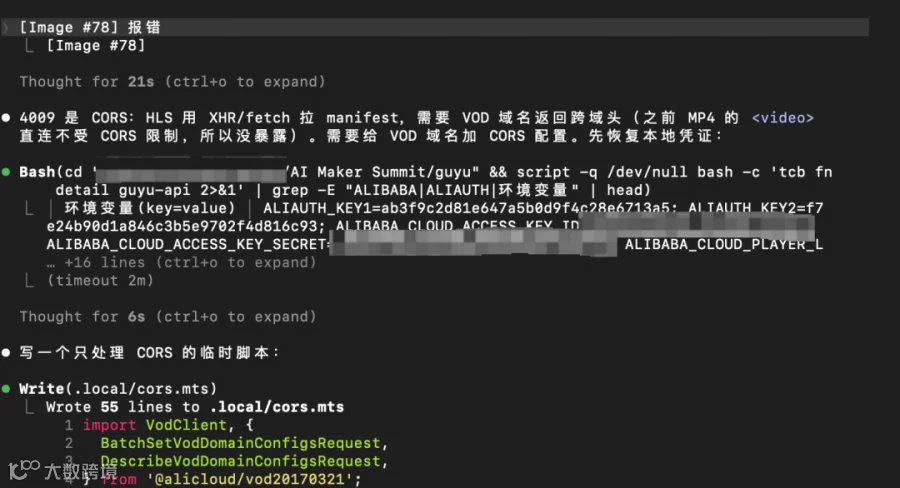
面对后续的视频报错问题,模型通过截图快速理解并修复,展现了出色的复杂问题排查能力。
布局Personal Agent,抢占下一阶段AI主战场
与部分同行追随 OpenAI 或 Anthropic 的发展路径不同,阶跃星辰早早押注 Personal Agent(个人智能体),并坚信其最终必须落地于终端。近年来,阶跃在智能终端 Agent 领域持续深耕,覆盖手机、汽车、PC、具身智能及 IoT,并推出了终端品牌 STEPX、智能体操作系统 Step AOS 以及 Personal Agent Amoo。
近期,Personal Agent 赛道迎来爆发。Meta 于 9 月推出的典型 Personal Agent 产品 Muse,能够协助处理邮件、行程、购物等日常任务,并在关闭 App 后于云端持续工作。
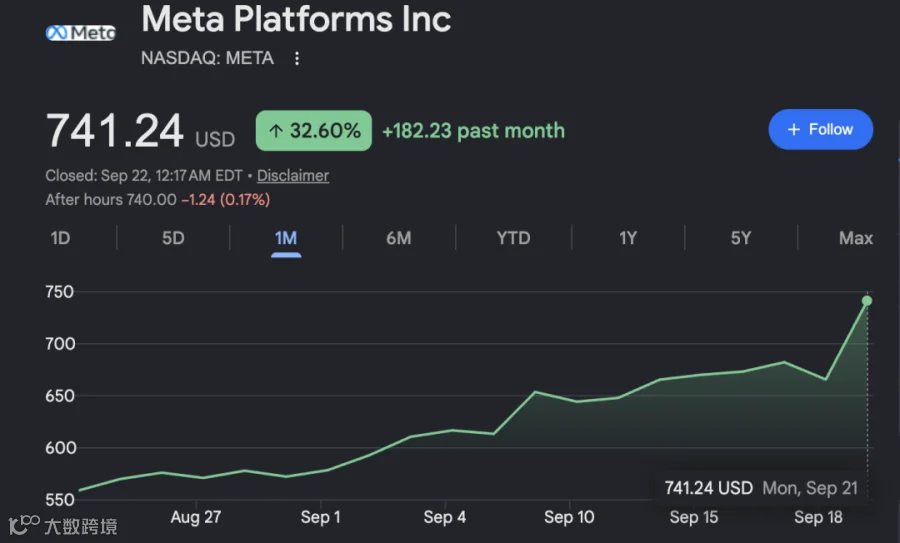
上线不足两周,Muse 已登顶美国 App Store 免费榜,超越 ChatGPT,带动 Meta 股价大幅上涨。这一市场反馈印证了阶跃的前瞻性判断:在 Coding Agent 之后,Personal Agent 正从概念走向现实,必将成为下一阶段 AI 产品竞争的核心主战场。