


导读端侧大模型过去常被理解成“把聊天模型塞进手机或电脑”,但真正有价值的变化,是它能否在本地读取文件、调用工具、执行代码,并完成一个有结果的多步任务。Spark-X2.5 的 4B 和 1.7B 模型,正是沿着这条路线设计的。本文不复述发布信息,而是拆开看:它靠什么提升端侧 Agent 能力,哪些演示值得关注,以及这些结果还不能证明什么。
本文 2169 字,阅读约 5 分钟|端侧模型的门槛,已经从“能不能回答”变成“能不能完成” → 4B 模型为什么能装下更长的任务?关键不只是参数量 → 它真正补上的,是从理解到执行的中间几步 → 官方评测说明了能力方向,但不是通用能力证明 → 4B 和 1.7B,适合的不是同一类任务 → 小模型开始动手,但还没有替人负责
端侧模型的门槛,已经从“能不能回答”变成“能不能完成”
过去的本地小模型,最容易展示的是聊天、续写和简单问答。它们可以告诉你“如何整理一份报表”,但不一定真的能打开文件、写脚本、运行检查,再把整理好的结果交回来。
这中间差的不是一句提示词,而是一整条执行链:模型要理解任务,决定下一步动作,调用正确的工具,读取工具返回的结果,发现错误后继续修正,最后交付一个人可以直接使用的产物。
这也是 Spark-X2.5 值得看的地方。它不是只把参数量继续往下压,而是把工具调用、代码和 Agent 工作流放进模型的主要能力目标里。官方仓库列出的适配对象包括 Codex、Claude Code、OpenClaw 和 Hermes;官方 ModelScope 资料则将它的评测分为智能体、代码、数学以及通用与知识任务。
换句话说,端侧模型的“好用”不再只是回复速度快,而是能不能在数据不离开本机的情况下,把任务往前推进。
4B 模型为什么能装下更长的任务?关键不只是参数量
Spark-X2.5 提供 4B 和 1.7B 两档规模,并宣称原生支持最长 1M token 上下文。这里的“上下文”不是模型记住了多少知识,而是一次推理时能够接收和处理多长的输入。长上下文可以帮助模型阅读更长的代码库、文档或多轮工具记录,但它不会自动保证模型能正确理解全部内容。
模型结构上,它采用混合注意力:一层全注意力层,搭配三层滑动窗口注意力层。全注意力让模型能够建立更远距离的 token 关系;滑动窗口注意力则把每层需要重点计算的范围限制在局部窗口里。前者负责全局联系,后者负责控制长序列的计算和缓存开销。
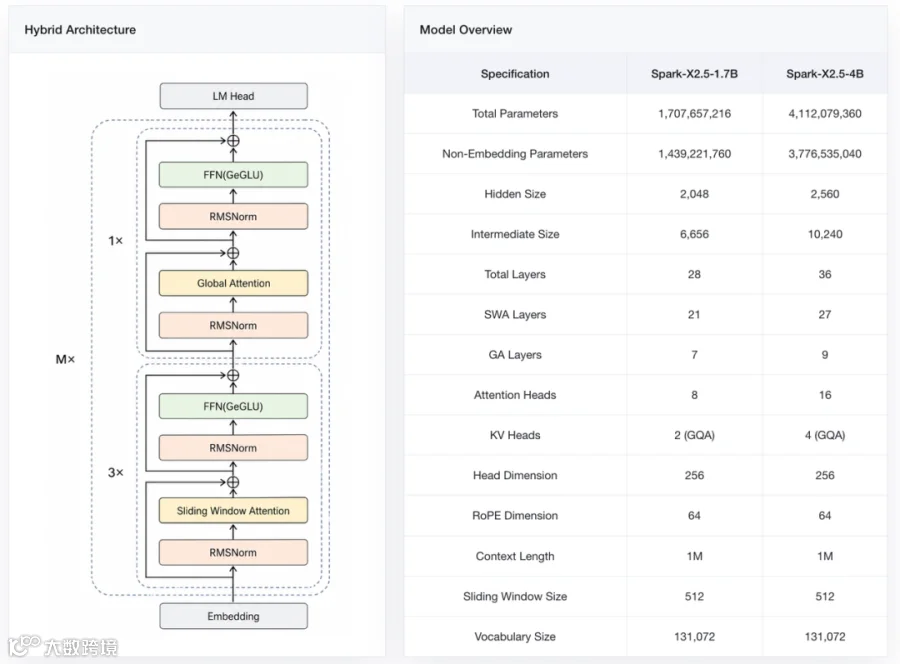 图片说明:图中展示全注意力层与滑动窗口注意力层的交替结构,以及两档模型的规格对比。图片来源:Spark-X2.5 官方 Hugging Face 模型卡。
这并不等于“1M token 在任何设备上都能轻松跑”。上下文长度只是模型支持的上限,实际能否运行,还取决于显存或内存、推理框架、量化方式、并发数和任务本身的输出长度。对普通开发者来说,更实用的理解是:它为长文档和长工具轨迹提供了更大的容器,但容器变大以后,仍然需要模型具备筛选、回看和调用工具的能力。
它真正补上的,是从理解到执行的中间几步
一条本地 Agent 工作流通常可以拆成四步:先读取任务和文件,再决定调用什么工具;工具返回结果后,模型继续判断是否需要下一步;最后生成报告、代码或修改后的文件。

在典型实现里,普通语言模型往往负责理解任务和生成结果,中间的工具动作由外部程序接管。Agent 模型则试图把“下一步做什么”也纳入模型的决策能力。
从官方 ModelScope 资料看,Spark-X2.5 的训练和后训练重点覆盖代码、工具调用、指令遵循和智能体任务。资料还披露了多教师在线策略蒸馏(MOPD):先针对数学、编程、工具调用等方向训练不同教师模型,再利用学生模型实际生成的轨迹构造训练信号,最后把不同能力合并到发布模型中。
这里要分清训练和推理。MOPD 是训练阶段的方法,不是模型运行时额外调用了多个教师模型;推理时,用户看到的仍然是一个可以部署在本地的模型。训练阶段想解决的是“模型如何学会更稳定地完成任务”,推理阶段才是“模型在你的电脑上能不能把任务跑完”。
新智元对该模型的合同比对和报销表格分析演示,恰好把这种变化具象化了:模型不是只给出审阅建议,而是尝试识别条款差异、生成 Python 脚本、执行检查并输出报告。这次演示至少说明,在特定任务和运行环境下,端侧模型可以承担一部分“读文件—调用工具—整理结果”的工作流。
但这些仍然是单次测试观察。它们不能直接推出模型在所有合同、所有表格或所有代码环境中都稳定可靠,敏感任务仍需要人工复核。
官方评测说明了能力方向,但不是通用能力证明
官方模型卡和仓库的评测资料中,Spark-X2.5-4B 在 τ³-bench、MCP-Atlas、BrowseComp 和 IFBench 等任务上都有对应成绩,例如 MCP-Atlas 为 54.6,BrowseComp 为 40.9,IFBench 为 75.0。
这些指标有助于说明它在工具调用、浏览、指令遵循等方向接受过针对性训练,也能让读者知道官方重点解决的是什么问题。但表格中同时包含不同模型、公开报告结果和缺失值,评测条件并不完全相同。“在某个榜单上得分不错”,不等于“在你的本地工作流里一定可靠”。
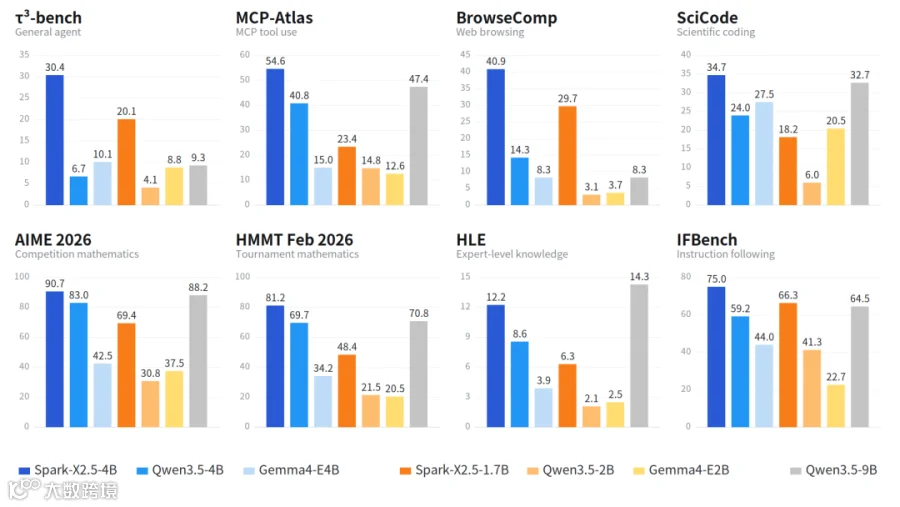 图片说明:官方对比图展示智能体、工具调用、浏览、代码、数学和指令遵循等任务;不同模型和任务的评测条件并不自动等价,不应视为统一条件下的独立横向测试。图片来源:Spark-X2.5 官方 GitHub 仓库 benchmark.svg(发布 PNG 由原始 SVG 渲染)。
判断一个端侧 Agent 是否值得部署,我更建议看三个问题:
它能不能正确选择工具,而不是只会生成工具调用格式?
工具返回错误或结果不完整时,它能不能发现并修正?
最终交付物是否需要大量人工返工,返工成本有没有低于直接手动完成?
这三个问题,比“参数量小不小”或“榜单排名高不高”更接近真实使用价值。
4B 和 1.7B,适合的不是同一类任务
两档模型并不是简单的“大杯和小杯”。更合理的区分方式,是看任务需要多少上下文、多少步工具调用,以及错误一次的代价有多高。
4B 更适合复杂本地工作流。例如代码辅助、长文档比对、结构化数据检查和需要多轮工具调用的任务。这类任务对模型的记忆、指令跟随和错误恢复要求更高,通常也更依赖电脑或工作站的内存和推理速度。
1.7B 更适合轻量、固定边界的设备任务。例如设备端固定指令、轻量交互和局部控制。它的优势是部署压力更小,但不能因为模型能运行,就默认它能承担开放式、多步骤、高风险任务。
这也是端侧模型的现实边界:本地运行带来隐私、延迟和离线能力,但模型规模越小,越需要把任务边界、工具权限和失败兜底设计清楚。让模型只拥有完成任务所需的工具,比把所有权限一次性开放给它更重要。
模型下载与使用
官方项目与部署说明: https://github.com/XHToken/Spark-X2.5
ModelScope 模型合集: https://modelscope.cn/collections/XHToken/Spark-X25
小模型开始动手,但还没有替人负责
Spark-X2.5 的意义,不在于证明 4B 模型已经等同于更大的云端模型,而在于它把端侧模型的评价标准往前推了一步:从“能不能在本地回答”,推进到“能不能在本地执行一段受约束的工作流”。
它的混合注意力为长上下文提供了结构基础,Agent 后训练让工具调用和任务完成成为明确目标,4B 与 1.7B 两档规模则把能力放进了不同设备条件。
但真正部署时,仍然要把模型能力、工具权限、硬件条件和人工复核放在一起评估。端侧 Agent 的下一道门槛,不是让模型看起来更像人,而是让它在失败时足够可控。
参考资料
Spark-X2.5 官方仓库: https://github.com/XHToken/Spark-X2.5
Spark-X2.5 ModelScope 介绍与评测资料: https://mp.weixin.qq.com/s/3Kc7Fmo5nEGqR5WkwexleQ
Spark-X2.5 端侧实测与案例资料: https://mp.weixin.qq.com/s/5d7rxG8MAQAiJaaFEADX5g
2026 年 9 月 1 日发布信息: https://kw.beijing.gov.cn/xwdt/kcyx/xwdtyqqy/202609/t20260902_4847082.html
— THE END —
文章仅做学术分享,如有侵权请联系删除,非常感谢!