

哈喽,大家好~
有同学提到:如果我给你很多已经标注好的数据,你能不能让机器自己总结规律?
其实可以,但关键是,机器学到的规律,能不能用来判断没见过的新数据
这篇文章我们就来聊机器学习里最基础、也最常用的一类方法:监督学习。
什么是监督学习?
监督学习可以理解成:给模型一批带有正确答案的数据,让模型学习输入和答案之间的关系。
比如我们想判断一封邮件是不是垃圾邮件:
-
输入:邮件内容、发件人、关键词数量等特征 -
答案:垃圾邮件,或者正常邮件
这里的输入叫作特征,通常记作 ;答案叫作标签,通常记作 。
模型要做的事情,就是学习一个函数:
其中, 是模型学到的规律, 是模型对新数据的预测结果。
你可以这样理解:老师给学生看很多“题目+答案”,学生慢慢总结出解题方法。之后遇到新题目,学生根据学到的方法给出答案。
监督学习主要分成两类:
-
分类问题:预测类别,比如是否患病、是否违约。 -
回归问题:预测连续数值,比如房价、销量、温度。
模型到底是怎么学的?
我们先以分类模型为例。模型会根据特征计算一个结果,然后和真实标签进行比较。
如果预测错了,就通过损失函数衡量“错得有多严重”。常见的分类损失是交叉熵:
这里:
-
是真实标签,取值为 或 -
是模型预测为正类的概率 -
越小,说明预测越接近真实答案
训练过程就是不断调整模型参数,让整体损失越来越小:
这句话翻译一下就是:找到一组最合适的参数,让所有训练样本的平均错误尽可能小。
不过,训练集上表现好还不够。真正重要的是,模型面对从来没见过的数据时,也能判断准确。这就是监督学习里的泛化能力。
用 SVM 判断两类样本
下面我们构造一份数据集。每个样本有两个特征,标签分成两类。
我们使用支持向量机 SVM,并设置 RBF 核函数,让模型可以学习弯曲、复杂的分类边界。
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVC
from sklearn.metrics import roc_curve, auc, accuracy_score

# 构造带有非线性结构的数据
X, y = make_classification(
    n_samples=700,
    n_features=2,
    n_redundant=0,
    n_informative=2,
    n_clusters_per_class=2,
    class_sep=0.9,
    flip_y=0.08,
    random_state=42
)

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, stratify=y, random_state=42
)

model = make_pipeline(
    StandardScaler(),
    SVC(C=2.0, kernel="rbf", probability=True, random_state=42)
)
model.fit(X_train, y_train)

print("测试集准确率:", accuracy_score(y_test, model.predict(X_test)))

# 绘制分类区域和测试样本
x_min, x_max = X[:, 0].min() - .8, X[:, 0].max() + .8
y_min, y_max = X[:, 1].min() - .8, X[:, 1].max() + .8
xx, yy = np.meshgrid(
    np.linspace(x_min, x_max, 400),
    np.linspace(y_min, y_max, 400)
)
grid = np.c_[xx.ravel(), yy.ravel()]
prob = model.predict_proba(grid)[:, 1].reshape(xx.shape)

fig, ax = plt.subplots(1, 2, figsize=(13, 5))

ax[0].contourf(
    xx, yy, prob, levels=30,
    cmap="turbo", alpha=0.65
)
ax[0].contour(
    xx, yy, prob, levels=[0.5],
    colors="black", linewidths=2
)
ax[0].scatter(
    X_test[:, 0], X_test[:, 1],
    c=y_test, cmap="cool", edgecolors="white",
    s=55, alpha=0.9
)
ax[0].set_title("SVM 非线性决策边界")
ax[0].set_xlabel("特征 1")
ax[0].set_ylabel("特征 2")

# 绘制 ROC 曲线
y_score = model.predict_proba(X_test)[:, 1]
fpr, tpr, _ = roc_curve(y_test, y_score)
roc_auc = auc(fpr, tpr)

ax[1].plot(
    fpr, tpr, color="#ff3366",
    linewidth=3, label=f"AUC = {roc_auc:.3f}"
)
ax[1].plot(
    [0, 1], [0, 1],
    linestyle="--", color="#555555"
)
ax[1].fill_between(
    fpr, tpr, color="#ffcc00", alpha=0.25
)
ax[1].set_title("测试集 ROC 曲线")
ax[1].set_xlabel("假阳性率 FPR")
ax[1].set_ylabel("真正率 TPR")
ax[1].legend()
ax[1].grid(alpha=0.25)

plt.tight_layout()
plt.show()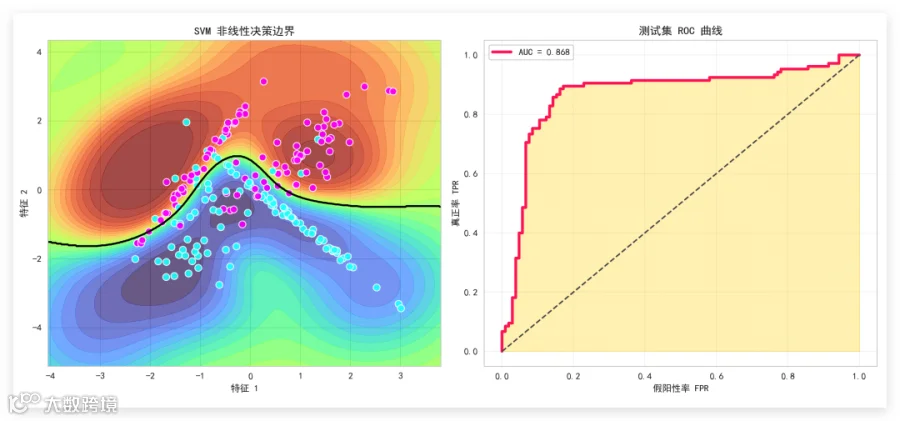
左图中的彩色区域表示模型对整个特征空间的判断结果。颜色变化越明显,说明模型越不确定;黑色曲线是概率为 的位置,也就是模型认为两类样本“平分秋色”的决策边界。
白色边缘的散点是测试集样本。它们没有参与模型训练,所以更能反映模型面对新数据时的效果。
右图是 ROC 曲线。横轴是假阳性率 FPR,表示把负类误判成正类的比例;纵轴是真正率 TPR,表示正确识别正类的比例。
AUC 可以理解为模型区分正负样本的整体能力:
-
AUC 接近 :区分能力强 -
AUC 接近 :和随机猜测差不多
这里使用的 RBF 核函数可以把原本难以用直线分开的数据,映射到更高维空间中处理。参数 控制模型对错误的容忍程度, 越大,模型越重视训练样本;参数 控制单个样本影响范围,过大容易过拟合。
注意点
第一,训练集和测试集必须分开。测试集不能参与训练,否则评估结果会过于乐观。
第二,很多模型对特征尺度敏感。比如一个特征范围是
到
,另一个特征范围是
到
,模型可能会被大数值特征影响,所以代码里先使用了 StandardScaler。
第三,不要只看准确率。如果正负样本极度不平衡,准确率可能会掩盖问题,这时还要关注精准率、召回率、F1 和 AUC。
总结
监督学习的核心,就是利用带标签的数据,学习输入特征和目标答案之间的关系。训练时模型不断降低损失,真正的目标则是对新数据保持良好的泛化能力。
这次案例中,我们用 SVM 学习非线性分类边界,再用 ROC 曲线和 AUC 评价模型效果。接下来你可以尝试修改 C、gamma 和 class_sep,观察决策边界如何变化;也可以把 SVM 换成逻辑回归、随机森林,对比不同模型的分类结果。