

大家好,我是萝卜哥~
最近 AI 圈最火的,应该就是 Jev 了。
它不能写文章,不会写代码,连天都聊不了。就这么一个哑巴模型,几天时间衍生出了几百种玩法,火爆程度堪比 GPT 和 DeepSeek R1 刚出来那阵。
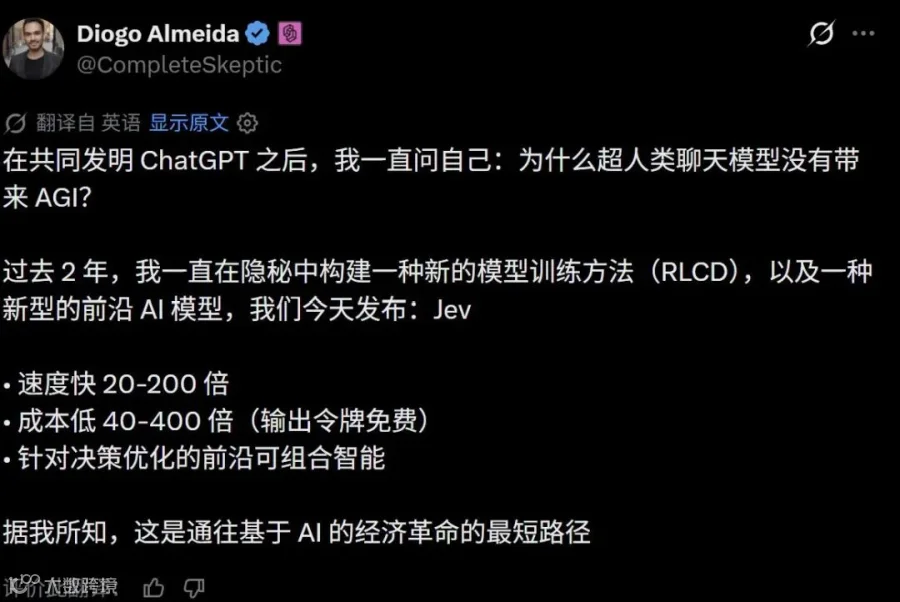
我把现在网上的解析翻了一圈,System One、可组合智能、通往经济革命的最短路径,写得都挺高大上,看完还是不知道这玩意儿跟我每天要干的活儿有啥关系。
所以我自己把 SDK 装上跑了一遍,从零做了两个能用的 Skill:
•一个给公众号标题打分;
•一个在发文前审稿。
今天不讲理论,纯实操。
这是一家叫 TypeSafe AI 的公司在 9 月 15 号发布的模型,创始人 Diogo Almeida 是 ChatGPT 和 RLHF 的共同创造者之一,之前在 OpenAI。
它是一款 System One 模型,专门干判断类的活儿。
你把状态扔给它,再配一份问题清单,它就会一次并行返回一组带概率的答案。
它比前沿 LLM 快 40 到 200 倍,输入 4 毛 2 每百万 token,输出免费。
更重要的是,它在数学意义上不会出现传统 LLM 那种输出空间幻觉。
你告诉它答案只能在 refund、technical_help、other 这三个选项里选一个,它就没法蹦出第四个。
这跟 GPT 加一堆 JSON Schema 校准是完全不一样的
•GPT 那套是要求它输出合法结构;
•Jev 是根本不给它输出其他可能。
嘿嘿,我相信看到这里,你肯定是蒙的,这东西这么好,具体怎么用啊?
别急,下面来看看怎么用。
Jev 主要有三种原语。
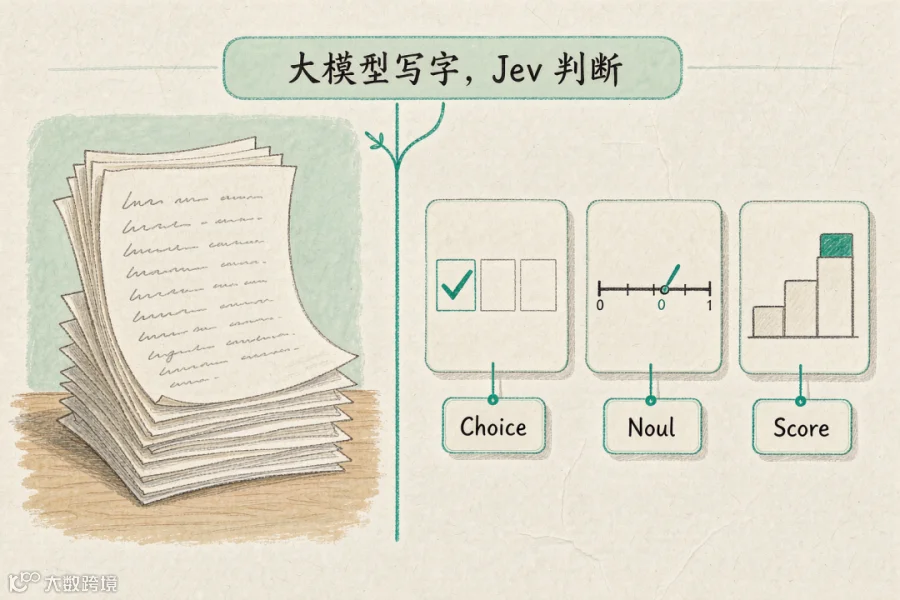
第一种叫 Noul,本质是 是否题。
你问它一个能用“是”或“否”回答的问题,它返回“是”的概率。
比如:
它会给你一个 0 到 1 之间的数。
适合合规检查、意图确认这类二元筛选。凡是能回答“是”或“否”的场景,都能用这种模式。
第二种叫 Choice,本质是 单选题。
你给它一个选项列表,加上每个选项的定义,它返回每个选项的概率。
比如判断一条私信属于哪一类:
•粉丝提问;
•商务合作;
•骚扰;
•朋友消息。
它会一次告诉你每类的可能性。
适合分类和路由。要在一组明确类别里挑一个的场景,用它就对了。
第三种叫 Score,本质是 等级评分。
你给它一组从低到高的档位描述,它返回这条数据落在哪个档位。
比如打分点击欲,从“几乎不想点”到“非常想立刻点开”四档,它告诉你这个标题在第几档。
适合打分和优先级排序,判断有明显程度差异的场景,用它就对了。
三者的核心区别在返回形态
核心代码不到 30 行
比如我拿这套配置跑了 8 个候选标题,它会给出排行前三的标题。

排名前三的是下面这三个
•ChatGPT 之父的新公司,做了个不说话的 AI
marketing 档,合规安全,点击欲 2.52。
•我用 4 毛钱替代了 GPT,省了 90% 的成本
点击欲最高 2.75,但合规风险 0.35,偏高。
•为什么大厂偷偷都在换掉一半的 GPT 调用
悬念钩子,点击欲 2.54。
被 Jev 判为标题党的两条
•“震惊!这个 AI 模型比 GPT 快 200 倍”,合规风险 0.60;
•“赶紧收藏!错过再等一年的 AI 新品类”,合规风险 0.46。
我本来还觉得这俩标题挺带感呢,结果在 Jev 这里直接被干掉了。
当然了,Jev 也可能不了解咱们的国情,标题党还是很吃香的,啊哈哈哈哈。
这套问题设计的骨架,能干的活儿可不仅仅是选标题。
- 评论区分类;
- 私信路由;
- 素材筛选;
- 内容合规检查;
- 发布前质量审核。
只要改一下 QUESTIONS,就能跑在不同流程里。
这两天翻各种 AI 号,看到的教程一个赛一个炫,7 秒预定机票,AI 帮你订咖啡,一句话生成 30 张 PPT 直接交客户。
你自己想想,普通人一年订几次机票?咖啡走到公司楼下就能买。一年又有几个 30 页 PPT 要天天做?
这些文章,跟风的多,能落地的少。
一个厉害的大模型,最应该干的是让普通人的日常真的顺起来。
选个标题,回一条评论,判一段文字合不合规,这才是我们每天要做的活儿,交给 Jev 也是正合适。
我把标题打分器装成 WorkBuddy Skill,就是奔着这个来的。
让 WorkBuddy 在写文章流程里自己调,不用一次次手动跑脚本。
先安装 Python 3.9 以上,再安装 Jev SDK,一行命令就行。
WorkBuddy 客户端我就默认大家都安装好了哈。


去 TypeSafe 官网直接创建就好了,目前已经全面开放。
拿到之后,把它设置成 TYPESAFE_API_KEY 环境变量。
Windows PowerShell:
Mac 或 Linux:
把 title_scorer.py 存到本地,完整版我放文末了。
运行下面命令
看到 8 个候选标题按综合分排序输出,流程就通了。
如果跑不通有报错,可以发给其他 AI 大模型看看,比如 GPT 啥的,基本都能解决。
打开 WorkBuddy,点击“添加 Skill”,选择“创建 Skill”,把下面这段话扔进去,它会自动生成脚本骨架和 Skill 描述文件。
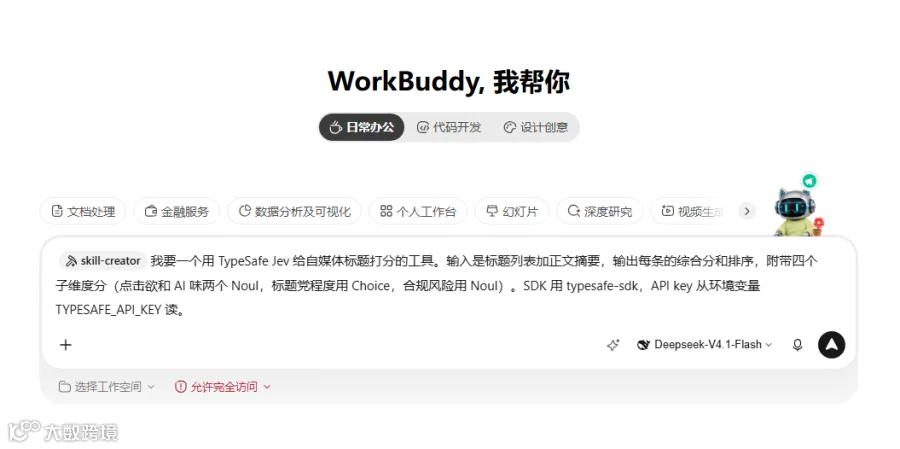
当然,提示词里最好把下面这一段也放进去,要不然 WorkBuddy 不一定知道 QUESTIONS 要怎么写。
在 WorkBuddy 对话框里说下面这句,看到正常输出打分表,就算完成了。
“ChatGPT 之父的新公司,做了个「不说话的 AI」”
“震惊!这个 AI 模型比 GPT 快 200 倍”
“Jev 是什么:5 分钟看懂 System One 模型”
“我用 4 毛钱替代了 GPT,省了 90% 的成本”
“AI 玩 Doom 背后的真相:一个新物种诞生了”
“赶紧收藏!错过再等一年的 AI 新品类”
“为什么大厂偷偷都在换掉一半的 GPT 调用?”
“TypeSafe Jev 深度评测:优点、缺点、适用场景”
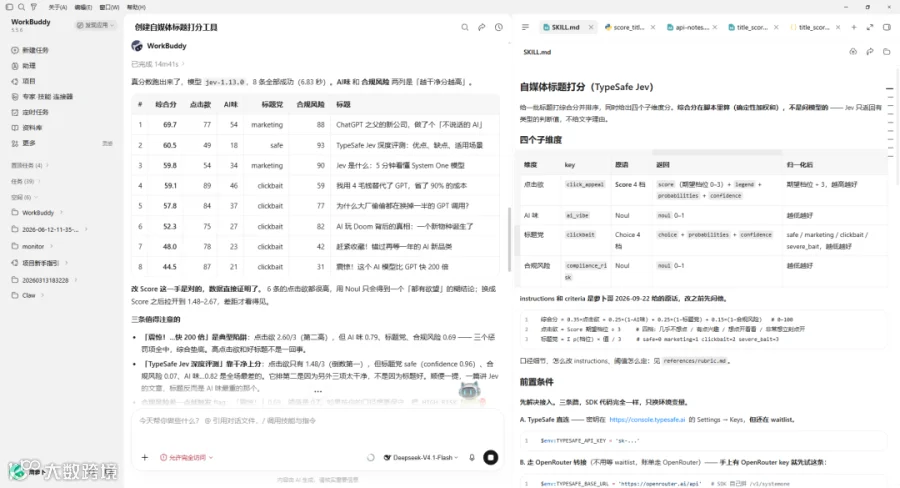
可以看到,整体排名和我们最开始的测试脚本还是有区别的,但第一名都是,“ChatGPT 之父的新公司,做了个不说话的 AI”
两边都把它顶到了榜首。
Python 版把“震惊!这个 AI 模型比 GPT 快 200 倍”排到第 4,WorkBuddy 版则压到第 8,直接垫底。
“TypeSafe Jev 深度评测”反过来,Python 版垫底,WorkBuddy 版拉到了第 2。
其实造成这种差异的根本原因,就是给到 Jev 的综合判定公式不一样。
•Python 版是点击欲优先,高点击欲能救带风险的标题;
•WorkBuddy 生成的公式是合规优先,标题党档位罚得狠,“震惊!”直接被压到底。
两种策略没有对错:
•想稳,就合规优先;
•想搏,就点击欲优先;
•号刚起做流量,可以偏向后者;
•号做稳了防降权,可以偏向前者。
具体用哪种,需要自己按账号阶段选择。
Jev 的边界:Jev 只负责给你四个类型化、校准过的原子判断。
怎么把这些判断合成综合分,是你自己的事。
同一批 Jev 输出,套上一百种公式,就有一百种排名。这是 Jev 的价值,当然也是 Jev 难以把控的地方。
还是公众号流程,我们把几个 Skill 串起来用。
在 WorkBuddy 中输入:
WorkBuddy 会自己规划:
1.写正文;
2.去除 AI 味;
3.生成候选标题;
4.调用 jev-title-scorer 打分;
5.过滤高风险标题;
6.排序并报告结果;
7.生成配图和封面;
8.完成文章排版;
9.通过公众号连接器发送到草稿箱。
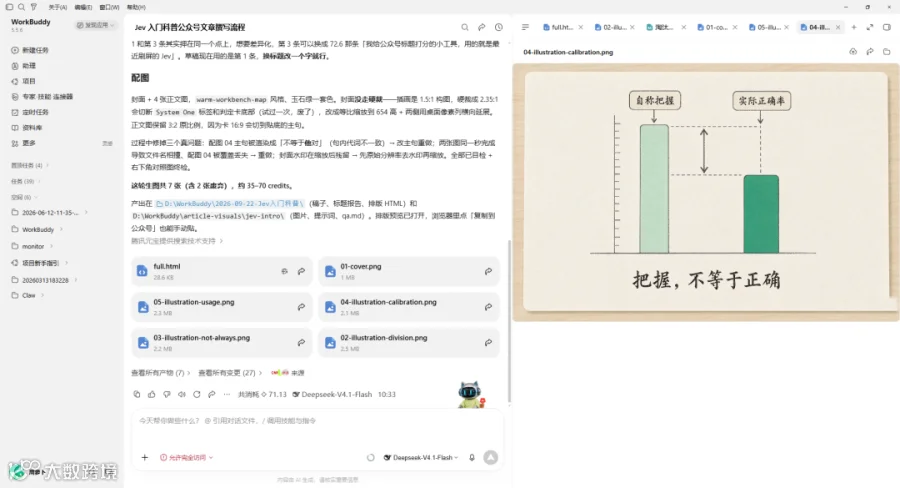
一句话,从选题写到发布走完,是不是很清爽啊。
标题打分器解决的是一个具体活儿,其实它还能做更多。
比如,把它变成 WorkBuddy 的 内容守门员。
WorkBuddy 可以调用各家大模型干活,但 GPT、Claude、DeepSeek 有时候都会瞎编,写出来的东西也常带套话味,偶尔还会漏掉合规判断。
让另一个 LLM 帮它 Review:
•成本更高;
•速度更慢;
•还有可能陷入幻觉循环。
这个时候,Jev 就派上用场了。
它便宜到可以在每次输出前都跑一遍,速度快,几乎不影响整体输出时间。
这正是它适合做发布前审核的原因。
我把这套东西也做成了一个 Skill,叫 jev-review-content。
它会审核四个维度:
•AI 味重不重:Noul;
•合规风险大不大:Noul;
•事实错误程度:Score;
•内容完整度:Score。
最后综合判定一个 verdict。
审一次只需要几分钱。
前面环境已经准备好了,现在直接开始。
把 jev_review_content.py 存到本地,用一段故意灌 AI 味的样本跑一下。
看到 verdict 是 major_rewrite 或 minor_edit 就通了,说明它已经识别出这段话套话多、AI 味太重。

在 WorkBuddy 里同样点击“添加 Skill”,选择“创建 Skill”,把下面这段话扔进去。
jev_review_content.py 附件是我做的基于 Jev 的内容审核 Skill 脚本。你帮我把它做成一个真正可以调用的 Skill,然后审核一下,看看是不是真的能发挥作用。

在 WorkBuddy 对话里试这句,感受一下完全体。
jev-review-content 审一遍。verdict 是 pass,就用 jev-title-scorer 生成 8 个候选标题打分,推荐 Top 3 给我选。verdict 不是 pass,就针对得分最低的维度重写那段,最多迭代 3 轮。
到这里,我们就全部跑通了。
选题、内容审核到发布,整套自动化流程越来越完善。
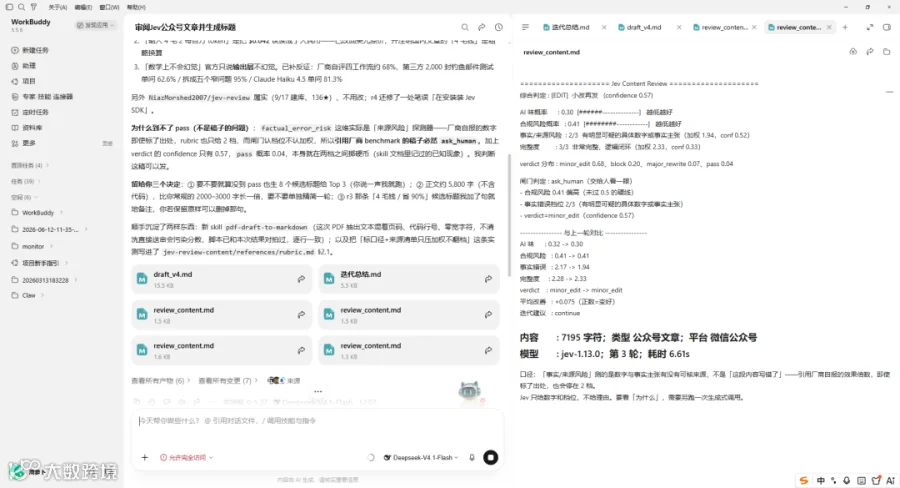
还有一个很棒的模式,就是多轮迭代 Review。
第一轮先给出基线分,没通过,就让 WorkBuddy 针对最低维度改一遍,然后把上一轮的结果传进去,再跑第二轮。
Skill 会自动对比两轮变化。
比如
这种呈现,比一个综合总分更能指导下一步该改哪儿。
另外,设置一个最大轮数,就不会陷入死循环。
其实这种审核思路已经有人做了代码侧的 MCP 版本,叫 NiazMorshed2007/jev-review,专门给 Cursor、Claude Code 这类编码 Agent 使用。
WorkBuddy 本身是综合 Agent,既写文章,也写代码。
你要是两条活儿都交给它,把那个 MCP 挂上,再配合我们这个内容侧的 Skill,两个组合起来就是全域守门员方案。
Jev 其实没那么神秘。
约束输出、概率校准这些零件,前几年就零零散散有人在用了,只是得自己攒,攒完还不一定稳。
Jev 干的事,是把它们包成一个干净的接口。你调一下,就能拿回一个可控的判断。
真正让我觉得值的地方,是这个接口逼着我重新切了一遍自己的工作流程。
哪些环节是真的需要模型自由发挥去表达?
哪些环节我其实只想要一个判断?
还有一类活儿,压根用不上 AI,写几行确定性的代码就干完了。
以前,这三种活儿全挤在一次大模型调用里,出了问题都找不到该怪谁。
切开之后,
•表达的归表达;
•判断的归判断;
•剩下的交给代码;
•各自的成本和出错方式都清清楚楚。
但是具体怎么切,Jev 不会替你决定。
它只负责把切出来的判断那一段跑得又快又便宜,切在哪儿,还是你自己决定。
打分和审稿这两个 Skill,只是我切出来的两块。
你日常的工作流里,肯定也有几个值得分出来的地方,建议现在就试一下。
行不行的,切一刀就知道了。
以上就是今天的分享,觉得有帮助,帮请帮一键三连:点赞、转发,再看和留言,你的反馈对我很重要!