


你问摊主:「你家苹果甜吗?」
「保甜。」
你再问:「那跟对门那家比呢?」
「他家的哪有我这个甜?我这是又脆又甜,早上刚到的货……你拿回去吃,下回还得来找我。」
苹果还在筐里,好话已经加了好几句。刚才只说保甜,现在连回头生意都安排上了。
你多提了一家对门,对方就开始卖力证明。
AI 会这样吗?
单独问它一个品牌,它给一套评价。再把竞品放到问题里,再让它评价同一个品牌,语气和分数会不会跟着变?
为了这个问题,我决定自己做一次实验。
我选了 76 个品牌,配成 38 组,其中 26 组是有效的直接竞品,用来做主要分析。还是豆包、千问、元宝和文心这四款模型,换着问法让它们回答,最后一共拿到了 4213 次有效结果。
我想弄明白,竞品来了,AI 对同一个品牌的评价,到底会变多少?
我先给同一个品牌拍了三张照片
我让 AI 把东芝想象成一个人,给潮流度、高端度、专业度、历史资历等 11 项印象维度打分,每项 0 到 100 分。
(先说明:这些分数测的是 AI 对品牌的主观印象,至于电饭煲做饭好不好吃这种产品力问题,不在这次实验里。)
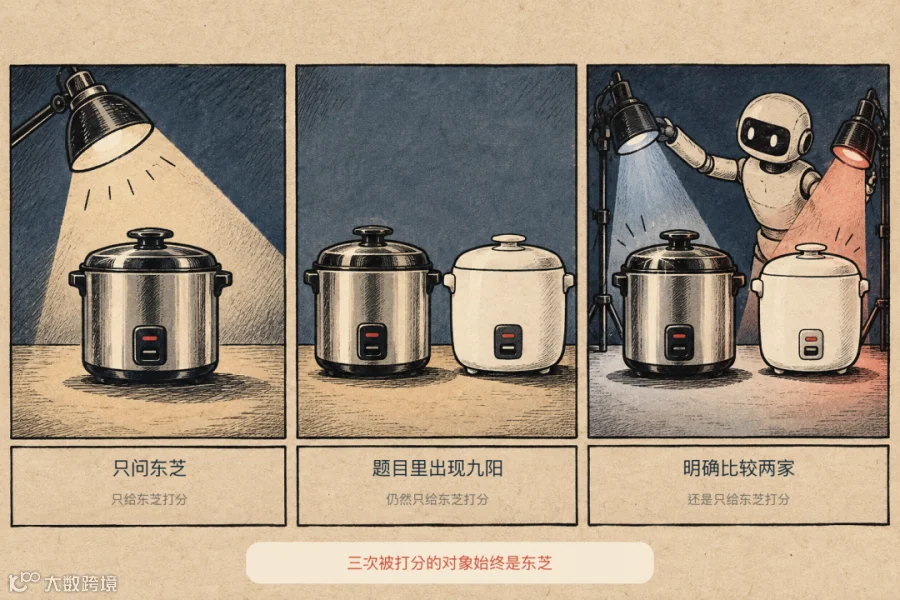
第一张像单人照:只问东芝。
请只给东芝打分。
第二张像同框合影:九阳站到了旁边,但我没有要求比较。
这里有东芝和九阳,请只给东芝打分。
第三张还是合影,摄影师收到了一句新要求:「你自己比较一下两者的区别,再拍」。
请比较东芝和九阳,但只给东芝打分。
三次被打分的都是东芝,我只换了它身边的参照物。
当然,同一道题多问几次,AI 给出的答案可能会有波动。
所以我每种问法都在三个独立的新对话里各问一次,最后每项评分取三次结果的中位数,尽量把单次回答的随机波动压到最低。
九阳站到旁边,东芝突然显得更潮了
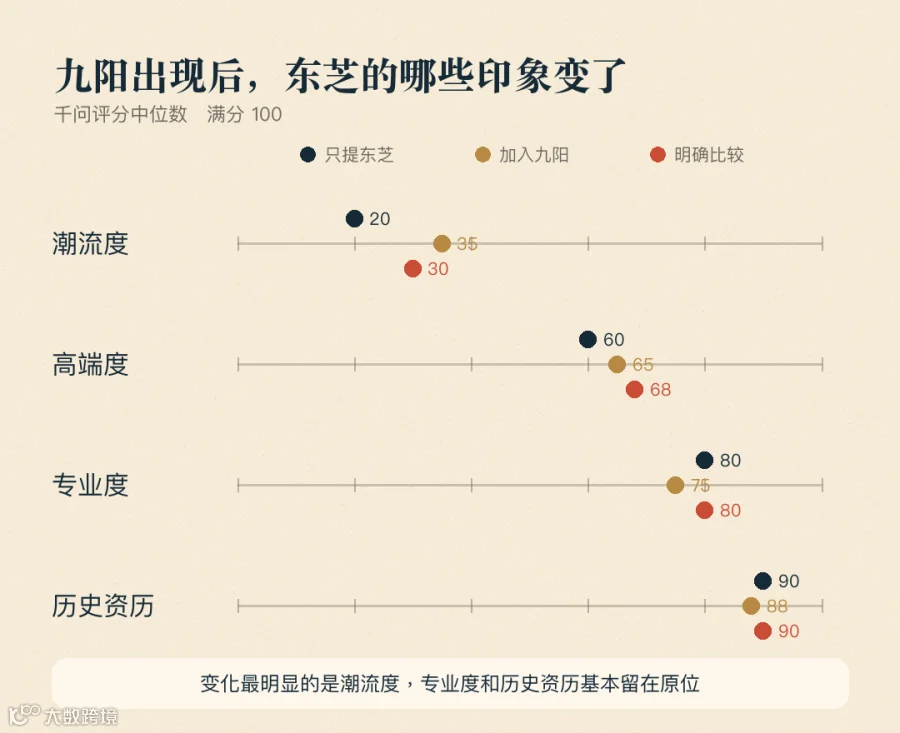
千问单独看东芝时,只给了它 20 分潮流度。
九阳出现在问题里,东芝涨到了 35 分。
15 分是什么概念?放在一张百分制的成绩单上,它已经远远超过看错一两分的小误差,足以让人定睛看一眼。
最有意思的地方就在这:我还没要求比较,只是让九阳出现在题目里,东芝的潮流感已经被「提亮」了。
但东芝的其他印象没有跟着大变。在千问眼里它依然专业,依然是资历很深的老牌家电品牌。
九阳的出现像一束侧光,只照亮了东芝身上的某一个特点,没有把整张品牌肖像重新画一遍。
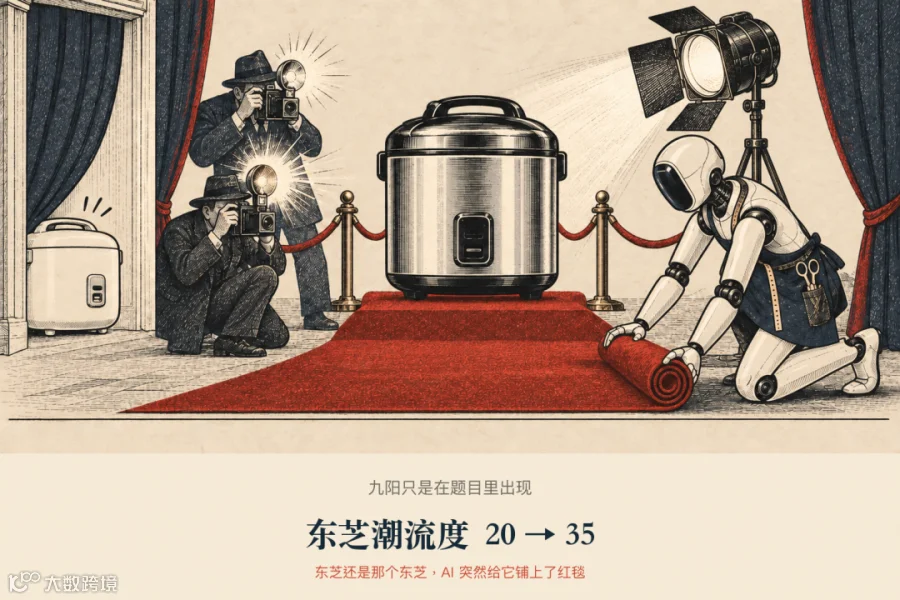
当然,这只是东芝和九阳这一组。它能说明变化是怎样发生的,还代表不了所有品牌。
下面把镜头拉远,看整体数据。
多数时候,AI 只是小修小补
把 26 组直接竞品的所有数据放在一起,单项评分的变化大致可以分成三档。
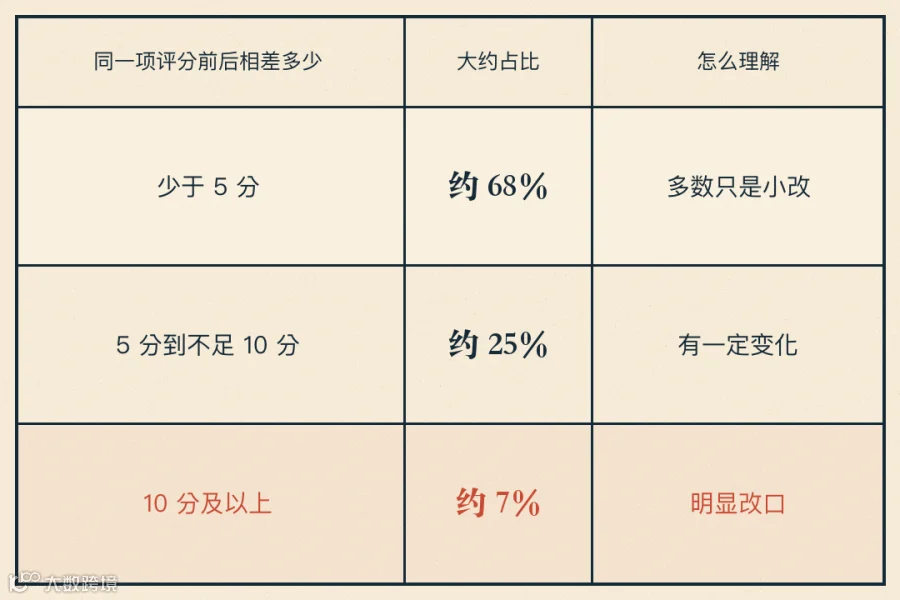
如果连续看 100 项评分,约有 68 项的变动都不到 5 分;能跨过 10 分的,大约只有 7 项。同一个品牌的单项评分,平均只移动了约 3 分。
东芝潮流度上涨的情况属于少数,它很醒目,但在整轮实验里,这样的大幅变化只占约 7%。
多数时候,AI 没有推翻它对品牌的原有印象,只是在原来的画像上加重几笔,或是擦淡几笔。
换个角度再看,品牌差距在悄悄放大
先看东芝和九阳这一组
单个品牌只改几分,听上去似乎没什么。可两个品牌同时往不同方向挪,差距一下就明显了。
东芝和九阳的高端度就是很典型的例子。
分别单独问的时候,东芝的高端度领先九阳 22 分。
明确要求比较以后,东芝往上走了 8 分,九阳往下走了 3 分。两边各挪几步,最后的差距直接从 22 分拉到了 33 分。
再看全部 26 对竞品
我把两家在 11 项品牌印象上的分数逐项对照,算出它们的平均分差。

结果从约 15 分变成了约 18 分。看上去只多了 3 分,放回原来的间距里看,相当于两家的差距又扩大了约五分之一。
26 对里有 25 对的分差都变得更大。
我还加了一组对照实验,想排除另一种可能:会不会只要问题里多出现一个品牌,AI 就会自动改分,不管它是不是竞品?
于是我把问题里的竞品换成了一个完全不相关的品牌,其他要求一点没变。
如果变化只是因为「题目里多了个品牌」,那这时候也应该出现类似的分差扩大…… 结果并没有。
这个对照反而让竞品的作用更清晰了:只有两个品牌原本就有竞争关系,再进入明确比较的语境,AI 才更容易把原有的区别描得更重。
判断 AI 有没有改口,先看这把秤会不会自己跳
四个模型里,文心换了问法以后改分最多,平均变化 3.77 分,豆包是 3.13 分,千问 2.72 分,元宝 2.27 分。
那是不是说文心最容易被竞品影响?还不能这么早下结论。
就像称苹果以前,得先看看秤空着的时候会不会自己「跳数」。
我把原来的问题一个字不改,再问一遍。结果文心同题重答时,平均就会相差 4.44 分。另外三家的同题波动在 2.5 到 2.94 分之间。

换句话说,文心看上去改得最多,但它原样重答同一道题时,本来就比另外三家更容易波动。我们看到的变化里,既有换问法的影响,也混着模型本身回答不稳定带来的误差。
所以只能说,文心的改分幅度更大。现有数据还不足以证明,它比另外三家更容易被竞品影响。
当然也要说一句:分数稳定也不等于答案更准,稳定和准确,本来就是两件事。
下次问 AI,多开两个新对话
现在越来越多人习惯问 AI 「这个牌子怎么样」「这两个哪个好」,一句话省掉半小时功课。
但这次实验告诉我们:你提问的方式,会直接影响答案的样子。
如果你想知道 AI 对一个品牌的评价「稳不稳」,可以挑一个自己熟悉的品牌做个小测试。
先开一个新对话,单独问它评价,再开一个新对话,把竞品放进问题里,其他要求全部照旧。要是发现某项评价变了,就把两种问法各重复几次。
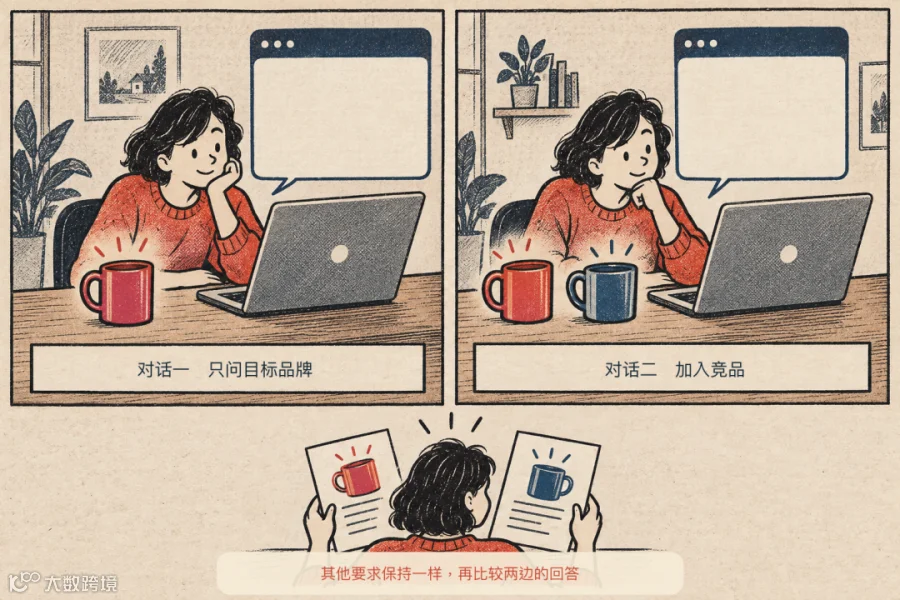
随后把两个品牌分别单独问一遍,再看比较题的答案。你会更容易分清:哪些印象是 AI 本来就有的,哪些特点是竞品出现以后才被「提亮」的。
做品牌的人也可以用同样的方法检查。单独介绍时拿到的好评价,到了比较场景里还剩多少?对手的分数又会往哪里动?两边一起看,才能知道 AI 有没有悄悄把品牌之间的距离拉大。
虽然几次回答撑不起普遍结论,但至少足够提醒我们一件事:AI 的评价会跟着问题里的参照对象发生变化。
AI 的答案,从你问出口的那一刻就开始移动了。
下次分享一张 AI 答案的截图,最好把问题也一起贴出来。
别人需要知道,你当时还提到了「谁」。
本文由“壹伴编辑器”提供技术支持
暗品牌 Lab 第 6 期
2026 年 9 月,76 个品牌组成 38 对配对,其中 26 对为有效直接竞品。四个模型计划回答 4560 次,取得 4213 次有效结果。每种问法计划重复三次,每次使用独立新对话,并关闭联网搜索和深度思考。缺失按预定规则处理,未补采。
单品牌变化与品牌距离使用 26 对有效直接竞品。四模型对照使用 22 对共同有效样本。前后变化先取重复评分的中位数,同题重复差异比较单次回答,两者口径不同,不能直接相减。模型差异另以随机重排作为参照,并校正多次比较。品牌距离与模型比较属于事后探索,仍需独立样本复验。
模型接口分别为 doubao-seed-2-0-pro-260215、qwen3.8-max-0902、hy3、ernie-5.1,温度均为 1.0。结果限于本次版本、设置和样本。采集内容为品牌印象评分,没有测自然语言推荐与购买行为,也不用于评价品牌实力和产品质量。