

2026年9月22日,OpenAI正式发布GPT-6 Sol和GPT-6 Luna。
GPT-6 Sol和Luna的API较GPT-5.6整体下调了50%,堪称性价比之王。

此外,还有一个值得关注的改进是幻觉率的下降,agent能力大幅度提升。
两款模型
GPT-6 Sol和Luna面向不同的使用场景进行了优化。
Sol定位为“日常主力模型”,专为复杂的编码任务和智能体(Agent)工作流设计。实现功能、调试问题、审查和重构代码、分析数据,并完成跨工具的多步骤工作流。

在OpenAI的内部事实性评估中,Sol的错误率约为GPT-5.6 Sol的一半。

Luna则是GPT-6家族中效率高的模型,面向高吞吐量、专注型的任务,它支持可调节的推理强度,以在质量、速度和单次请求成本之间取得平衡。
能力性能表现
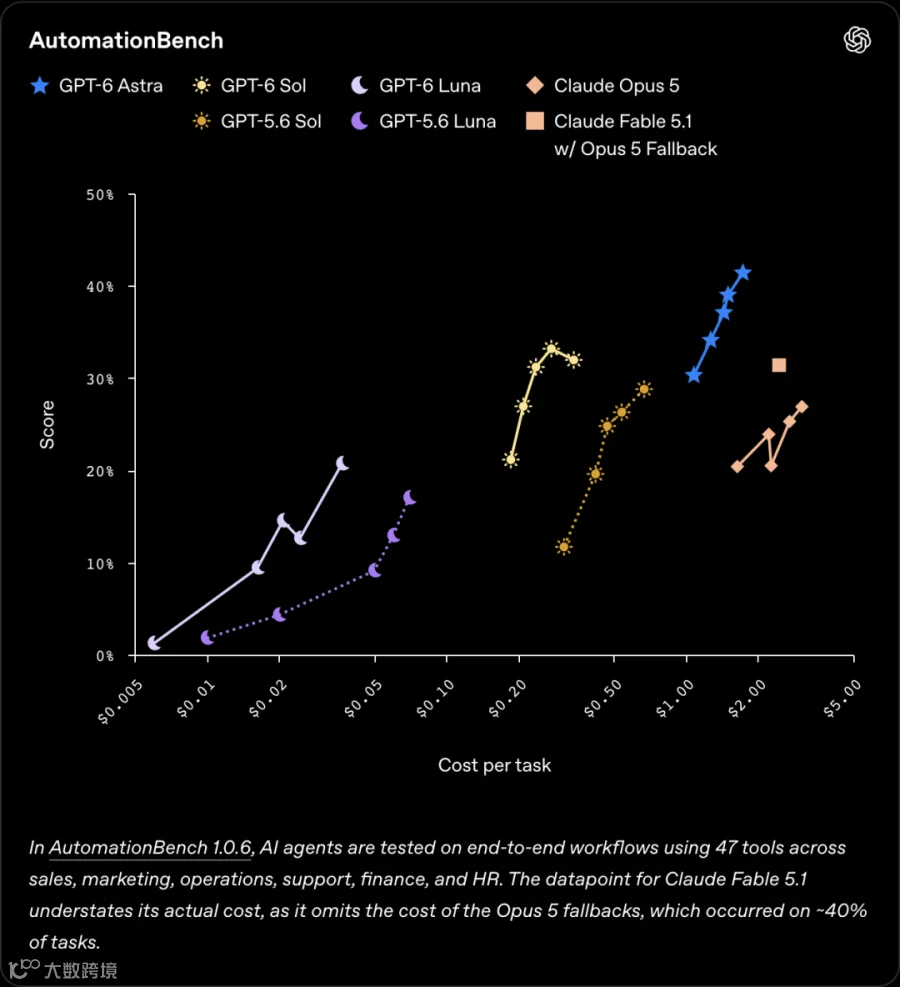
在AutomationBench跨应用业务流程测试中,GPT-6 Sol在xhigh强度下得分33.2%,单任务成本$0.27,超越了Claude Fable 5.1(max)的31.4%,且报告成本降低约88%。
在Agents' Last Exam智能体测试中,GPT-6 Sol在max effort下得分56.4%,高于Claude Opus 5在该评估中的最高分,单任务成本降低60%。

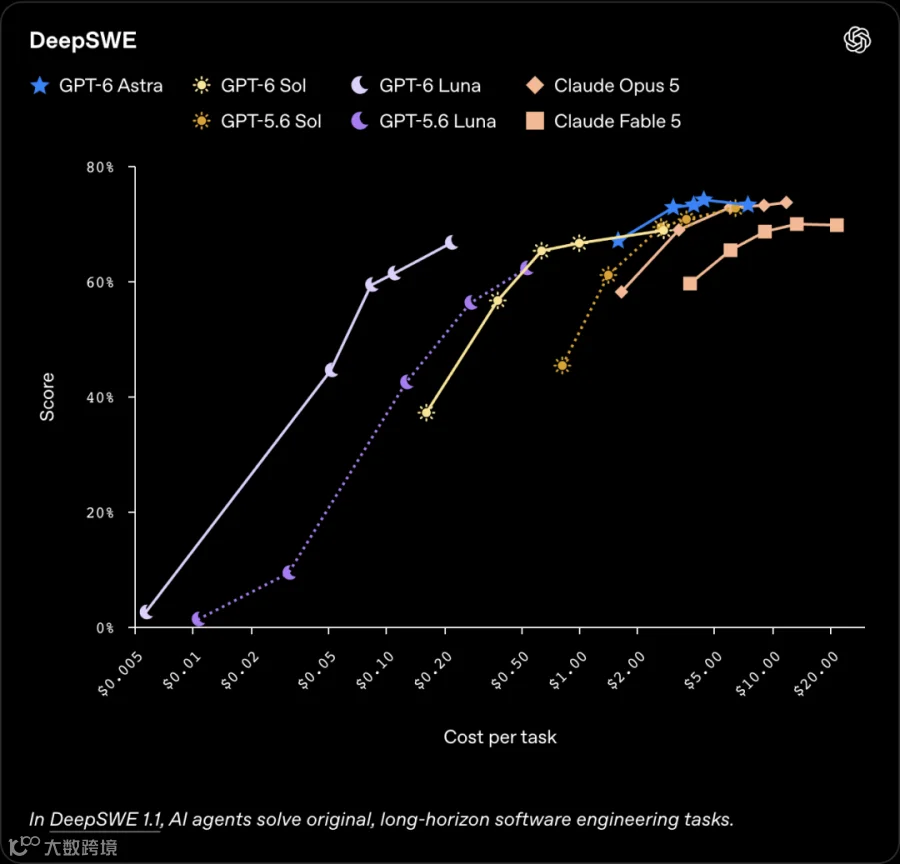
在DeepSWE v1.1软件工程测试中,GPT-6 Sol在max effort下取得68.8%,距离最高成绩仅差1.1个百分点,单任务成本低约80%。GPT-6 Luna取得66.6%,表现接近竞品的中等强度设置,同时成本低约93%至96%。
独立评测机构Artificial Analysis在其知识工作评估GDPval-AA v2.1中,GPT-6 Sol的Elo评分较前代下降了约100分,Luna下降了约75分,Luna在AA-Briefcase v1.1中也下降了约45分。

在编码智能体指数方面,Sol有所提升(从55分升至57分),而Luna则小幅回退(从43分降至41分)。
幻觉明显降低
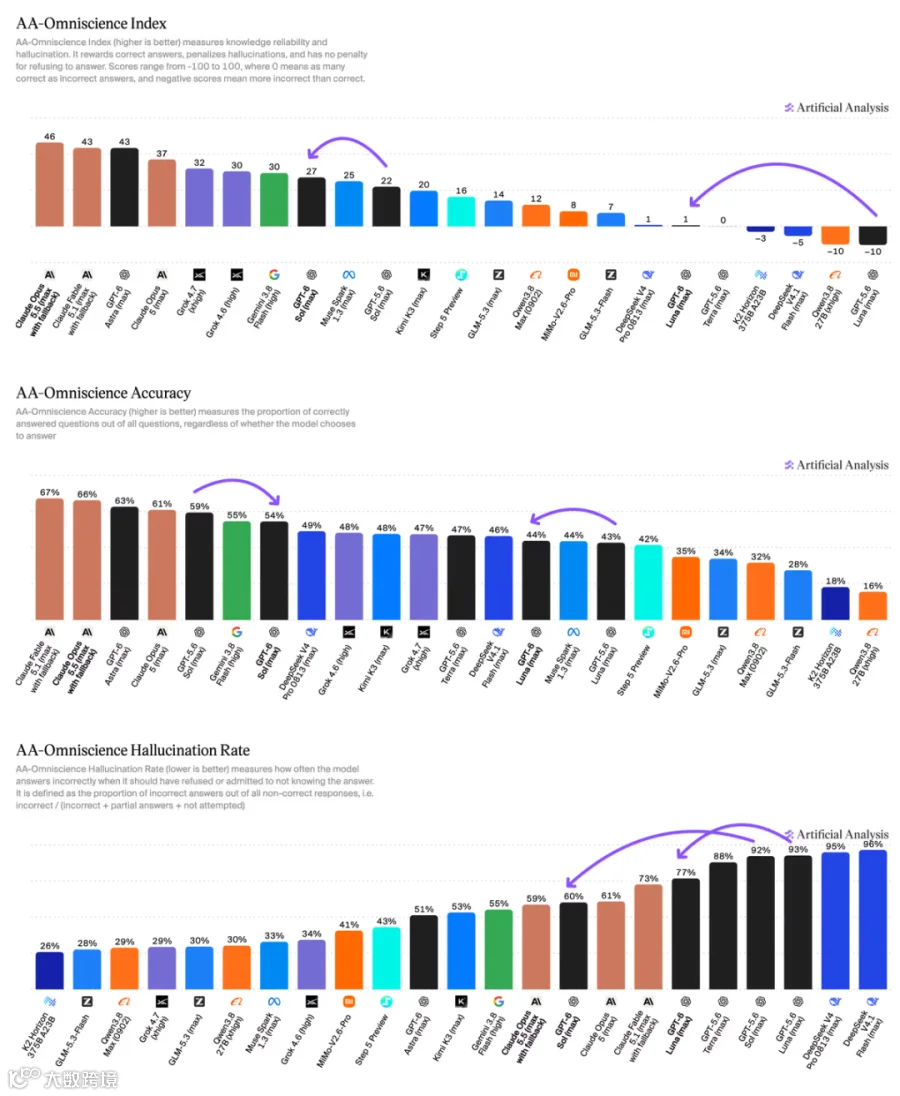
在AA-Omniscience知识基准测试中,GPT-6 Sol的幻觉率从GPT-5.6 Sol的92%降至60%,GPT-6 Luna从93%降至77%。

它的作答率从GPT-5.6 Sol的99%降至83%,错误答案减少了约四分之一,但准确率也从59%下降至54%。Luna的准确率基本持平(44% vs 43%),同时作答的问题数量有所减少。
用Sol构建,用Luna扩展。

华军软件园新媒体矩阵
关注我们


华军软件园
官方@官网

华军软件园
官方@知乎

华军软件园
官方@百家号

点点赞

点分享

点喜欢
2026年9月22日,OpenAI正式发布GPT-6 Sol和GPT-6 Luna。
GPT-6 Sol和Luna的API较GPT-5.6整体下调了50%,堪称性价比之王。
此外,还有一个值得关注的改进是幻觉率的下降,agent能力大幅度提升。
两款模型
GPT-6 Sol和Luna面向不同的使用场景进行了优化。
Sol定位为“日常主力模型”,专为复杂的编码任务和智能体(Agent)工作流设计。实现功能、调试问题、审查和重构代码、分析数据,并完成跨工具的多步骤工作流。
在OpenAI的内部事实性评估中,Sol的错误率约为GPT-5.6 Sol的一半。
Luna则是GPT-6家族中效率高的模型,面向高吞吐量、专注型的任务,它支持可调节的推理强度,以在质量、速度和单次请求成本之间取得平衡。
能力性能表现
在AutomationBench跨应用业务流程测试中,GPT-6 Sol在xhigh强度下得分33.2%,单任务成本$0.27,超越了Claude Fable 5.1(max)的31.4%,且报告成本降低约88%。
在Agents' Last Exam智能体测试中,GPT-6 Sol在max effort下得分56.4%,高于Claude Opus 5在该评估中的最高分,单任务成本降低60%。
在DeepSWE v1.1软件工程测试中,GPT-6 Sol在max effort下取得68.8%,距离最高成绩仅差1.1个百分点,单任务成本低约80%。GPT-6 Luna取得66.6%,表现接近竞品的中等强度设置,同时成本低约93%至96%。
独立评测机构Artificial Analysis在其知识工作评估GDPval-AA v2.1中,GPT-6 Sol的Elo评分较前代下降了约100分,Luna下降了约75分,Luna在AA-Briefcase v1.1中也下降了约45分。
在编码智能体指数方面,Sol有所提升(从55分升至57分),而Luna则小幅回退(从43分降至41分)。
幻觉明显降低
在AA-Omniscience知识基准测试中,GPT-6 Sol的幻觉率从GPT-5.6 Sol的92%降至60%,GPT-6 Luna从93%降至77%。
它的作答率从GPT-5.6 Sol的99%降至83%,错误答案减少了约四分之一,但准确率也从59%下降至54%。Luna的准确率基本持平(44% vs 43%),同时作答的问题数量有所减少。
用Sol构建,用Luna扩展。