然后,Qwen-Image 2.1此次的架构挺有趣,最值得关注的我认为不只是将 DiT 从此前约 20B 缩小到约 7B,而是重新设计了文本、参考图和目标图之间的信息流,这是它之所以可以快的一个重点地方。基于此,我认为一个新模型出来的时候,首要关注的应该是attention的输入以及该怎么做,弄懂了这里,基本上也就知道这个新模型新在哪儿了,也就知道该怎么样部署优化它了,在qwen image 2.1中,使用了和Qwen Image MMDiT不一样的单流 DiT,文本、参考图 latent、目标图 latent 拼成一条序列,有3点非常重要的特性:
1)使用 block-causal attention,而不是全双向注意力
3)跨denoise step缓存文本和参考图的 K/V,即prefix kv cache
Block-causal attention 和 t=0 条件调制决定了prefix不随去噪timestep变化,所以有了所谓的Prefix KV Cache这东西。Qwen-Image 2.1 的推理链路和过去的diffusion模型区别不大,依然由三部分组成:1.Qwen3-VL-8B 负责理解提示词和参考图语义 2.约 7B 参数的 DiT 负责图像去噪 3.VAE 负责像素与 latent 之间的转换。部署加速这个模型的要点,我个人认为重点有三点:piecewise attention,量化,prefix kv cache。
和纯文生图任务不同,编辑任务多了参考图,而且是很多张,参考图和文本和目标图怎么拼决定了attention怎么安排,本章以一个例子说明一下,参考图会同时经过 Qwen3-VL 和 VAE,两条路里面,Qwen3-VL 提取图像语义,理解图里有什么,以及提示词如何指代参考图;VAE latent 保留颜色、纹理、布局和透明通道等像素细节
1) Qwen3-VL:16 像素 patch,再经过 2×2 merger,得到 32×32=1024 个 vision token
2) VAE:16 倍下采样,得到 64×64=4096 个 latent token
注意两者数量不同,因此不能直接原地替换,所以Qwen3-VL 完成编码后,ComfyUI的做法是会删除输出中的 vision token,同时记录它们原来位于序列的什么位置,也就是 image_slots,DiT 随后在这些位置插入参考图的 VAE latent
[system][文本 A][vision token × 1024][文本 B]
删除 system 和 vision token:[文本 A][文本 B]         ↑ image_slot
DiT输入序列:[文本 A][参考图 latent × 4096][文本 B][目标 latent × 4096]
需要区分两种图像 token,被删除的是 Qwen3-VL 输出的 vision token;DiT 中做注意力的是 VAE latent token
[文本 token][目标图 latent]Block-Causal mask
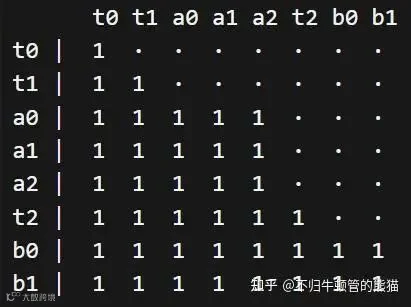
Qwen-Image 2.1 没有使用普通全双向注意力,也不是严格的逐 token causal attention,而是 block-causal attention,这个和图像编辑任务有关,它的注意力规则可以写成:
visible = (query_position >= key_position) or same_image_block
含义是,文本 token 按因果顺序向前看,每个图像块内部完全双向,一个图像块可以看到它之前的全部文本和图像,但不能看到它后面的内容,最后的目标图块可以看到整个条件前缀和完整的目标图块
[t0 t1][参考图 A][t2][目标图 B]
这种结构带来两个效果。第一,参考图和文本不能看到后面的目标图,因此条件侧不会被当前噪声目标污染。第二,目标图位于最后一个块,它仍然能够读取所有条件,并在自己的图像块内部进行双向注意力,不会损失图像建模所需的全局空间交互。分段注意力piece wise attn
知道了attention mask后,那我们就知道attention该怎么做了,最直接的实现方法是构造一个形状为 B×1×S×S 的布尔 mask,但多图编辑任务的序列长度可能达到上万 token,mask 的空间复杂度是 O(S²),计算量平方级上升,肯定会成为性能瓶颈。
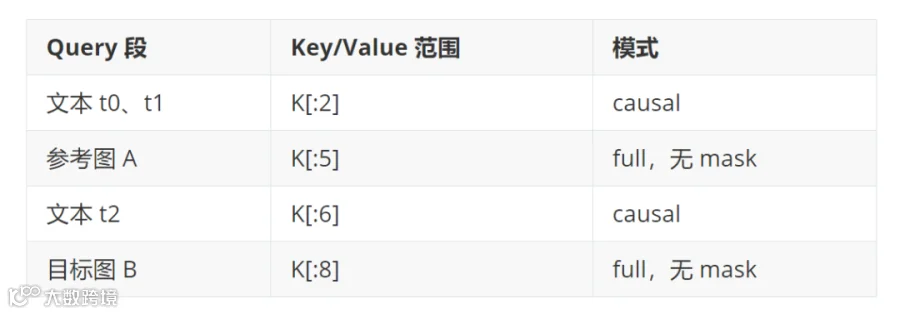
例如双参考图、1024×1024 目标图的序列长度大约为 12300,12300² ≈ 151M 个布尔值,一份 mask 就约占 151 MB,这显然性价比不行。我们注意到Qwen-Image 2.1 的 mask 有一个重要特点:那就是文本段是因果,图像段是dense full注意力。因此自然地可以想到把注意力拆成几段等价计算,前面的例子可以拆成:
图像段可以无 mask是因为对于图像块 [a,b) 内的 query,它应该看到自己之前的所有 token和自己图像块内的所有 token。
ComfyUI和vLLM-Omni都对qwen image 21做了非常迅速的day0支持,vllm omni搞了个 piecewise attention,即分段注意力
在 vLLM-Omni 的测试中,1024×1024、50 步、CFG 4、BF16、cuDNN 条件下:
注意到多图编辑的提升非常大,因为参考图编码后token数量远大于那么点文本token,参考图越多,序列越长,消除 O(S²) mask 的收益越明显。
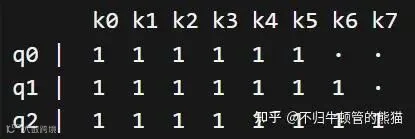
注意,分段 causal attention有一些坑点,比如文本段的 Q 长度通常小于 K/V 长度。例如某段文本有 3 个 query,但前面已经有 5 个 prefix token,于是Q 长度 = 3,K 长度 = 8
普通 SDPA 的 causal mask 默认左上对齐,会错误地变成:
整个前缀几乎都被切掉了,生成出来的图片肯定不符合预期,加点下面的代码可以得到期望的mask:
mask = torch.ones(q_len, kv_len).tril(kv_len - q_len)
由此符合了FlashAttention 的 causal 右下对齐约定,因此这下不管是casual还是full attn都可以直接兼容FA。
注意到qwen image 21中timestep=0,参考图和文本在不同去噪步骤中保持相同的输入状态,且使用共享时间步调制,目标图 token 使用当前采样时间步 t去噪,文本和参考图 token 固定使用 t=0不变,这也是和图像编辑任务的特点决定的。
h' = Norm(h) × (1 + scale(t))h = h + gate(t) × AttentionOrMLP(h')
整个模型只使用一份共享 modulation 投影,为所有 32 个 block 产生,分别是Attention scale,Attention gate,MLP scale,MLP gate
于是在t=0的前提下,条件prefix满足了2个性质:文本和参考图输入在整个采样过程中不变,以及Block-causal attention 保证它们看不到后面的目标图
由此,条件前缀在每一层的 hidden state、K 和 V 都不随去噪时间步变化,哎,这不就是是 Prefix KV Cache嘛。
第一次去噪时,模型处理[text + reference latents] + target latent,同时保存每一层条件前缀的 K/V。后续步骤不再重新运行文本和参考图 token,只处理目标图:Query = 当前目标 latent,Key/Value = cached prefix K/V + 当前目标 K/V
因为目标图是序列最后一个完整图像块,它可以看到所有 prefix 和整个目标块,所以 decode 阶段不再需要 mask 这个玩意了,直接变成一次完整注意力。如果采样 50 步,抽象为prefill和decode就是:第 1 步prefill,生成噪声预测并写入 prefix K/V。后 49 步:decode,只计算目标 token,一下子看得顺眼了,像极了LLM有木有
大概算一下kv cache占用,BF16 Prefix KV Cache 大致为2 × 层数 × batch × prefix token 数 × hidden size × 2 字节
对于 32 层、4096 维、一张 1024×1024 参考图约 4096 个 latent token:2 × 32 × 4096 × 4096 × 2 ≈ 2 GiB
这是每个 CFG 分支的量级,开启正负 CFG 后,还得x2。
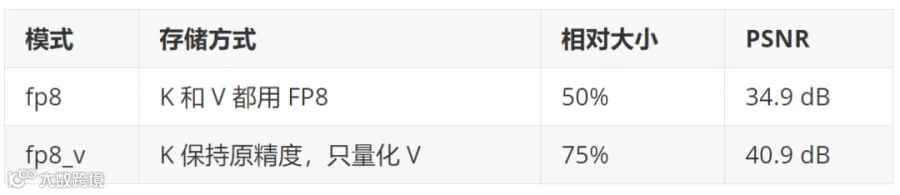
4G的kv cache对于7B的DiT占比还是非常大了,有必要量化一下了,将 Prefix KV Cache 量化为 FP8 E4M3,并为每个 token、每个 attention head 保存一个 FP32 scale,vllm omni里面支持了两种量化模式:
结果说明 K 明显比 V 敏感,因为K 已经应用 RoPE,它的误差会直接影响注意力权重和 token 之间的匹配关系,V 的误差主要影响加权后的内容,因此通常更容易容忍。所以只量化 V, 虽然只能节省约 25% 缓存,但比同时量化 K/V 提高约 6 dB,是更稳妥的trade off。
最后套用AI对qwen image 2.1的设计理解:Qwen-Image 2.1 的主线不是单纯增加参数,而是重新组织信息流
Qwen3-VL 负责理解文本和参考图语义 ↓文本 hidden state + 参考图 VAE latent ↓按 image_slots 拼成条件前缀 ↓Block-Causal Attention 条件只能向前看,图像块内部双向 ↓条件固定使用 t=0 调制 ↓条件 hidden state 和 K/V 跨步不变 ↓Prefix KV Cache ↓后续步骤只计算目标图 token
Block-causal attention 解决的是信息依赖;t=0 调制解决的是跨步骤稳定;Prefix KV Cache 将这两个结构性质转化为实际性能收益;分段注意力和量化则进一步降低 mask、计算和显存成本。
这也是 Qwen-Image 2.1 与普通全双向 DiT 最大的区别:它不是在推理阶段强行套用 LLM 的 KV Cache,而是在模型结构和训练阶段就创造了一个真正不变、可以精确缓存的条件前缀。