当一个 AI 已经读完需求、代码和埋点,它下一步最重要的能力,可能不是再写一千字分析,而是清楚地告诉系统:这件事能不能往下走。
2026.09 · 面向企业 Agent 与测试流程的一个观察
最近,Jev 在开发者圈子里很火。它不是又一个“更会聊天”的大模型,也不擅长给你写长文、写方案或陪你讨论问题。它做的事情很窄:给它一段状态和几个有限选项,它返回选择、分数或是非判断,同时给出概率和置信度。
听起来并不性感。甚至会有人问:这不就是一个分类器吗?
但恰恰是这个看起来不那么惊艳的方向,碰到了企业 Agent 最现实的问题:AI 已经很会分析了,可系统仍然不知道,什么时候可以相信它并继续执行。
一份“看起来很对”的报告,为什么仍然无法推进流程?
想象一个很常见的测试场景。
测试 Agent 拿到了需求、改动 Diff、关联代码和测试用例。它沿着入口、核心逻辑、状态变化、异常分支一路分析,最后输出一份两千字报告:这里可能有空指针,那里边界条件不完整,某个埋点参数似乎也有风险。
报告写得不差,甚至比很多人初步看代码更完整。但测试负责人真正要回答的不是“分析写得好不好”,而是三件更具体的事:

今天很多 Agent 卡在这里。它能生成结论,却很难对结论的边界负责。于是最终交付变成一句熟悉的话:“建议人工确认。”
这句话本身没有错。问题在于,如果十个结论都需要人工确认,Agent 只是把阅读成本从代码搬到了报告里。企业并不缺一份会写得很像人的分析,缺的是一套能够消化不确定性的流程。
Jev 让人关注的,不是速度,而是“交卷方式”
Jev 的思路可以简单理解为:不让模型自由写一段话,而是先把它可交付的答案限定好。比如只有“通过 / 风险 / Bug / 无法确认”四种状态;或者只允许在“自动推进 / 补充证据 / 人工判断”之间选择。
更重要的是,它不是只给一个结论,还会告诉系统这个结论有多大把握。置信度高,系统可以自动走下一步;置信度一般,就补查接口、代码或埋点;置信度低,则连同证据一起交给人。
过去我们让 AI 像人一样思考。接下来,企业更需要让 AI 像一个成熟的流程节点一样工作:能判断、能说明,也知道何时该停。
这不是说长文本模型没有价值。恰好相反,读需求、理解业务、追踪复杂调用链、解释异常原因,仍然需要 Claude、GPT 这一类模型的能力。Jev 真正提示我们的,是应该把 Agent 的工作拆开:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
很多团队做 Agent 时,第一层做得最热闹:工具越来越多,提示词越来越长,报告越来越漂亮。但第二层常常缺席。于是每一步都像一次单独的聊天,缺少可以被系统消费的结果。
对测试 Agent 来说,最值得借鉴的是“把结论变成状态”
测试天然不是一个只追求答案的工作,而是一个不断处理不确定性的工作。没有完整测试数据、没有线上数据库权限、接口不能真实调用、需求表述本身有歧义,这些都太常见了。
所以一个好的测试 Agent,不应该假装自己永远知道答案。它应该把“我知道什么、我不知道什么、接下来该怎么做”变成标准状态。

这两种输出,表面上只差几个字,对团队却完全不同。前者可以进入 Bug 验证和回归;后者应该驱动一次定向的证据补充。没有这层区分,报告里所有的“可能”“建议”“关注”最后都会堆到测试人员面前。
把这个思路放到你的测试流程里,会很清楚:
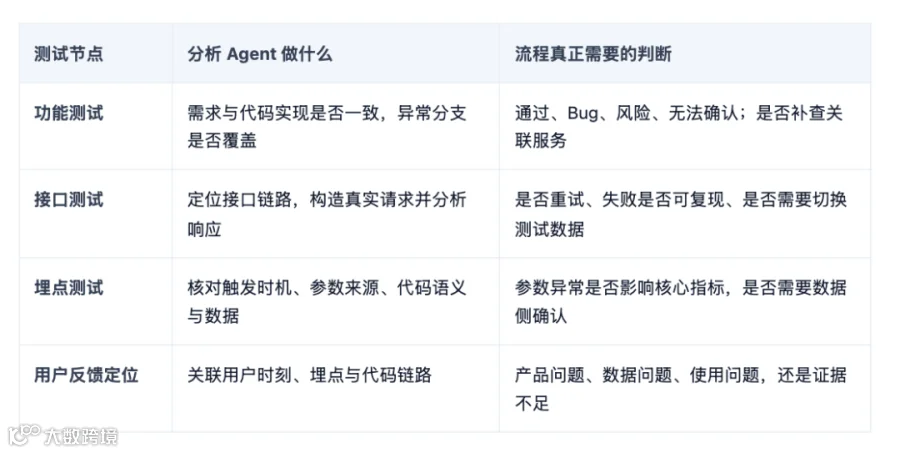
注意,这里最有价值的不是给每个节点加一个模型,而是让每个节点都交付统一的结果:结论、证据、置信度、下一步动作。这样功能测试的结果,才能被冒烟测试、回归测试、任务中心和结果中心继续使用,而不是停留在一份 Markdown 报告里。
“人负责判断”并不等于“人要看完所有结果”
在企业里推广测试 Agent,最容易被误解成“AI 要替人找 Bug”。这会天然引发抵触:它真的懂业务吗?错了谁负责?是不是要把测试人员替掉?
但从流程角度看,真正合理的分工不是替代,而是分层。
Agent 负责把大量重复的阅读、定位、关联和初步判断做掉;系统负责根据置信度和规则处理常规结果;人保留在真正需要业务经验的地方。人不是最后一道“兜底机器”,而是只处理那些值得自己花判断力的问题。
这反而会让测试人员的价值更清楚:不是花时间翻几十个文件确认一个明显遗漏,而是判断某个边界行为是不是产品意图、某个线上风险值不值得阻断、某个历史能力是否需要扩大回归。
所以,你此前提出的“每个测试节点由 Agent 先执行,人负责判断”是对的;但还可以再往前走一步:
不是所有 Agent 结果都交给人判断,而是让 Agent 先判断:这件事是否已经足够确定,可以不占用人的判断力。
也别高估它:决策模型不能替代复杂推理
Jev 的出现很容易让人产生一个误会:既然它快、便宜、输出稳定,那是不是以后都用它?不是。
它适合的是有限选项下的高频判断,比如分类、路由、评分、校验和转人工。它不适合独立理解一份复杂需求,更不能替代对跨服务代码链路的深入分析。测试里的根因定位、业务规则理解、异常场景推演,仍然是大模型和领域知识更擅长的部分。
真正可行的方向不是“换一个模型解决所有问题”,而是承认不同模型在流程中的职责不同。大模型负责看懂复杂世界;决策层负责让系统在有限边界内稳定地行动;人负责处理那些无法被规则、证据和概率完全覆盖的问题。
测试 Agent 的下一场竞争,不是报告写得多漂亮
过去一段时间,大家展示 Agent 时,常常展示它读了多少文件、调用了多少工具、写出了多长的报告。这些都能说明能力,但还不能说明它能进入生产流程。
真正能落到企业里的 Agent,应该回答四个更朴素的问题:这次结论是什么?证据在哪里?可信到什么程度?系统下一步该做什么?
Jev 火起来,背后真正值得关注的不是又多了一个模型名字,而是 AI 开始从“生成内容”走向“承担流程中的判断职责”。这正是 Agent 从演示走到工作的分水岭。