


社区、评论及私信功能中,敏感词过滤是必备的基础安全能力。本文介绍一套无扩展依赖、纯 PHP 实现且可直接上线的评论违禁词过滤方案:VicDict DFA 字典树过滤。
为什么推荐 VicDict?
- 纯 PHP 实现:无需编译 C 扩展,不依赖特定服务器环境,支持 Composer 一键安装。
- DFA 算法高效:基于确定有限自动机,单次遍历即可完成匹配,性能不受敏感词数量影响。
- 全量命中检测:一次性找出文本中所有违禁词,确保不漏检。
- 灵活策略:支持星号替换脱敏及风险分级(高危拦截、普通脱敏)。
- 二进制固化:预构建词典为二进制文件,线上请求直接加载,无需重复计算。
VicDict 核心过滤逻辑
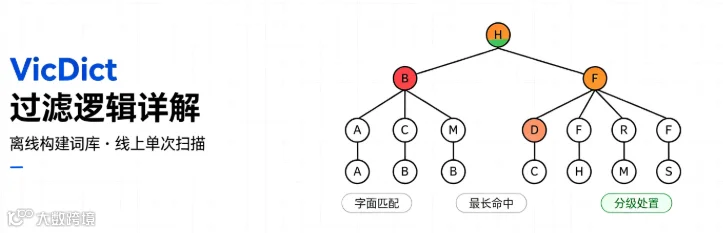
VicDict 底层采用 DFA 确定有限自动机(前缀字典树),流程分为“离线建库”与“线上检测”两个阶段。
离线阶段:构建字典树
提前录入违禁词生成树形结构,并固化为 .igb 二进制文件供线上直接加载。此过程极度消耗 CPU,严禁在接口请求中执行。
- 以根节点为起始,逐字符拆分敏感词。
- 相同前缀共享节点,有效节省内存。
- 词语末尾节点标记“词尾”及风险等级(高危/普通/广告)。
线上阶段:文本扫描匹配
用户提交内容后,系统从左至右单次遍历文本,无回溯操作:
- 字符匹配成功:进入子节点继续深度匹配。
- 命中词尾节点:记录违禁词、位置、长度及风险等级。
- 匹配中断:重置状态,从下一字符重新开始。
最终返回所有命中的敏感词,遵循“最长词优先”原则,确保精准无误。
脱敏替换逻辑
VicDict 先精准定位所有敏感词位置,再对用户原始文本进行星号替换,既完成过滤又不破坏正常内容格式。
必须配套的业务层逻辑
鉴于 VicDict 仅做纯字面匹配,为防绕过和误杀,需手动增加三层业务处理:
文本归一化(防符号绕过)
针对用户通过插入空格、特殊符号(如“垃 圾”、“垃*圾”、“垃 - 圾”)绕过检测的行为,需在预处理阶段统一清洗:
- 清除空格、换行及特殊分隔符。
- 将全角字符统一转换为半角。
注意:清洗后的文本仅用于检测,脱敏展示及数据库入库均应使用原文,以保障用户体验。
完整可上线落地代码
安装依赖
composer require lizhichao/word离线构建词库脚本
仅在更新词库时通过 CLI 执行,不可放入 Web 接口。
<?php
use Lizhichao\Word\VicDict;

$dictFile = __DIR__ . '/dict/sensitive.igb';
$dictDir = dirname($dictFile);
if (!is_dir($dictDir)) mkdir($dictDir, 0755, true);

$dict = new VicDict($dictFile);

// 违禁词库 1=高危拦截 2=普通脱敏
$sensitiveList = [
    ['word' => '违禁词 1', 'level' => 1],
    ['word' => '违禁词 2', 'level' => 1],
    ['word' => '垃圾', 'level' => 2],
    ['word' => '加微信', 'level' => 2],
];

foreach ($sensitiveList as $item) {
    $dict->add($item['word'], $item['level']);
}

$dict->save();
echo "词库构建成功\n";
通用过滤工具类
封装归一化、检测及白名单逻辑,可供全局调用。
<?php
namespace app\common;
use Lizhichao\Word\VicDict;

class SensitiveFilter
{
    protected string $dictPath;
    // 白名单短语
    protected array $whiteList = ['白名单词 1'];

    public function __construct()
    {
        $this->dictPath = root_path() . 'dict/sensitive.igb';
    }

    // 文本归一化清洗
    public function normalizeText(string $text): string
    {
        $text = preg_replace('/[ \t\n\r\*@#·\-_|【】]/u', '', $text);
        return mb_convert_kana($text, 'a');
    }

    // 核心检测方法
    public function check(string $originText): array
    {
        $originText = trim($originText);
        if (empty($originText)) {
            return ['hit' => false, 'highRisk' => false, 'hitWords' => [], 'safeText' => $originText];
        }

        $cleanText = $this->normalizeText($originText);
        $dict = new VicDict($this->dictPath);
        $hitResult = $dict->search($cleanText);

        if (empty($hitResult)) {
            return ['hit' => false, 'highRisk' => false, 'hitWords' => [], 'safeText' => $originText];
        }

        // 白名单放行
        foreach ($this->whiteList as $white) {
            if (str_contains($originText, $white)) {
                return ['hit' => false, 'highRisk' => false, 'hitWords' => [], 'safeText' => $originText];
            }
        }

        $hitWords = array_column($hitResult, 'word');
        $highRisk = !empty(array_filter($hitResult, fn($v) => $v['type'] === 1));
        $safeText = $dict->replace($originText, '*');

        return [
            'hit' => true,
            'highRisk' => $highRisk,
            'hitWords' => $hitWords,
            'safeText' => $safeText
        ];
    }
}
评论接口调用示例
<?php
namespace app\controller;
use app\common\SensitiveFilter;

class Comment
{
    public function add()
    {
        $content = trim(input('content', ''));
        $filter = new SensitiveFilter();
        $res = $filter->check($content);

        // 高危违禁词直接拦截
        if ($res['hit'] && $res['highRisk']) {
            return json(['code' => 0, 'msg' => '内容包含违禁词:' . implode(',', $res['hitWords'])]);
        }

        // 普通违禁词脱敏入库
        $saveContent = $res['hit'] ? $res['safeText'] : $content;

        // 此处执行评论入库逻辑...

        return json(['code' => 1, 'msg' => '发布成功']);
    }
}
避坑指南
- 禁止在线建库:严禁在接口循环中调用 add() 建词库,必须通过离线 CLI 构建。
- 后端校验必选:前端过滤易被篡改,后端必须进行二次校验。
- 复杂场景兜底:纯字面匹配无法识别拼音、谐音及形近字,复杂场景建议对接云审核 API。
- 合规留存:所有拦截行为必须记录日志,以满足监管合规要求。
- 高并发优化:高并发场景建议使用 Redis 缓存词库,减少文件 IO 开销。
VicDict 能以零成本、高性能拦截绝大部分明确违禁词。对于疑似内容及长文本,建议异步调用阿里云或百度内容审核 API,以识别谐音、暗语及深层语义违规。
#敏感词过滤 #DFA 算法