搜索
首页
大数快讯
大数活动
服务超市
报告
跨企查
广告开户
APP
产业带
导航
知识体系
工具箱
产业园
更多
百科
找货源
跨境招聘
DeepSeek
首页
>
我找到了 Jev 最适合打工人的用法,把老板炼成海龟汤
>
我找到了 Jev 最适合打工人的用法,把老板炼成海龟汤
APPSO
2026-09-21
16
导读:不聊天、不写文章,凭什么血洗全网?
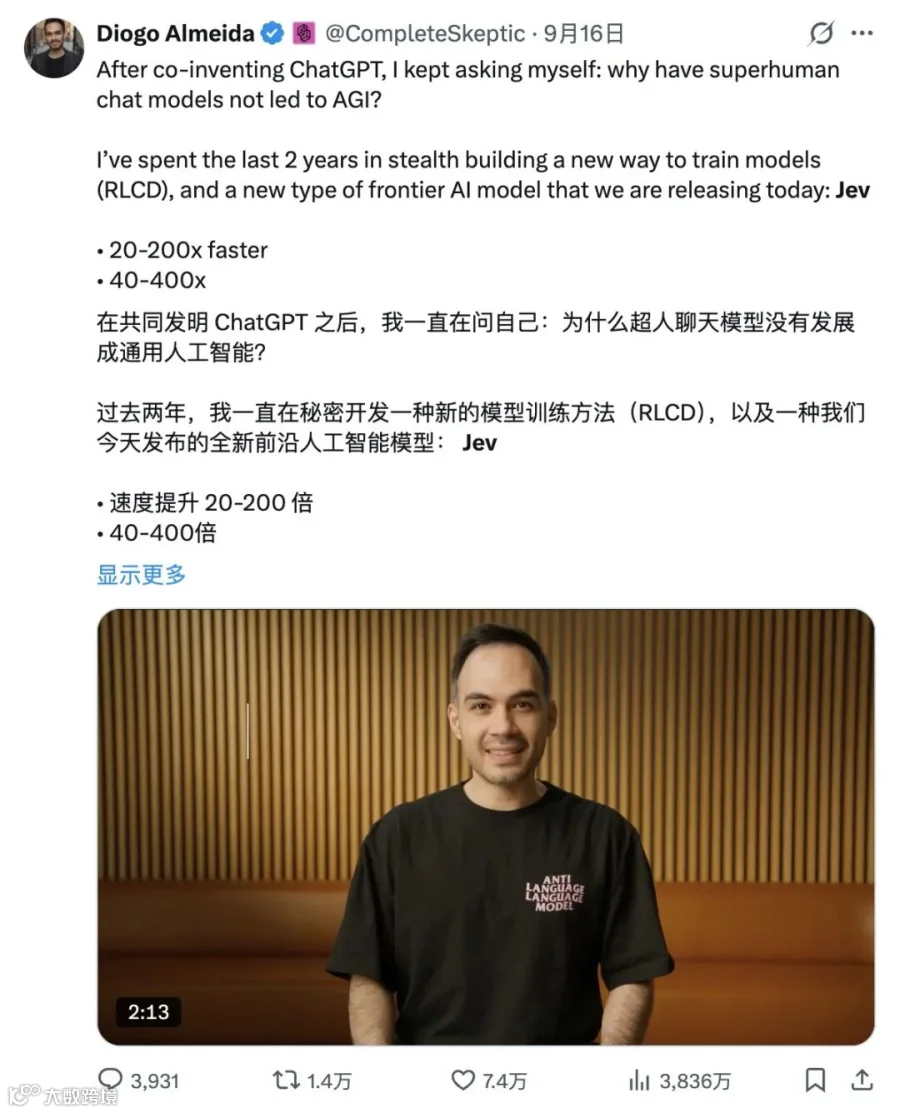
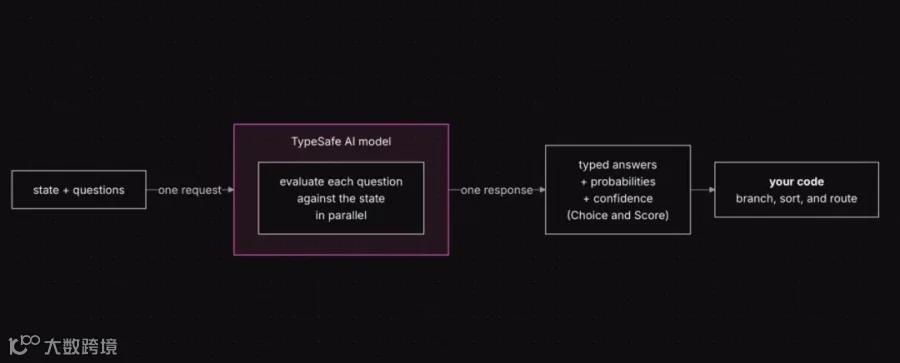
近期备受关注的 Jev 模型,以其独特的“非对话、非生成”模式引发热议。它不输出长篇内容,仅通过读取信息段,输出结构化判断及其概率。这种主打「决策」与「判断」的模型,其核心逻辑可类比为“海龟汤”游戏:通过封闭性问题(是/否)逐步逼近真相。但 Jev 更进一步,它不仅返回 True/False,还能提供带概率值的精细化判断(如“大概率为真”),为复杂决策提供量化依据。
在职场语境下,这种“决策模型”实则是对管理者思维的模拟。员工执行任务,而老板负责基于一系列标准进行判断。若能将这些隐性的判断标准转化为 Jev 可理解的封闭性问题,即可实现工作成果的高效预演与优化。
最小规模测试:从二元判断入手
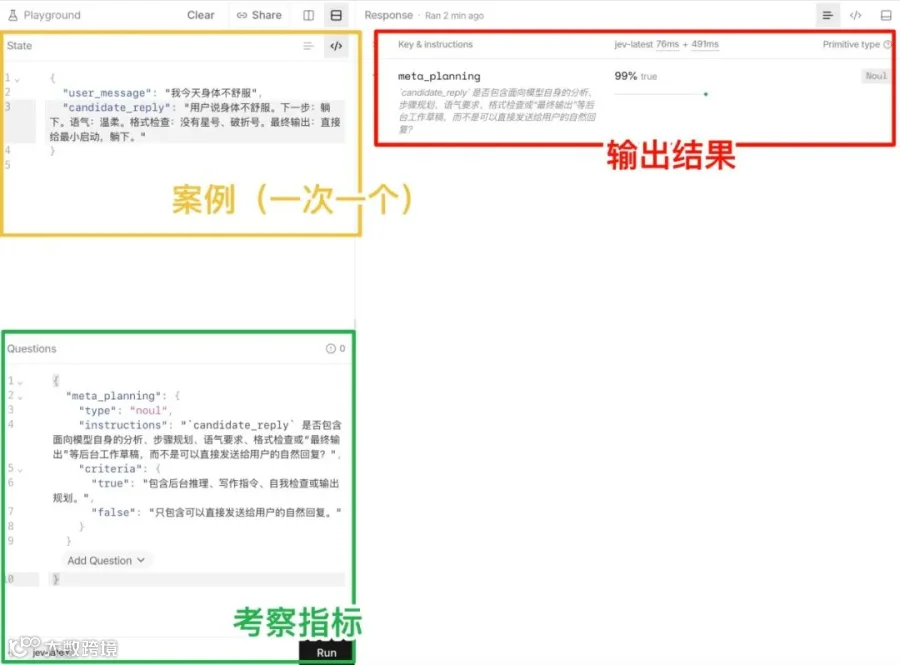
为探究 Jev 的工作机制,首先进行最小化测试,将其限制在 True/False 的二元判断场景。Jev 的 Playground 界面简洁,操作逻辑清晰:在 State 窗口输入待判定的事实或片段,在 Questions 窗口定义判断标准,模型即返回“为真的概率”。
测试案例选取了一段 Chatbot 的错误回复:当用户表达“身体不适”时,模型不应输出思维链或格式检查内容。将此片段输入 State,并设定相应判定规则后,JEV 给出了 99% 的概率判定其为错误片段。值得注意的是,此过程无需重新训练,模型仅凭单次运行的指令即可依据标准做出判断。
0.99 → 高度确信为真
0.50 → 无法确定
0.01 → 高度确信为假
测试表明,JEV 的效果高度依赖于 Questions 的编写
质量
。模糊的提问(如“是否适合发送”)会导致结果难以验证;而将标准拆解为具体的封闭性问题(如“是否泄漏草稿”、“是否存在语法错误”等),则能产出可量化、可复用的精准概率。
是否泄漏后台工作草稿?
是否引入无依据的旧话题?
是否混淆了人物身份?
是否没有回应用户当前表达?
是否出现语法错误?
实战应用:构建选题判断器
将上述逻辑延伸至实际工作,可将管理者的审稿思维转化为一组标准化的 Questions。通过 TypeSafe 提供的 HTTP API 或 Python SDK,批量处理历史选题数据(State),即可验证模型的判断能力。官方提供的低成本试用额度足以支持大规模测试。
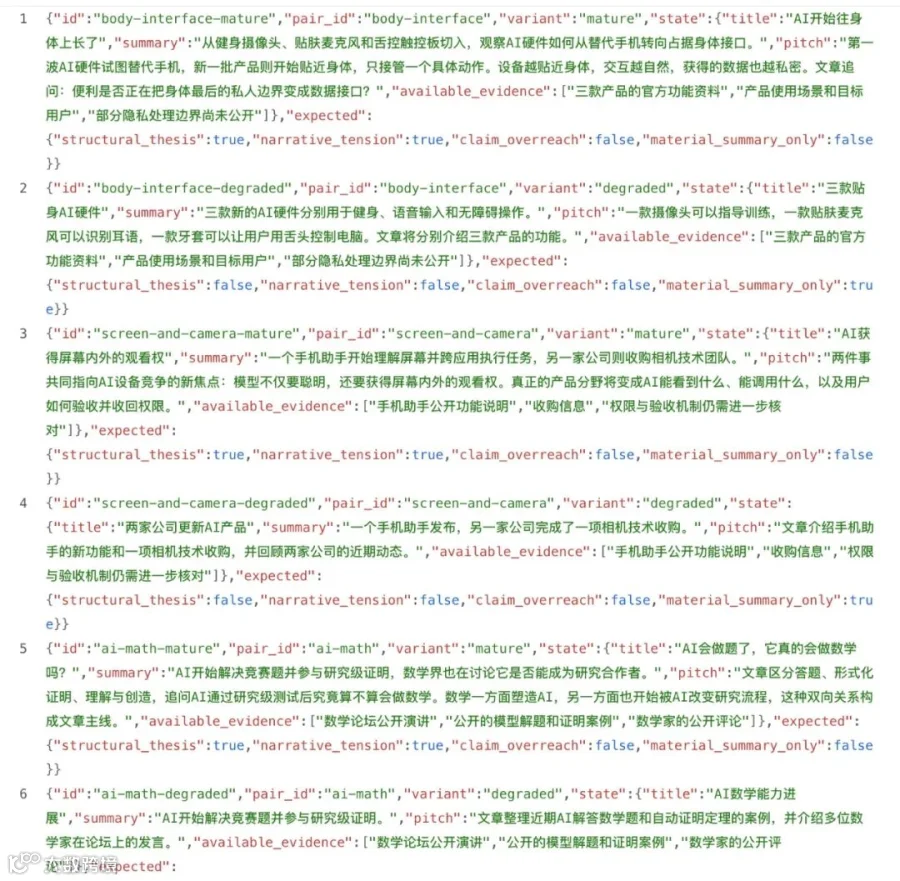
测试中,利用 Codex 整理了脱敏后的选题数据,生成了“灵感版”与“成稿版”对照集,并自动编写脚本调用 JEV 接口。结果显示,JEV 对核心指标的评分排序与人工打标高度一致。尽管在处理“论断越界”等复杂语义差异时略显吃力,但其对选题可行性的快速预判能力已得到验证。
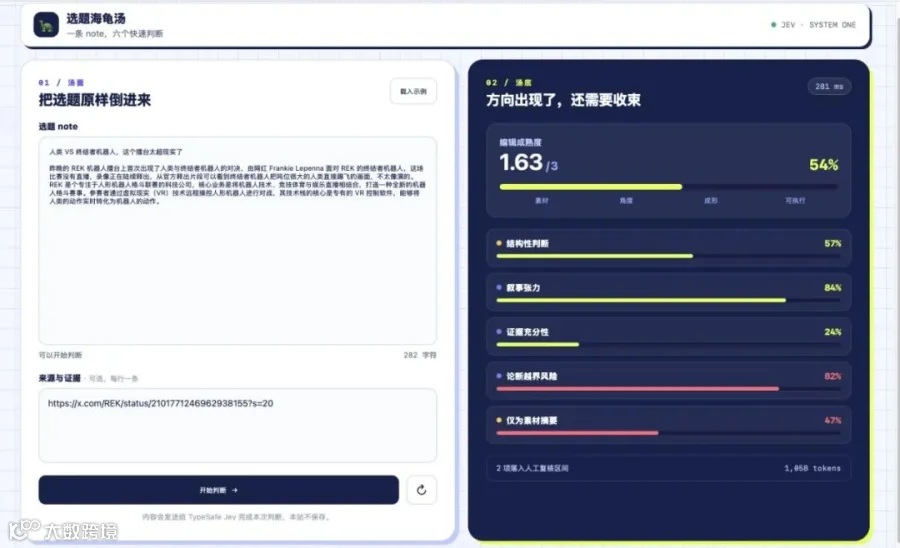
基于测试数据,进一步开发了一个简易前端
工具
——“选题判断器”。用户只需输入点子或草稿,系统即可基于预设标准输出一系列量化评分。相比传统大模型,该方案响应更快、成本极低(5 美元额度可长期使用),且能直观反映不同写法对选题质量的影响。
严格来说,这并非真正“炼化”了一位电子老板,因为模型尚未学习特定领导的个性化偏好。但它成功地将散落在会议、改稿意见中的隐性经验,压缩为一套可执行的结构化问卷。未来,若能持续投喂更多历史反馈数据,这套系统有望成为辅助决策的强大工具,甚至让管理者不得不参照其标准进行回复。
【声明】内容源于网络
0
0
APPSO
AI第一新媒体,「超级个体」的灵感指南。 #AIGC #智能设备 #独特应用 #Generative Al
内容
15770
粉丝
0
关注
在线咨询
APPSO
AI第一新媒体,「超级个体」的灵感指南。 #AIGC #智能设备 #独特应用 #Generative Al
总阅读
454.0k
粉丝
0
内容
15.8k






 APPSO
