搜索
首页
大数快讯
大数活动
服务超市
报告
跨企查
广告开户
APP
产业带
导航
知识体系
工具箱
产业园
更多
百科
找货源
跨境招聘
DeepSeek
首页
>
AI网络走到400G/lane,光学引擎开始贴着芯片部署
>
AI网络走到400G/lane,光学引擎开始贴着芯片部署
半导体产业报告
2026-09-22
16
导读:400G每通道逼近时,铜缆先失去的是距离,随后才是功耗余量。
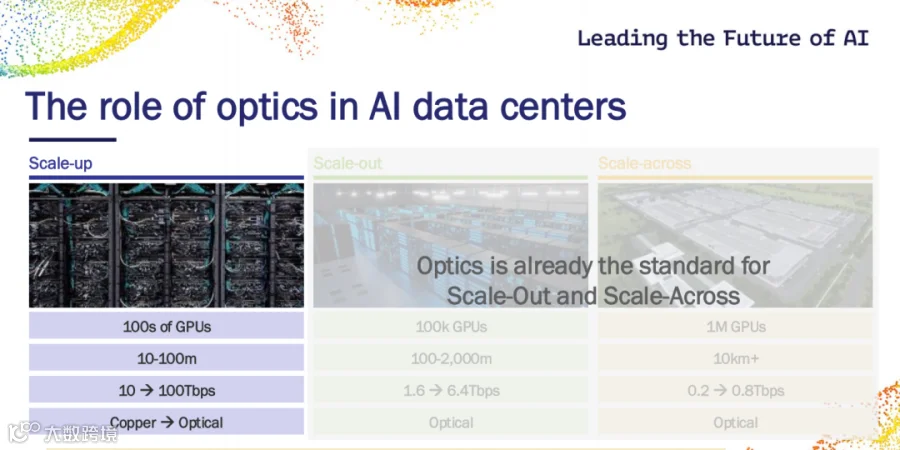
随着单通道速率向 400Gbps 演进,铜缆互连首先面临距离瓶颈,随后是功耗挑战。在由数十万颗 GPU 构成的 AI 集群中,光互连正从传统的跨机柜扩展(Scale-out)深入至芯片近端的规模扩展(Scale-up)。共封装光学(CPO)技术通过缩短高耗电的电信号传输路径,将封装、测试及维护等环节纳入系统级考量,成为突破算力网络瓶颈的关键。
01| 铜缆受限于距离,光互连切入 AI 集群核心
机架内 Scale-up 网络长期依赖铜缆,但在单通道 400Gbps 速率下,直连铜缆(DAC)难以跨越 2 米机柜,主动电缆(AEC)在连接两个机柜后功耗亦高于光纤。为满足数据中心低于 5pJ/bit 的功耗目标,铜链路不得不缩短传输距离并增加均衡补偿电路,导致能效下降。
光纤互连可将传输距离延伸至 500 米以上,单纤带宽超 10Tbps。当网络规模从数百颗 GPU 扩展至十万乃至百万级时,光互连在保障带宽密度、优化机柜布局及降低加速器数据等待成本方面展现出显著优势。
估算数据显示,铜互连下的 XPU 利用率约为 15%,而光网络可达 85%。长距离铜链路导致的信号衰减会迫使加速器频繁等待数据,从而严重损耗整体算力。
02| CPO 缩短电链路,显著降低均衡与重定时功耗
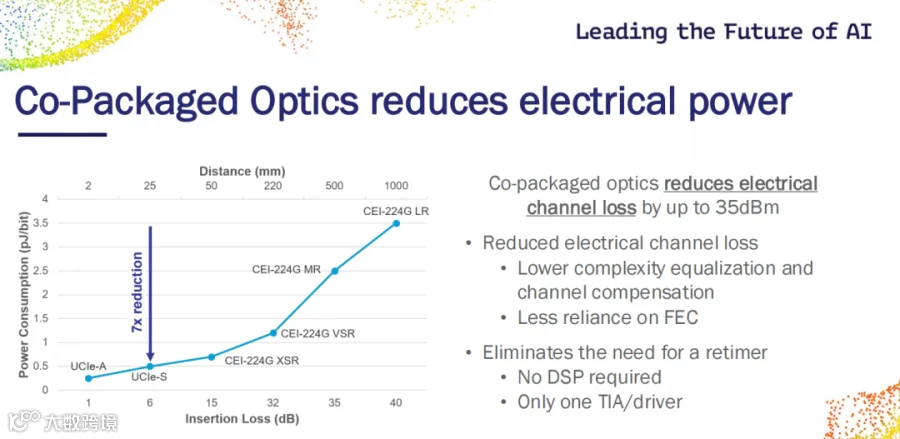
共封装光学(CPO)将电子芯片与光子芯片集成于同一封装内,大幅缩短高速电信号传输路径。此举有效降低了电通道插损,简化了均衡与信道补偿需求,减轻了前向纠错(FEC)负担,并有望移除链路中的重定时器(Retimer)和数字信号处理器(DSP)。
功耗对比显示,插损约 6dB 的近封装链路能耗低至 0.5pJ/bit,而传统 40dB 插损的 CEI-224G LR 链路高达 3.5pJ/bit,两者差距约 7 倍。节能主要源于更短的 PCB 路径减少了信号补偿、重定时及驱动长通道的能耗。
调制技术的演进同样影响功耗。相比 200Gbps PAM4,50Gbps NRZ 的误符号率低六个数量级,接收端
功率
需求降低约 5dB。通过降低单通道速率并利用多波长补充带宽,可减少均衡、FEC 及激光输入功率,但这对波分复用、滤波及封装内光路密度提出了更高要求。
03| 光学引擎集成化,重构成本模型与维护逻辑
CPO 架构将光学引擎紧邻交换芯片或 XPU,削弱了传统可插拔光模块的独立性。在该架构下,DSP Retimer、外置 MCU、存储及部分电源管理组件可被移除,激光器实现多通道共享,物料清单(BOM)成本预计压缩超 50%。但这要求光电协同封装、对准及测试必须同步完成。
运维模式随之变革。由于光学引擎与高功耗芯片绑定,现场无法像更换普通模块那样独立处理 CPO 单元。解决方案是将激光器设计为可现场维护模块(FRU),配合可拆卸光纤连接器。Meta 的可靠性测试表明,该方案在接近 5000 万小时运行中未出现明显性能衰减或链路闪断,实现了故障敏感部件的隔离与封装内光路的就近部署。
04| 量产前提:构建可测、可装、可换的光学引擎体系
封装厂需通过硅中介层或有机基板将电子 IC 与光子 IC 互联,并利用高密度互连技术接入光学引擎。关键在于光纤接头须在封装后支持拆装,避免因单一部件维护而更换整个系统。此外,每颗光子芯片在封装前必须完成严格的光电双重验证。
双面光电测试技术至关重要,其支持 200Gbps PAM4 光电测试、千路以上并行测试及晶圆级 224Gbps 误码率测试。唯有筛选出“已知良品”的光学引擎,封装厂才敢将其与昂贵的交换芯片或加速器进行共封装。
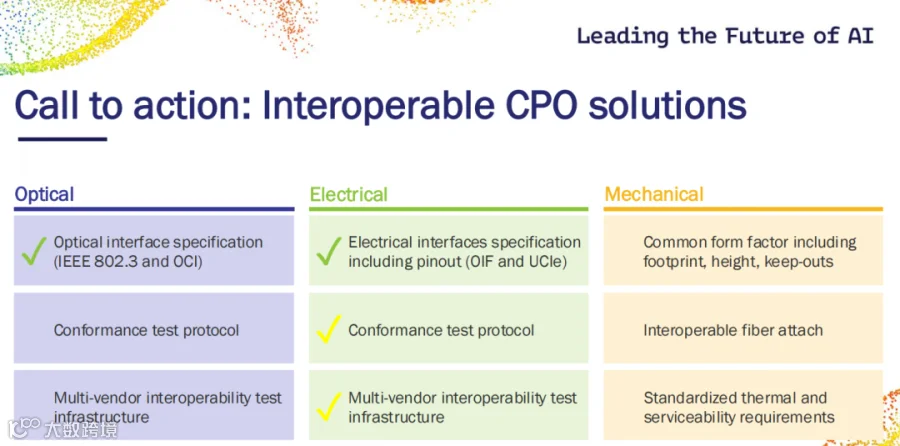
标准化进程加速推进:光接口遵循 IEEE 802.3 和 OCI 规范,电接口对接 OIF 与 UCIe。共封装后,外形尺寸、光纤连接、散热及可维护性亟需建立跨厂商的机械约束标准,以统一光路、电路与封装边界,避免装配现场的接口兼容难题。
结语:光进铜退,网络挑战转向封装制造
400G/lane 速率将铜缆推向距离与功耗的极限,而 CPO 技术则将光学引擎推至交换芯片身旁。其能效提升幅度取决于电链路的缩短程度,规模化部署则依赖于光子芯片的预封装测试良率、激光器与光纤的可维护性以及多供应商接口的标准化。随着光互连从网络边缘深入封装内部,制造端的成本与工艺挑战才刚刚拉开序幕。
【声明】内容源于网络
0
0
半导体产业报告
1234
内容
614
粉丝
1
关注
在线咨询
半导体产业报告
1234
总阅读
35.3k
粉丝
1
内容
614






 半导体产业报告