

TypeSafe AI 于 9 月 15 日发布全新模型 Jev,该模型不专注于长文本生成或对话交互,而是定位为软件流程中的“决策引擎”。Vercel 数据显示,Jev 接入 AI Gateway 后首个 24 小时内,近 13% 的付费团队已投入使用,创下该平台新模型最快采用纪录。
Jev 的核心定位:结构化决策而非内容生成
与传统大模型擅长撰写长篇回答不同,Jev 的核心功能是为软件提供快速、短小的逻辑判断。它将当前信息与有限选项输入模型,由模型输出最佳选择、风险评估或合规性概率。Jev 不负责执行点击、转账或发送邮件等后续动作,而是隐藏在产品流程中,专门处理大量高频、重复的判定任务。
需注意的是,官方虽承诺 Jev 的输出格式受预设类型约束,不会出现无法解析的乱码,但格式正确并不等同于判断准确。模型仍可能出现分类错误(如将投诉误判为表扬),因此在实际应用中,概率阈值设定与人工复核机制比演示效果更为关键。
开发者实战应用场景
发布数日以来,开发者已将 Jev 应用于多个具体场景,验证其在不同工作流中的决策能力。
企业文件自动化流转
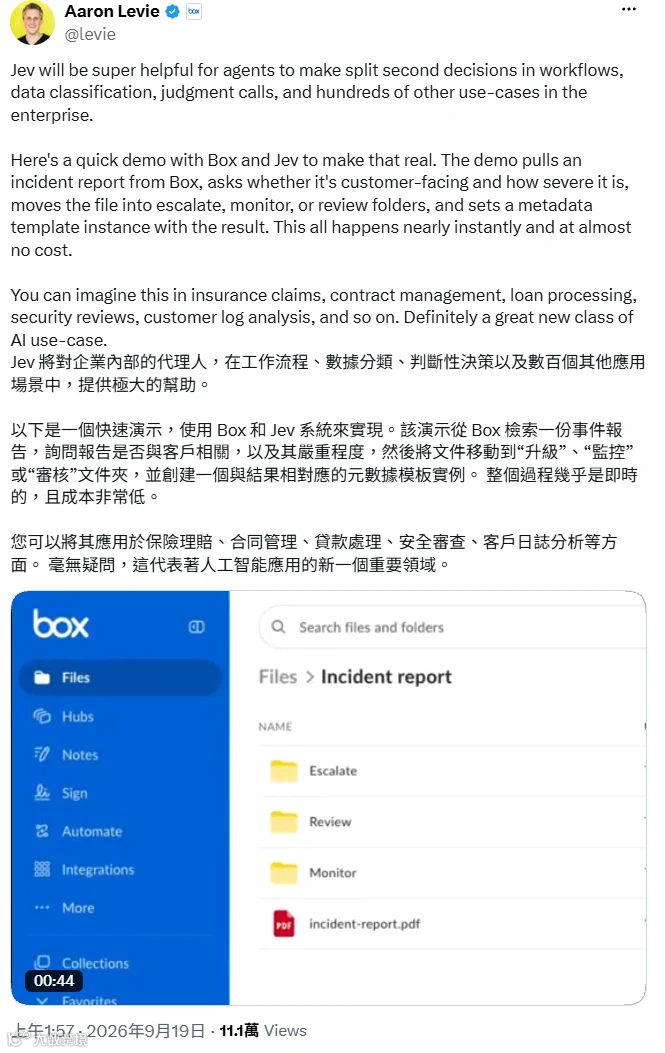
Box CEO Aaron Levie 演示了基于 Jev 的事故报告处理流程:系统提取报告内容后,由 Jev 判断是否影响客户及严重程度,进而驱动工作流将文件自动归档至升级、监控或复核文件夹。该原型展示了 AI 在“阅读文件后决定下一步流向”这一环节的判断力。
数据字段智能映射
Bannerbear 创始人展示了 Jev 在设计模板中的数据匹配能力。当设计模板字段(如photo、name)与数据源字段(如avatar、full_name)命名不一致时,Jev 可自动判断对应关系,替代繁琐的手动映射。虽然最终结果仍需用户确认,但该功能显著降低了“对号入座”过程中的出错率。
演讲幻灯片自动切换
日本开发者 Rinte 利用 Jev 实现了演讲辅助功能:系统实时识别语音话题,由 Jev 从预加载的幻灯片中选出最匹配的一页并触发切换。该应用本质是语音识别与页面渲染组件之外的“选择器”,将快速判断转化为直观的演示效果。

游戏实时状态决策
TypeSafe 团队测试了 Jev 在《毁灭战士》游戏中的表现:程序先将游戏状态转化为结构化文本,Jev 据此连续选择行动指令。官方坦言,Jev 并非直接识别画面,且在通关能力上不如传统游戏机器人。该案例的核心价值在于证明:只要判断速度足够快,AI 即可融入实时反馈循环。
商业邮件分类测试
Bryo AI 技术负责人使用 1565 封德语和英语供应商邮件进行测试,要求 Jev 将其分为 10 类。结果显示,Jev 整体准确率为 96.4%,略低于两款对照的 Gemini 模型;但在置信度达到 99% 及以上的 737 条结果中,分类完全正确。这表明企业可采用“高置信度自动分流、低置信度人工审核”的策略。需注意,测试包含 364 封合成邮件且未纳入附件分析,成绩不能直接等同于真实生产环境的上线标准。
技术启示与未来展望
上述案例虽场景各异,但底层逻辑一致:企业流程、演讲控制、游戏操作及邮件分流等场景,往往不需要大段文本生成,仅需一个及时、可供程序调用的明确判断。这种“语音模块负责听、应用负责执行、Jev 负责选、规则负责拦”的分工模式,不仅提升了效率,也使错误定位更加清晰。
Jev 目前仍处于早期开放阶段,多数案例仅为个人演示。开发者宣称的速度、成本及准确率优势需在各自样本中重新验证。特别是在事故处理、欺诈识别等高风险场景中,概率预测不能替代严格的审核与兜底机制。Jev 能否从短期的“尝鲜玩具”演变为企业长期采用的基础组件,将取决于其在真实工作流中的错误率、维护成本及用户留存表现。