

普通服务器通常以单台服务器为主要计算单元,CPU、内存、存储和网卡安装在一个机箱内,再通过数据中心网络连接更多服务器。AI服务器需要大量GPU同时计算,GPU之间还要持续交换数据,因此互连、供电和散热开始从单台服务器扩展到整个机柜。
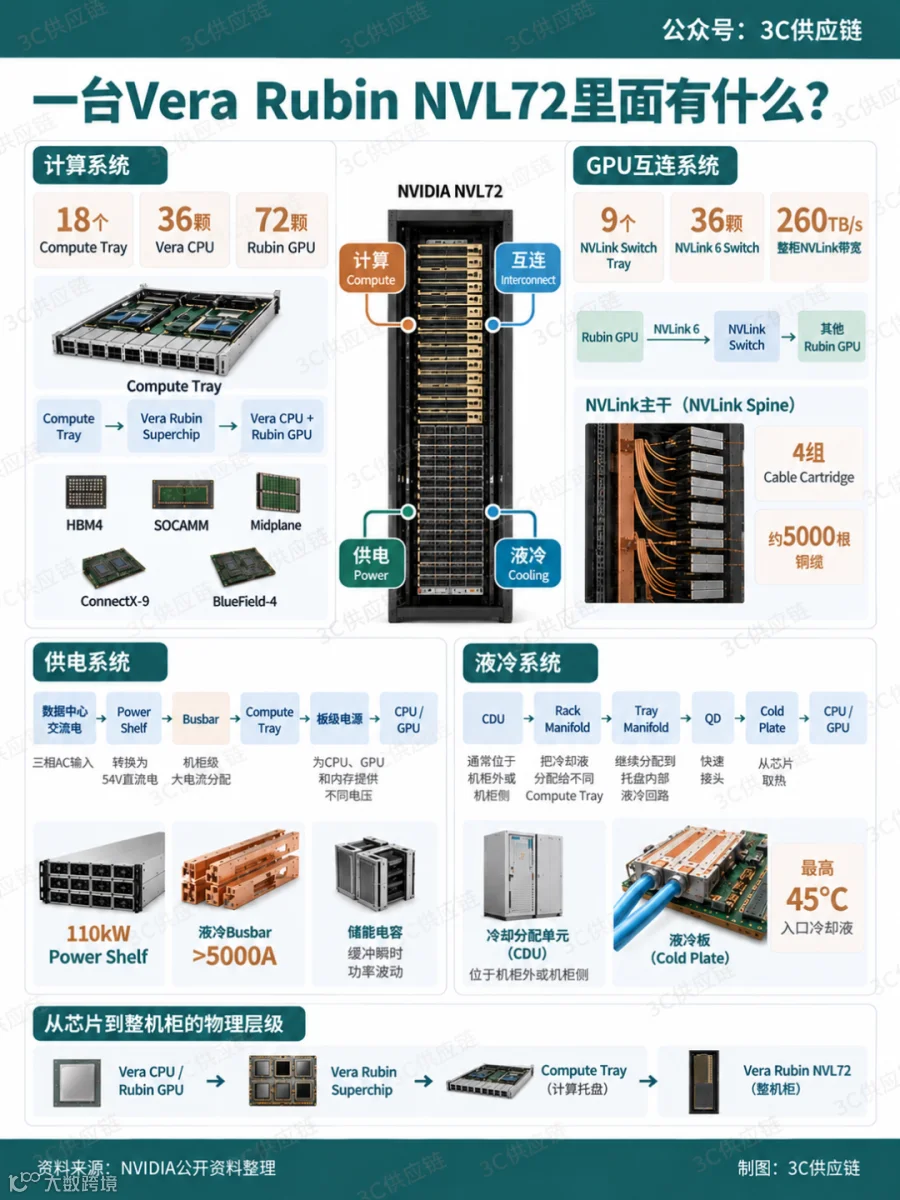
NVIDIA的NVL72就是这种机架级设计。72颗GPU先在一个机柜内组成高速互连系统,供电和液冷也围绕整柜配置。Vera Rubin目前已经进入全面量产,下面就从物理结构开始,看看一台Vera Rubin NVL72由哪些部分组成。
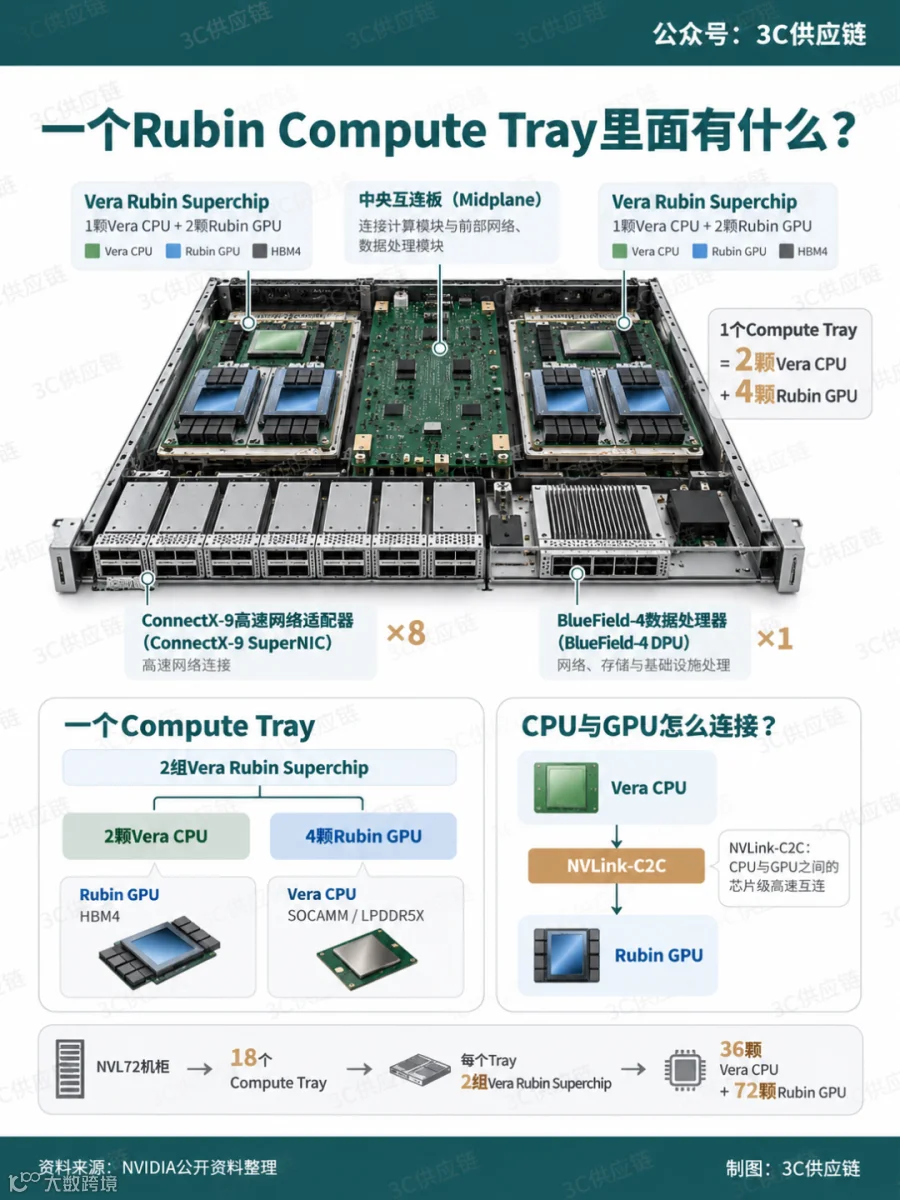
18个Compute Tray装下72颗GPU
Vera Rubin NVL72采用第三代NVIDIA MGX单宽机架,整柜包含18个计算托盘(Compute Tray)和9个NVLink交换托盘(NVLink Switch Tray),合计搭载36颗Vera CPU和72颗Rubin GPU。整柜约有130万个零部件、近1300颗芯片,重量约4000磅,约合1.8吨。
每个Compute Tray包含2组Vera Rubin超级芯片(Vera Rubin Superchip)。每组由1颗Vera CPU和2颗Rubin GPU组成,因此一个Compute Tray共有2颗Vera CPU和4颗Rubin GPU,18个托盘最终组成整柜的36颗CPU和72颗GPU。
整个计算部分可以沿着这条路径理解:NVL72机柜→18个Compute Tray→每个Tray 2组Vera Rubin Superchip→每组1颗Vera CPU+2颗Rubin GPU。
Vera CPU与两颗Rubin GPU之间通过第二代NVLink芯片间互连(NVLink-C2C)连接。NVLink-C2C解决的是同一组计算模块内部CPU与GPU之间的数据交换,而后文的NVLink 6负责更大范围的GPU互连。
内存也分成两套。Rubin GPU使用HBM4高带宽内存,单颗GPU最高配置288GB;Vera CPU则使用SOCAMM系统内存模块(Small Outline Compression Attached Memory Module),内部采用LPDDR5X。前者服务GPU计算,后者是CPU侧系统内存。
每个Compute Tray还配置8个ConnectX-9高速网络适配器(ConnectX-9 SuperNIC)和1个BlueField-4数据处理器(BlueField-4 DPU)。ConnectX-9负责高速计算网络连接,BlueField-4主要承担网络、存储、安全和基础设施相关的数据处理。
Compute Tray内部还有一块很重要的PCB——中央互连板(Midplane)。两组Vera Rubin计算模块通过Midplane连接到前部安装ConnectX-9和BlueField-4的模块化插槽,部分原本需要单独布线的内部连接因此直接通过PCB和连接器完成。
因此,Compute Tray内部的关系可以写成:
Vera CPU/Rubin GPU计算模块→Midplane→ConnectX-9、BlueField-4等前部模块
Midplane只位于Compute Tray内部,并不是一块贯穿整个NVL72机柜的大型背板。Rubin减少了托盘内部线缆,但整个机柜仍然使用大量高速铜缆。
72颗GPU通过NVLink连接起来
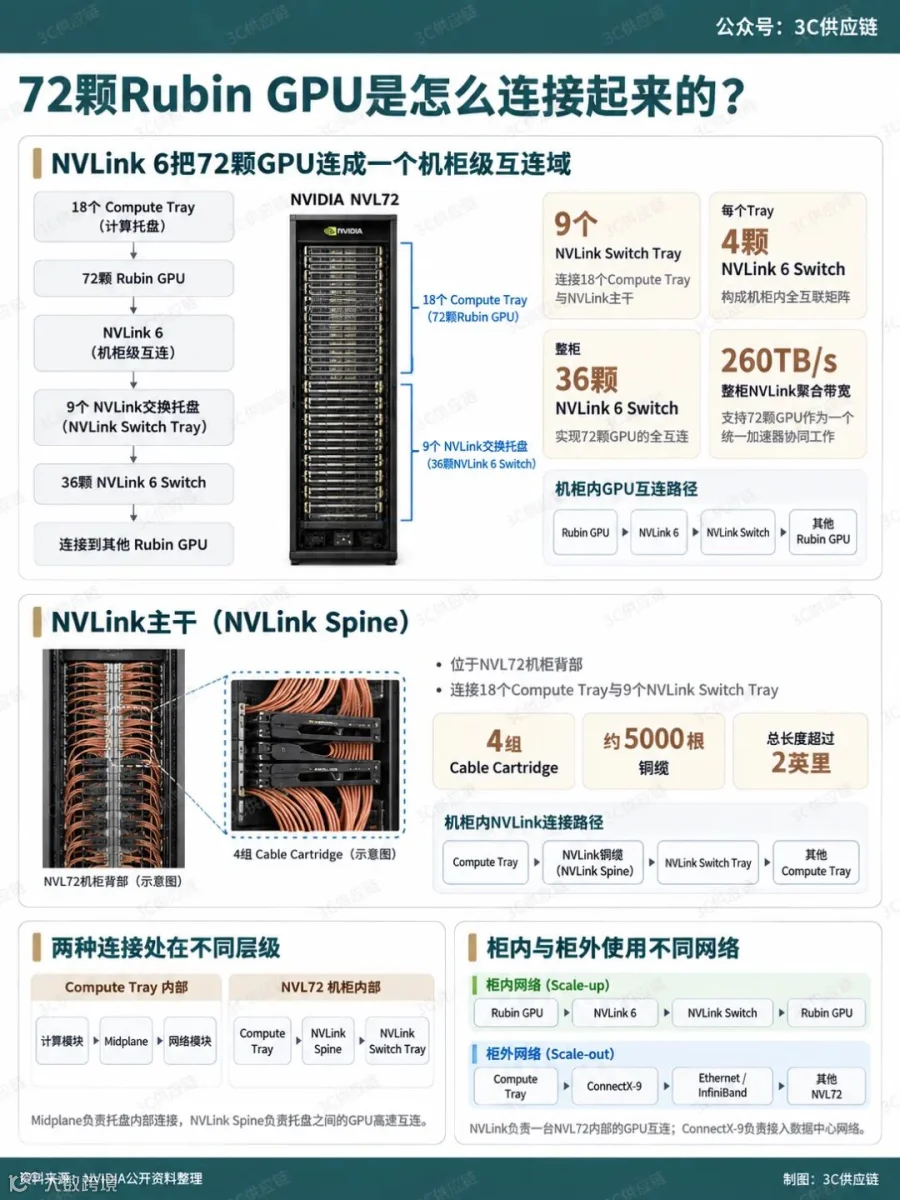
一块计算模块内部,Vera CPU与Rubin GPU之间使用NVLink-C2C;到了整个机柜,72颗Rubin GPU之间则使用第六代NVLink和NVLink Switch连接。
Vera Rubin NVL72共有9个NVLink交换托盘,每个托盘安装4颗NVLink 6 Switch,因此整柜共有36颗NVLink交换芯片。NVLink 6提供260TB/s的机柜级聚合带宽,让72颗GPU组成一个全互连的高速计算域。
GPU之间的数据路径可以写成:
Rubin GPU→NVLink 6→NVLink Switch→其他Rubin GPU
NVLink的物理连接主要位于机柜背部。Vera Rubin NVL72设置一套NVLink主干(NVLink Spine),由4组模块化预集成铜缆盒(Cable Cartridge)组成,内部约有5000根铜缆,总长度超过2英里,用于连接18个Compute Tray和9个NVLink Switch Tray。
因此,一台Rubin内部同时存在PCB和高速铜缆,两者负责不同层级的连接:
Compute Tray内部:计算模块→Midplane→网络等模块
NVL72机柜内部:Compute Tray→NVLink铜缆→NVLink Switch Tray
Midplane负责托盘内部连接,NVLink Spine负责计算托盘与交换托盘之间的机柜级高速互连。
NVLink Switch Tray本身也是一个独立的模块化单元。每个托盘内包含4颗NVLink 6 Switch,并支持维护模式下更换交换托盘,机柜可以在部分Switch Tray进入维护状态时继续运行。
NVLink解决的是一个NVL72内部72颗GPU之间的通信。多个NVL72之间则通过ConnectX-9接入Ethernet或InfiniBand数据中心网络,继续向外扩展。
两套网络的边界很清楚:
柜内:GPU→NVLink→NVSwitch→GPU
柜外:Compute Tray→ConnectX-9→Spectrum-X Ethernet或Quantum-X800 InfiniBand→其他NVL72
也就是说,NVLink负责机柜内部的GPU互连,ConnectX-9及外部交换网络负责多个机柜之间的数据传输。
电力从Power Shelf送到GPU
Vera Rubin NVL72的供电同样是一套机柜级系统。电力可以沿着一条路径理解:
数据中心交流电→电源架(Power Shelf)→铜母排(Busbar)→Compute Tray→板级电源→CPU/GPU
电源架(Power Shelf)负责AC-DC转换,把数据中心输入的交流电转换成机柜内部使用的直流电。
GTC2026公开的一套Rubin Power Shelf采用3RU、19英寸结构,总功率110kW,由6个18.3kW PSU组成,输入改为三相交流,直流输出由上一代的50V提高到54V。
转换后的直流电进入铜母排(Busbar)。Busbar可以理解为机柜内部的大电流电力主干,通过大截面积金属导体把电送到不同Compute Tray和其他模块。电力进入Compute Tray以后,再由板级电源转换成CPU、GPU、内存和网络芯片需要的不同电压。
第三代MGX机架的Busbar本身也进入液冷系统。NVIDIA公开的设计中,液冷铜母排(Liquid-Cooled Busbar)最高支持约5000A电流。
除了Power Shelf和Busbar,Rubin机柜还加入了机柜级储能电容。AI计算负载快速变化时,GPU功耗会在很短时间内升降,电容可以在瞬时功率上升时放电、负载下降时重新充电,减小机柜对上游电网的功率冲击。
NVIDIA将这套机制称为Intelligent Power Smoothing。Vera Rubin NVL72的机柜级储能按每颗GPU约400J配置,总储能能力约为前代的6倍。
因此,Rubin的主供电链条仍然是Power Shelf负责转换电力→Busbar负责分配电力→板级电源负责给芯片提供最终电压;机柜级储能电容则在旁边缓冲瞬时功率变化。

冷却液从机柜外流到CPU和GPU
Vera Rubin NVL72采用直接液冷,机柜冷却液最高入口设计温度为45°C。与电力系统一样,液冷也可以按照冷却液实际流向理解。
完整路径是:
冷却分配单元(Cooling Distribution Unit,CDU)→机柜液冷歧管(Rack Manifold)→托盘液冷歧管(Tray Manifold)→液冷快速接头(Quick Disconnect,QD)→液冷板(Cold Plate)→CPU/GPU
CDU通常位于NVL72机柜外部或机柜侧,用于驱动冷却液循环,并与数据中心侧冷却系统进行换热。机柜内部液冷部件和Side-car CDU在整机BOM中也通常分开计算。
冷却液进入NVL72后,先进入机柜液冷歧管(Rack Manifold)。Manifold相当于液冷系统里的分水器,把一条主管中的冷却液分配给不同Compute Tray。
进入Compute Tray后,再由托盘液冷歧管(Tray Manifold)继续将冷却液送往不同发热部件。第三代MGX机架使用新的内部Tray Manifold以及Rack UQD08 Manifold。
液路连接处使用液冷快速接头(Quick Disconnect,QD)。QD让Compute Tray在维护或更换时可以直接断开液路,而不需要重新拆装整套机柜管路。
最终,冷却液进入贴近Vera CPU、Rubin GPU以及其他高功耗器件的液冷板(Cold Plate)。芯片产生的热量经过Cold Plate传给冷却液,再由回水管路带出机柜。
从机柜内部看,电力和液冷实际上形成了两套并行的主干:
电力:Power Shelf→Busbar→Compute Tray→芯片
液冷:Rack Manifold→Tray Manifold→QD→Cold Plate→芯片
一套负责把电送进去,一套负责把热带出来。

从一台Rubin NVL72到Level 12
完成18个Compute Tray、9个NVLink Switch Tray、NVLink Spine、Power Shelf、Busbar、液冷管路及其他机柜组件的安装和验证后,一台Vera Rubin NVL72形成完整的机柜级计算系统。
在服务器制造和系统集成行业常见的划分中,L10通常对应完整服务器,L11进一步把服务器、交换设备、电源、液冷和线缆整合成可以部署的机柜级系统。一台完成整柜集成和测试的Vera Rubin NVL72可以放在L11层级理解。
再往上进入L12多机柜/集群级集成(Cluster-Level Integration),处理的对象不再是一台NVL72,而是多台机柜组成的完整AI集群。L12需要完成跨机柜Ethernet或InfiniBand网络、管理网络、操作系统、驱动和固件的一致化部署,并进行网络吞吐、GPU集体通信、存储性能以及长时间稳定性等集群级验证。
从L1到L12,服务器组装流程拆解