

导读TypeSafe AI 在 2026 年 9 月 15 日发布 Jev,并将它定义为一种面向软件自动化的 System One Model。它不生成自由文本,而是接收状态和类型化问题,直接返回选择、评分或概率。Jev 真正值得关注的地方,不是“又一个更便宜的大模型”,而是它提醒我们:Agent 的模型调用可以被拆成不同职责,复杂推理交给通用大模型,高频判断交给更快、更容易被程序接住的决策层。
本文 2588 字,阅读约 6 分钟|Agent 里有一类调用,本来就不该生成一段话 → Jev 做的不是生成,而是把问题变成可执行的选择 → 更像决策头的复兴,但不能据此断言 Jev 的底层架构 → 为什么决策模型可能比通用大模型更适合高频判断 → 真正的工程价值,是把“模型调用”拆成不同职责 → 开源复现说明了一件事,但还没有证明所有结论 → Jev 带来的启发,不是“以后都不用大模型了”
Agent 里有一类调用,本来就不该生成一段话
一个 Agent 处理工单时,可能要回答很多问题:这张工单应该交给哪个部门?紧急程度是多少?是否需要转人工?用户有没有流失风险?
这些问题看起来都需要“理解”,但不一定需要“写作”。程序最后往往只需要几个值:billing、urgent、true,或者一个 0 到 1 之间的概率。
传统做法是让通用大模型先生成一段 JSON,再由程序解析和校验。格式错了要重试,字段缺了要补救;模型完成了一次文本生成,程序最后却只拿走其中几个字段。
这就是 Jev 切入的问题:如果软件只需要一个判断,为什么还要让模型先写一段话,再把这段话解析回判断?
所以,Jev 的定位不是“更小的聊天模型”,而是 Agent 里的一个快判断层。TypeSafe AI 将它描述为一种“状态输入、类型化概率决策输出”的模型:输入可以是文本、工单或程序状态,输出则限定在软件预先定义的结构里。
Jev 做的不是生成,而是把问题变成可执行的选择
理解 Jev,关键在于把一次调用拆成三部分:状态、问题和答案空间。
 AI生成
比如,状态是一张退款工单;问题是“应该由哪个团队处理?”答案空间可以提前定义为 billing、support 和 sales。模型不需要自由发挥,只需要在这些选项里计算概率,并返回最可能的选项。
这和普通的分类器有相似之处,但 Jev 的接口更靠近 Agent 工作流。它不只回答单一标签,还可以在一次调用里处理不同形状的问题:
这三类固定的提问方式,可以理解为问题原语(Question Primitive):模型能够直接处理的最基础、最标准化的问题类型。复杂任务不能原样塞给 Jev,而要先拆成多个问题原语,再由程序组合结果。
choice:从有限选项中选择一个,例如路由到哪个部门;
score:按照有序尺度评分,例如把工单紧急程度分成几个等级;
noul:判断一个命题为真的概率,例如“是否需要转人工”。
这里的“类型化”很重要。程序在调用之前就知道答案应该是什么形状,模型输出可以直接进入后续的 if 判断、工具调用、人工升级或状态更新。
这并不意味着 Jev 永远不会错。它只是把“输出格式错误”和“判断内容错误”拆开了:前者可以通过类型约束减少,后者仍然需要用数据、评测和业务规则验证。没有自由文本,也不等于模型天然正确。
更像决策头的复兴,但不能据此断言 Jev 的底层架构
看到这里,很多人会产生一种熟悉感:这是不是 Encoder–Decoder 架构的文艺复兴?这个联想有启发,但不能直接当成架构结论。
经典的 Encoder–Decoder 通常是 Encoder 先理解输入,再由 Decoder 自回归地生成输出序列。Jev 的公开资料只说明了新的模型架构、并行采样和结构化决策输出,并未公开完整网络结构。因此,不能把 Jev 直接归类为 Encoder + Decision Head,也不能把社区复现当成 Jev 本体。
但从工程范式看,确实像是任务专用 Head 的回归:模型不再把所有能力都包装成自由文本,而是让受约束的输出模块直接服务代码。Laya 采用 ModernBERT Encoder + Decision Head,SemIf 则尝试在 Decoder-only 模型上读取候选 logits;两者共享的是决策接口,不代表 Jev 的内部实现。
所以更准确的说法是:不是 Encoder–Decoder 复兴,而是“结构化决策输出”重新成为模型工程的一等接口。它和早期分类器、排序模型、Reranker 以及自然语言推断模型相似,但试图把这些能力统一成 Agent 能调用的类型化接口,让分类结果直接成为工具调用、人工升级或状态更新的程序变量。
为什么决策模型可能比通用大模型更适合高频判断
TypeSafe 官方给出的差异主要有三层。
第一层是输出方式。通用大模型通常自回归地逐个生成 token;Jev 则围绕预定义的结构化答案并行产生结果,省掉生成解释、拼接 JSON 和解析重试等环节。
第二层是训练目标。通用模型主要优化人类偏好的文本输出,Jev 则强调经过校准的决策概率。重点不是“模型更会思考”,而是程序可以据此决定继续执行,还是转交更强模型或人工处理。
第三层是调用成本和延迟。TypeSafe 官方将 Jev 的输入价格写为每百万 token 0.042 美元,输出不单独收费,并给出 70 到 500 毫秒的端到端响应范围。这些是厂商口径,不能外推到所有硬件和任务,但能说明它优化的对象:单位时间里完成多少次可执行判断。
对 Agent 来说,这种差异会改变工作流的拆法。一个复杂任务可以先由通用大模型理解目标,再把高频、重复、候选空间明确的判断交给决策模型。决策模型的输出又可以触发工具、更新状态,必要时再把新的状态交回通用大模型。
真正的工程价值,是把“模型调用”拆成不同职责
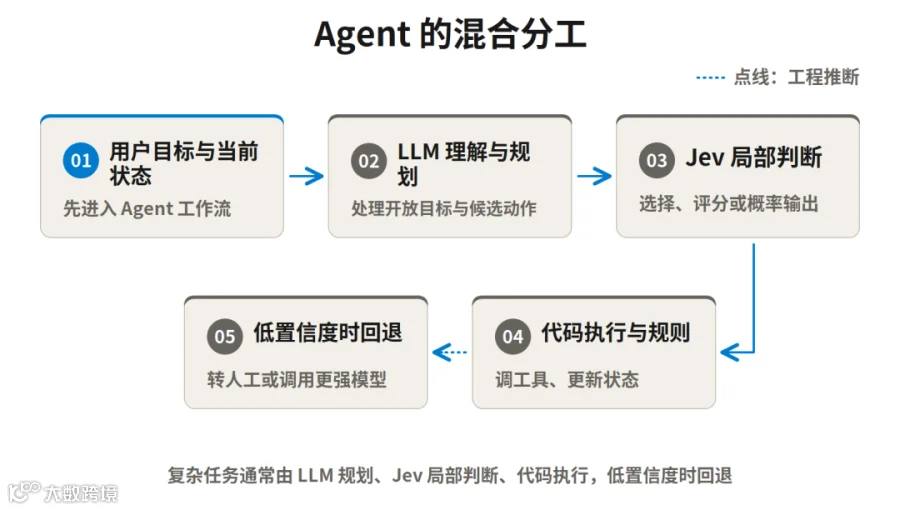
一个典型流程是:用户目标和当前状态先进入 Agent;Agent 生成候选动作;快判断层选择或评分;程序调用工具并更新状态;遇到复杂解释、开放式规划或异常情况时,再调用通用大模型。
这个流程里,Jev 不负责开放式写作,也不负责凭空制定复杂计划。它更像插在代码与通用模型之间的控制面,回答“下一步是否做”“选哪一个”“要不要升级”。
因此,少部分边界清楚、输出类型固定的窄任务,可以单独使用 Jev,例如工单分类、风险分级、垃圾信息判断、是否转人工或是否触发重试。更复杂的业务通常还是需要 Jev 与通用 LLM、规则系统或人工流程配合:LLM 负责理解目标、规划和生成,Jev 负责局部判断,代码负责执行和回退。
因此,判断一个任务是否适合决策模型,可以先问四个问题:
1. 答案空间能不能提前定义?如果选项本身还没有边界,模型就没有稳定的决策空间。
2. 程序是否只需要结果,不需要一段解释?如果解释本身是产品价值,仍应保留生成式模型。
3. 这个判断是否高频、重复,并且会明显影响延迟或成本?低频任务未必值得增加一层架构。
4. 错误时有没有回退路径?概率低不代表风险为零,关键动作必须能够转人工、重试或交给更强模型。
这四个问题比“Jev 能不能做某个 Demo”更重要。Demo 展示能力,工程设计要判断的是:它能否成为系统里的稳定组件。
开源复现说明了一件事,但还没有证明所有结论
Jev 发布后,社区很快出现了兼容接口或类似思路的开源项目。Laya 公开了 choice、score 和 noul,并提供代码、权重和本地部署路线;SemIf 则明确说明,它只复现“从开源模型读取类型化决策”的接口模式,不复现 Jev 的模型和训练方法。
这类项目降低了开发者尝试决策层的门槛。需要注意的是,Jev 是 TypeSafe 的托管服务,Laya 是独立的开源路线;它们的模型、训练数据和训练方法并不相同。对于不能把业务状态发送到外部 API,或希望自己控制推理环境的团队,Laya 提供的是一种替代性验证入口,不是 Jev 的开源版本。
开源接口、模型权重和官方服务不是同一件事。不同模型的训练数据、校准方式、语言覆盖、选项数量和上下文长度都可能不同;仓库里的速度和准确率,也只能在对应的硬件、数据集和测试协议下成立,不能简单改写成“开源版已经全面超过 Jev”。
这也是目前最容易被忽略的边界:决策模型的价值不只在于更快,还在于概率是否可靠、错误是否可解释、模型是否适合你的业务分布。一个在公开基准上很快的模型,面对真实工单、中文业务文本或长状态输入,仍然需要重新评测和校准。
模型与代码:
Laya: https://github.com/receptron/laya
SemIf: https://github.com/theoleecj/semif
Jev 带来的启发,不是“以后都不用大模型了”
如果把 Agent 看成软件系统,通用大模型只是其中一种能力,不应该承担所有判断。
通用模型擅长处理开放问题:理解模糊目标、组织长文本、规划未知步骤、解释为什么这样做。决策模型擅长处理边界更清楚的问题:从有限动作中选择、给风险分级、判断是否触发下一步流程。两者不是简单的替代关系,而是职责分工。
Jev 仍处在早期阶段,官方披露的性能和成本也需要更多独立测试验证。但它提出的问题已经足够具体:当代码最后只需要一个布尔值、一个等级或一个动作时,我们是否还在为一段完整的生成文本付费?这可能会影响下一代 Agent 的架构分工。
参考资料
TypeSafe AI:Introducing System One Models & Jev https://typesafe.ai/blog/introducing-system-one-models-and-jev
TypeSafe AI 文档 https://docs.typesafe.ai/
Laya 开源仓库 https://github.com/receptron/laya
Laya 模型仓库 https://github.com/NandhaKishorM/laya
SemIf 开源仓库 https://github.com/theoleecj/semif
— THE END —
文章仅做学术分享,如有侵权请联系删除,非常感谢!