今天,我们很高兴开源 Qwen-Image-2.1,一个兼顾生成效果、推理效率与使用成本的图像模型。Qwen-Image-2.1 将文生图与图像编辑整合在同一模型中,视觉生成部分仅有 7B 参数,并原生支持透明图像的生成与编辑。
本次更新的模型主要特色包括四个方面:
小模强效,极致价比:
轻量的模型结构与推理优化,在生成质量和计算成本之间取得平衡。
原生透明,创改一体:
根据提示词生成普通图像或透明图像,并支持透明图层编辑与抠图。
全能编辑,多局保全:
支持最多 10 张参考图,增强局部编辑、人像与商品保真,并覆盖多种编辑任务。
真实质感,字雅人美:
提升文字排版、人物光影与细节表现,让生成结果更具美感。
小模强效,极致价比
Qwen-Image-2.1 采用轻量简洁的模型结构,视觉生成部分包含 32 层 Single-Stream DiT,参数量为 7B。在较小的模型规模下,Qwen-Image-2.1 依然具备出色的图像生成能力。下方的 Qwen-Image-Bench 公开评测对比展示了它与其他开源、闭源模型的表现。

Qwen-Image-Bench公开评测对比
除了生成效果,Qwen-Image-2.1 也着重优化了推理效率,优势在多图输入场景中尤其明显。这一优化来自混合粒度注意力结构。模型对文本和图像采用不同的处理策略:文本部分,包括系统前缀和编辑指令,采用 Token 级因果掩码;图像生成部分采用 Chunk 级掩码。同时,通过 KV Cache 复用机制,模型将输入图像与编辑指令作为静态上下文,在首步预计算并缓存,以提升推理效率、降低显存开销。
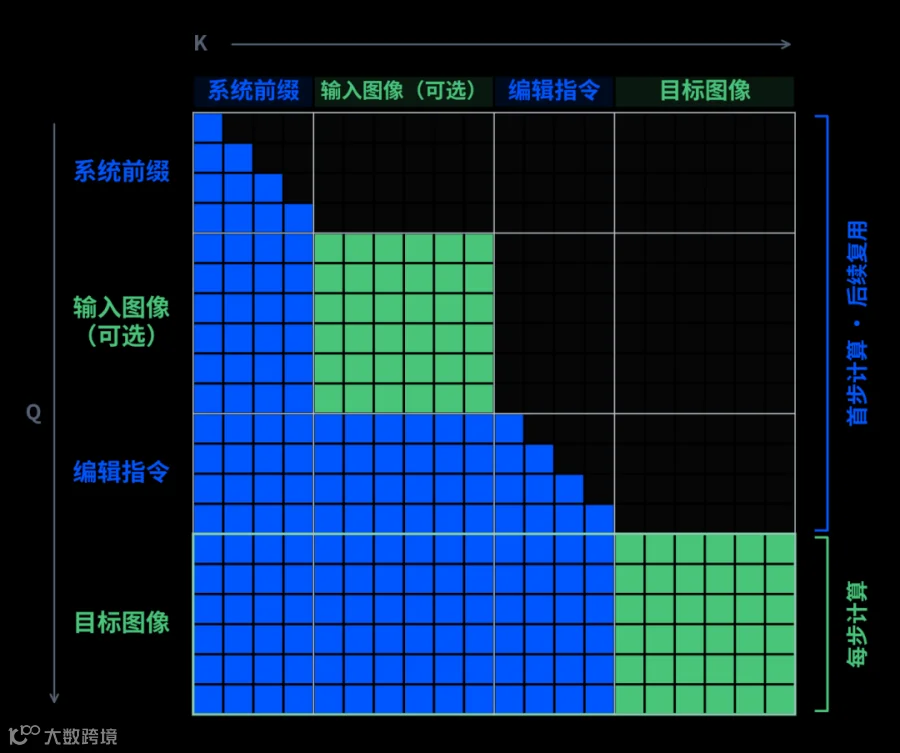
Qwen-Image-2.1混合粒度注意力结构
支持透明图像生成,创改一体
透明图像是本次更新的一项重要能力。我们曾于 2025 年 12 月发布 Qwen-Image-Layered,专门支持透明图像生成。现在,Qwen-Image-2.1 将这项能力整合进统一模型,能够根据提示词描述,自动决定输出普通图像还是带有透明通道的图像。
下面是通过文本直接生成的透明图像的示例:


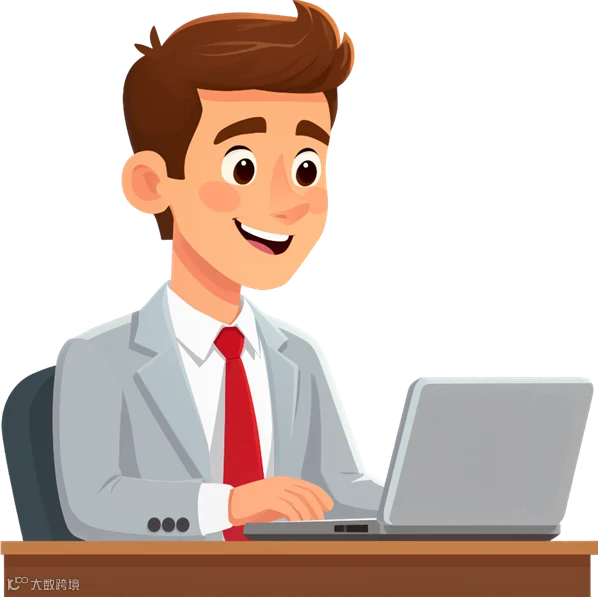
除了单个主体,模型还可以生成由多种元素组成、结构更复杂的透明图像,为设计与素材制作提供更多选择。

作为文生图与图像编辑二合一的模型,Qwen-Image-2.1 也支持直接编辑透明图像。例如,可以在保留透明背景的同时修改主体表情:
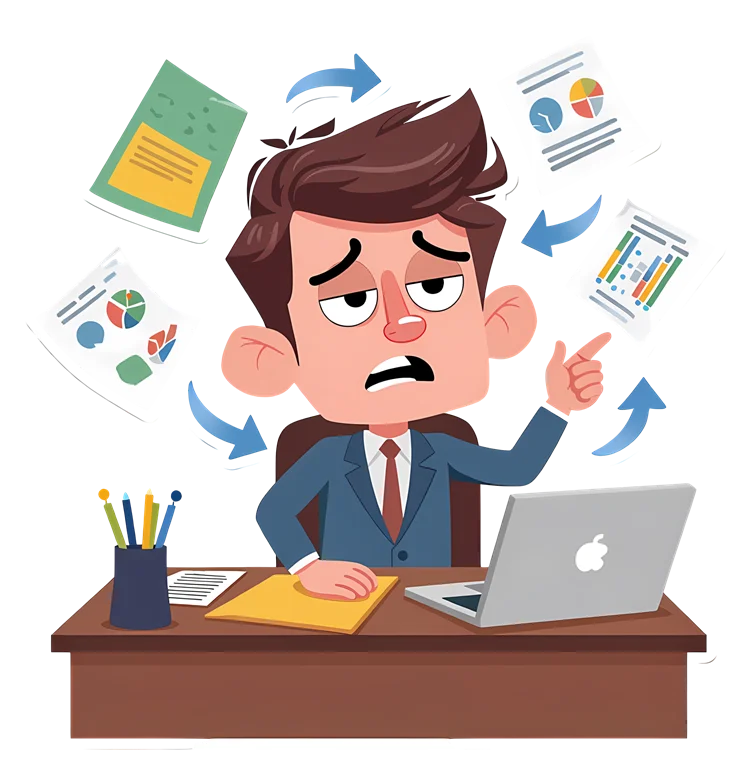

透明图层中的文字同样可以进行编辑,如下面的示例将文字“BLOOM”修改为“Qwen-Image”:
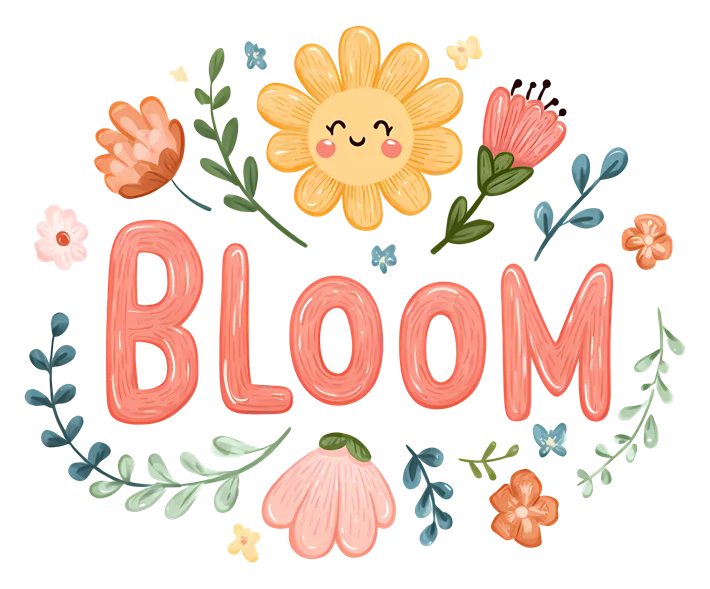
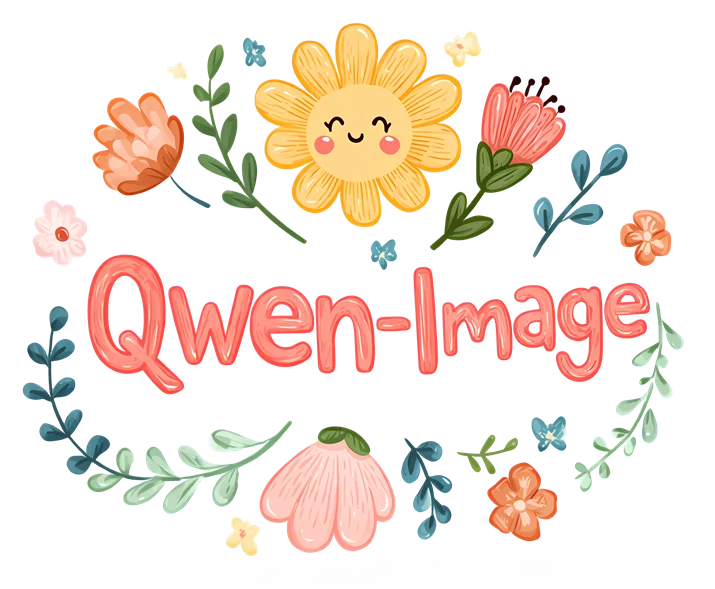
这项能力也适用于真实照片。输入一张 RGB 图像,模型可以提取所需主体,输出带透明通道的 RGBA 图层,让照片中的元素更方便地用于后续设计与合成。
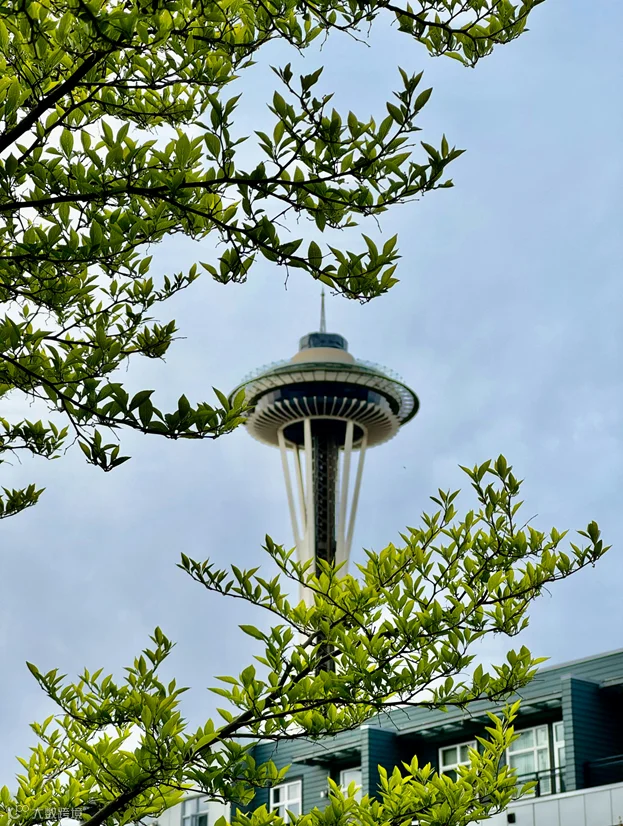
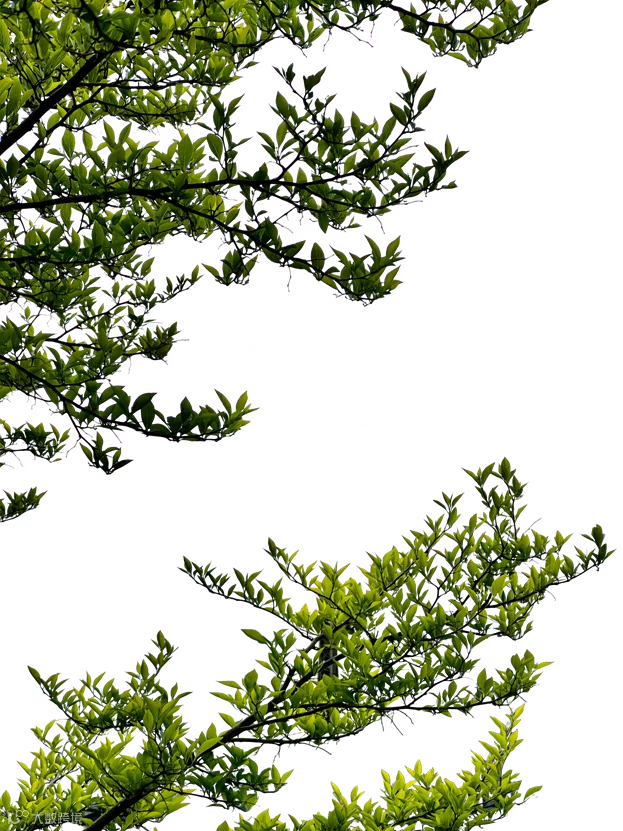
全能编辑能力
Qwen-Image-2.1的图像编辑能力得到提升,主要体现在4个方面:支持多图编辑、能够实现多种局部编辑方式、人像与商品一致性增强,并覆盖多种类型编辑任务。
多图编辑,支持10张参考图输入
Qwen-Image-2.1 最多支持 10 张参考图输入,可以综合多个主体与素材,生成完整、协调的画面。如下图将6张人像整合进同一张合照:

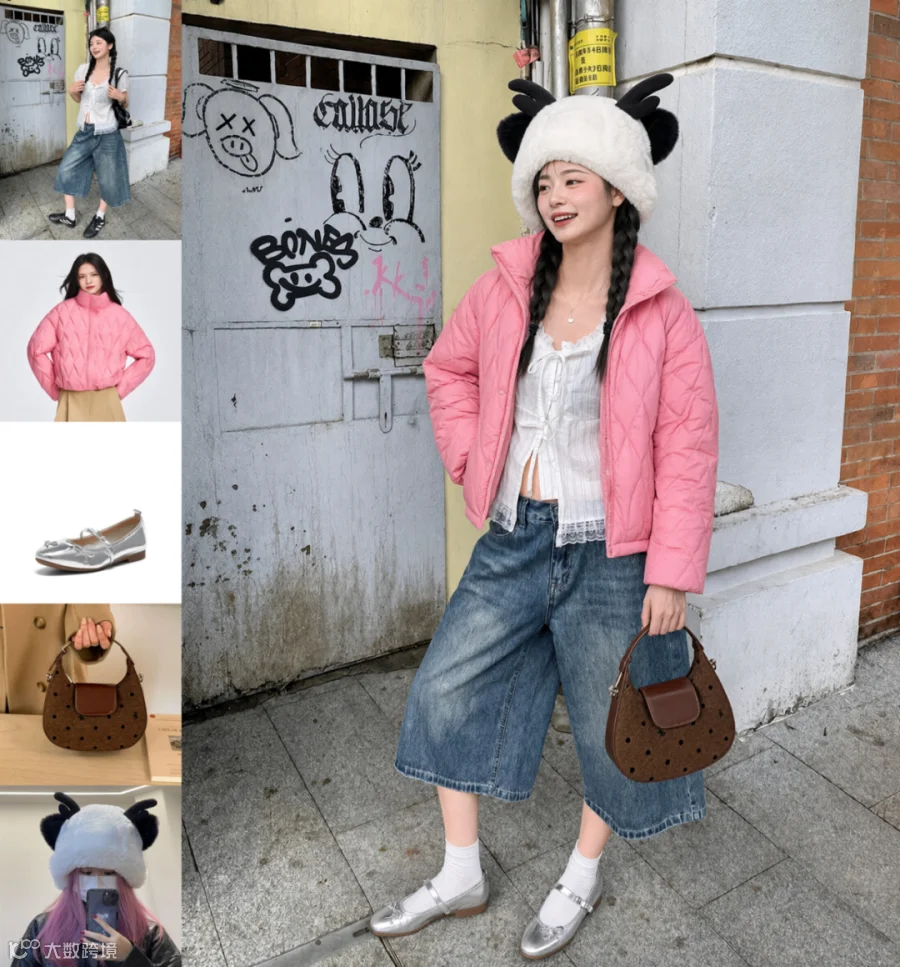
在多品穿戴场景中,输入模特、衣服、鞋子、包包与帽子共 5 张图片,即可生成完整的搭配效果:
在室内设计场景中,模型可以参考 10 张家居图片,生成完整的室内布置效果:

灵活指定编辑区域
Qwen-Image-2.1 支持圈选、涂抹和独立掩码等局部编辑方式,让修改对象与范围更明确。
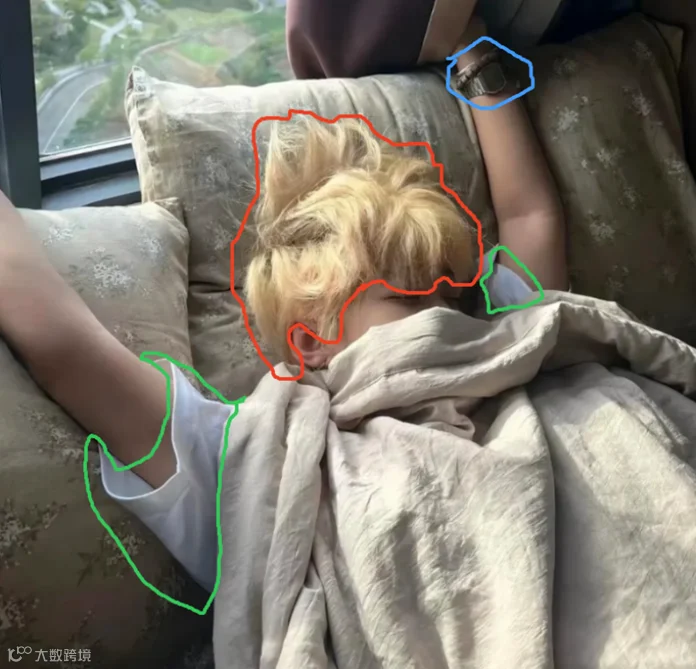
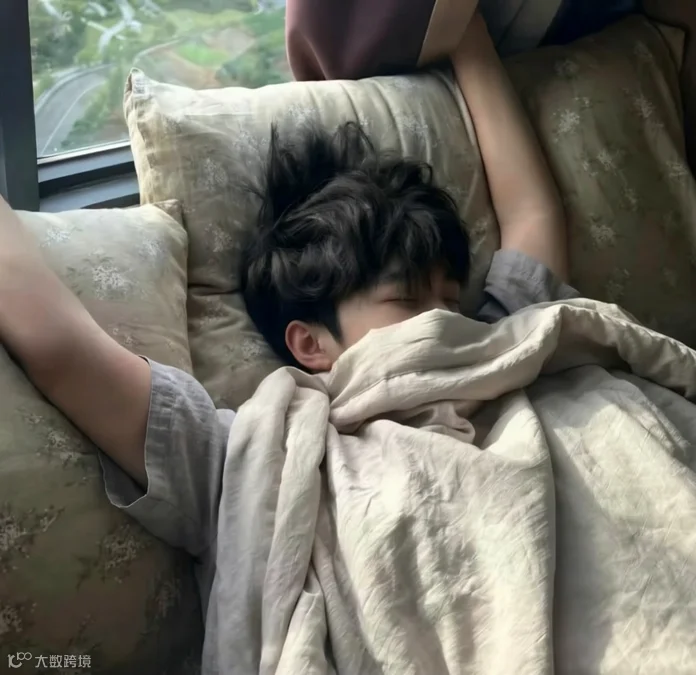
首先是圈选,如下图所示,不同颜色的圆圈同时指定三个编辑区域,要求模型“去掉蓝色圈的金属手表,把红色圈的头发颜色改为黑色,把绿色圈替换为灰色短袖亚麻睡衣”,模型能够精准对这三个区域进行修改编辑。
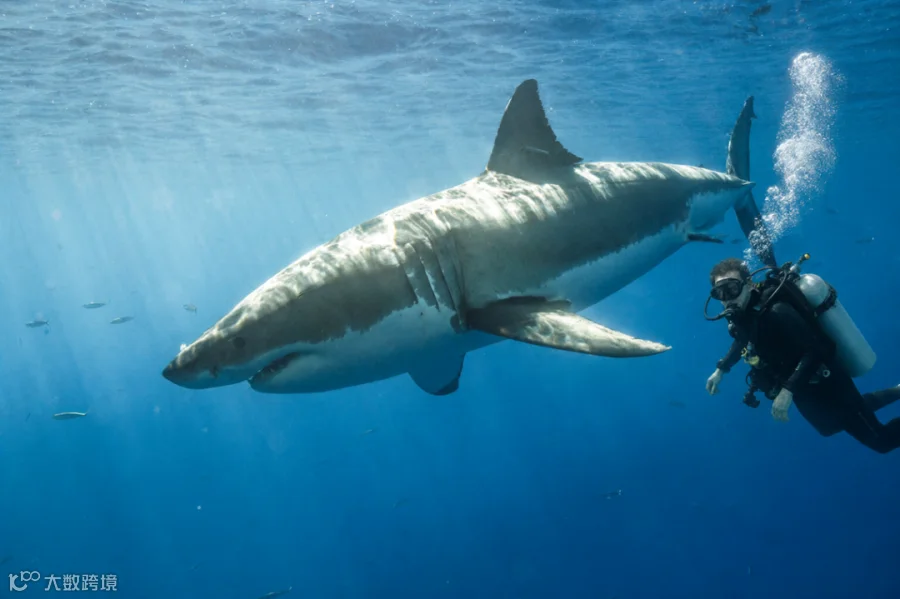
模型也支持通过涂抹指定区域进行编辑修改,如下图在鲨鱼右侧进行了白色涂抹,模型在这块白色区域添加了一名潜水员到图像中。

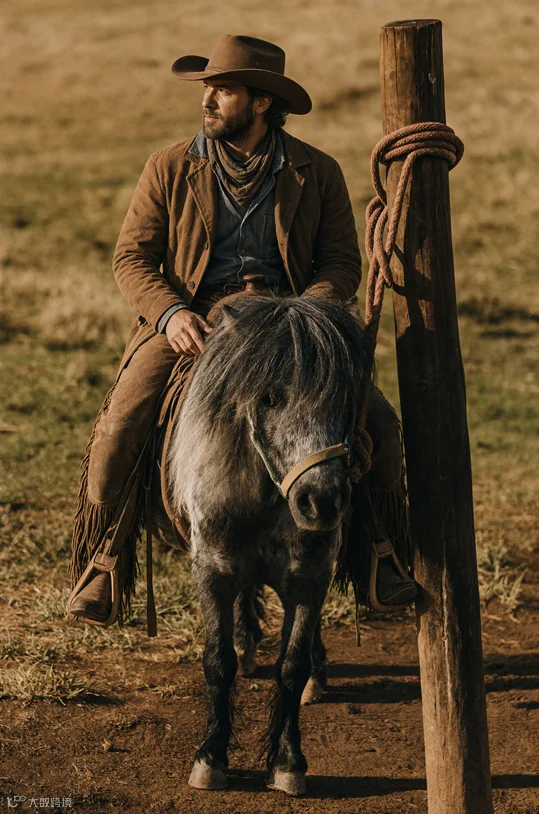
圈选与涂抹会覆盖原图中的部分内容,为保留完整的原始图像信息,Qwen-Image-2.1 还支持将原图和独立掩码作为两张图片输入。如要求生成一张坐在马背上的牛仔人物,两张输入的图片如下:
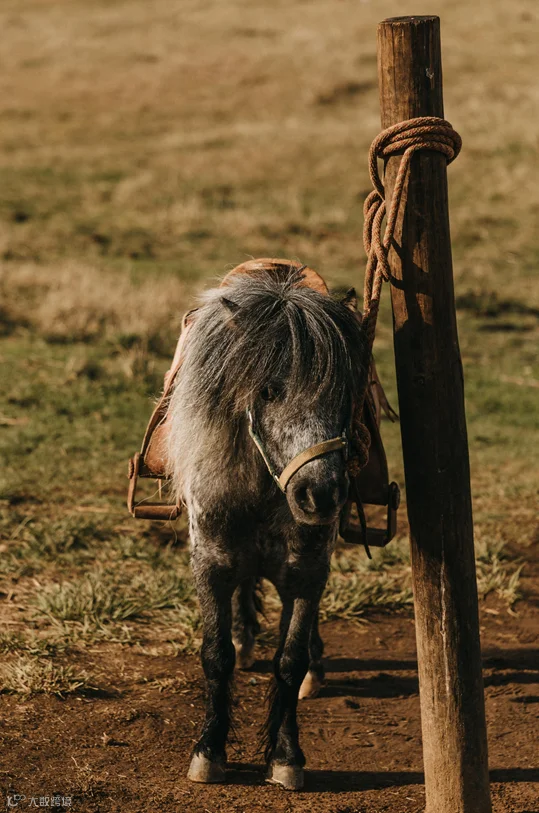
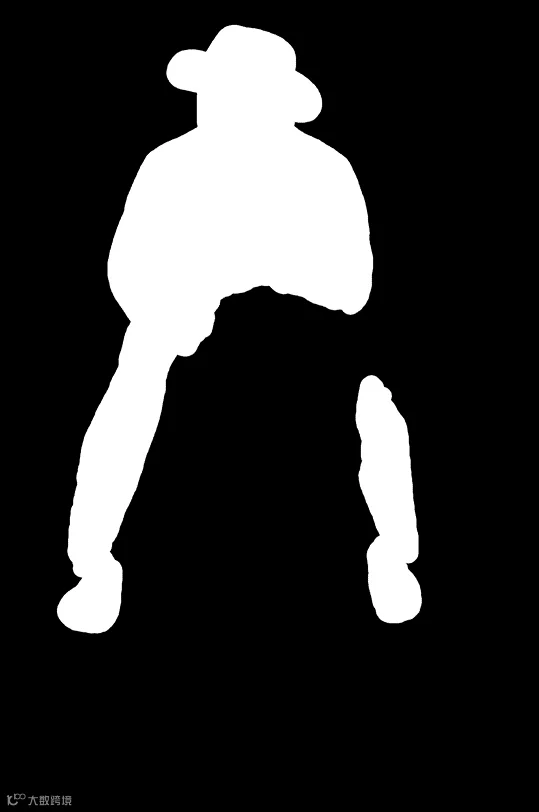
模型根据掩码指定的区域完成编辑,得到输出结果:
人像与商品一致性增强
模型重点提升了人物和商品的一致性。在人像编辑中,模型增强了对面部细节特征的还原能力,让修图前后的人物特征保持高度一致。


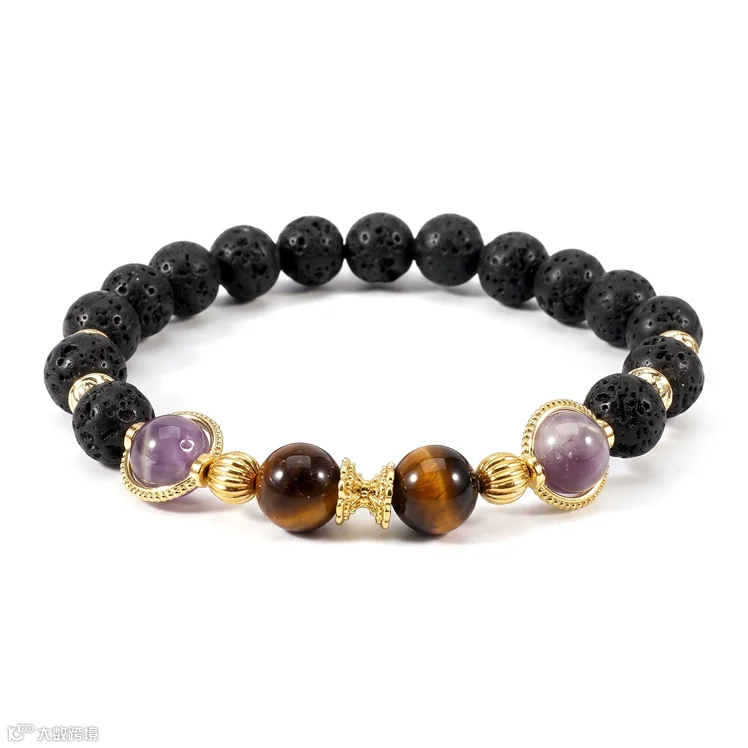
在商品编辑中,模型尽可能保持商品文字、纹理与形态的一致性,让商品在新的画面中保持原有特征:

覆盖多种编辑任务
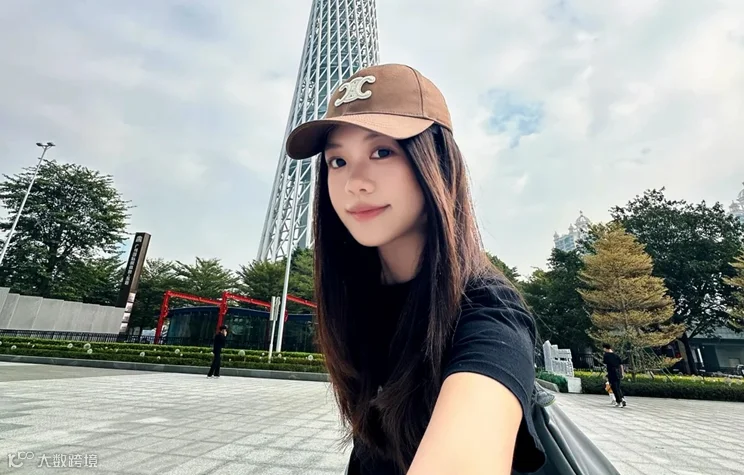
Qwen-Image-2.1 同时支持多种编辑任务,包括全景图、信息图与分镜图生成,在不同应用场景之间取得能力平衡。
例如,输入一张自拍照:
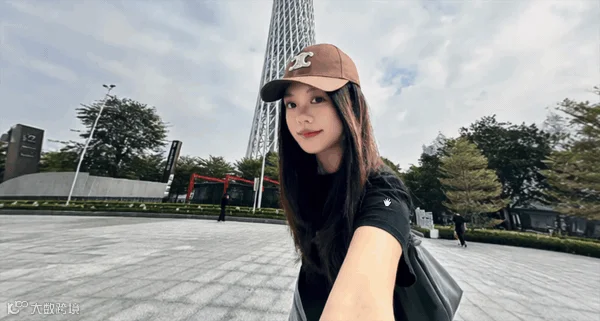
模型生成对应的全景图,放置到可视化工具后,即可从不同视角查看完整场景:
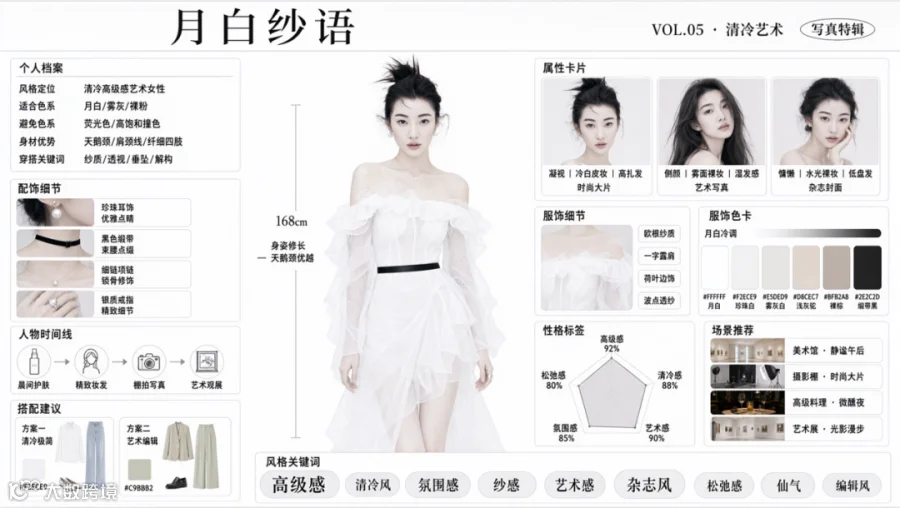
在信息图生成中,输入一张模特照片:

模型可以将其扩展为内容丰富的复杂信息图:
模型还可以根据人物三视图生成完整分镜,为故事创作和视觉叙事提供素材:
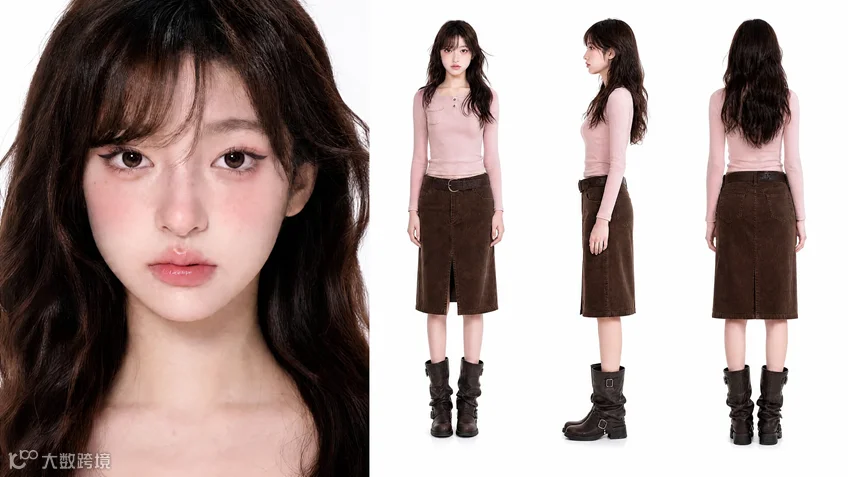
输入人物三视图
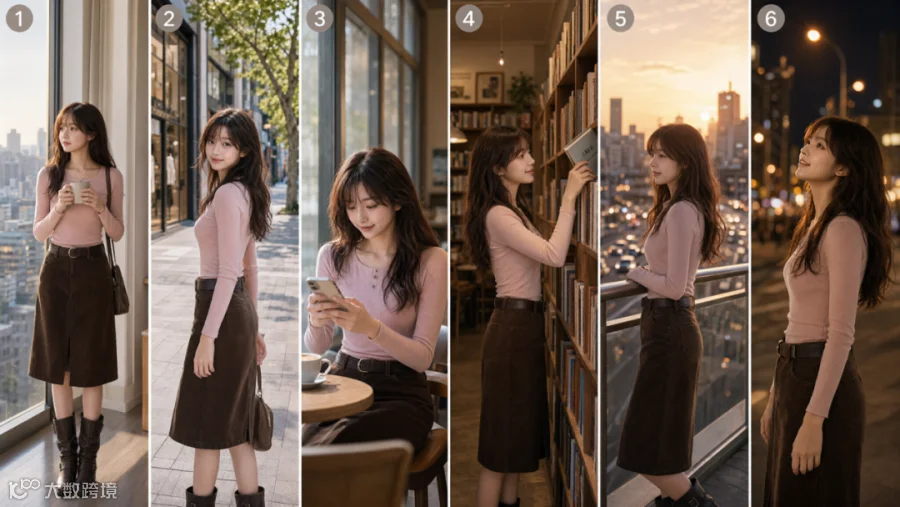
根据人物三视图生成的完整分镜
真实质感,字雅人美
Qwen-Image-2.1 进一步提升了图像质感,尤其关注文字与人物的美学表现。文字生成除了关注内容本身,也注重字体、排版与画面的整体协调。
下面展示了不同场景中的文字渲染效果:
示例1
示例2

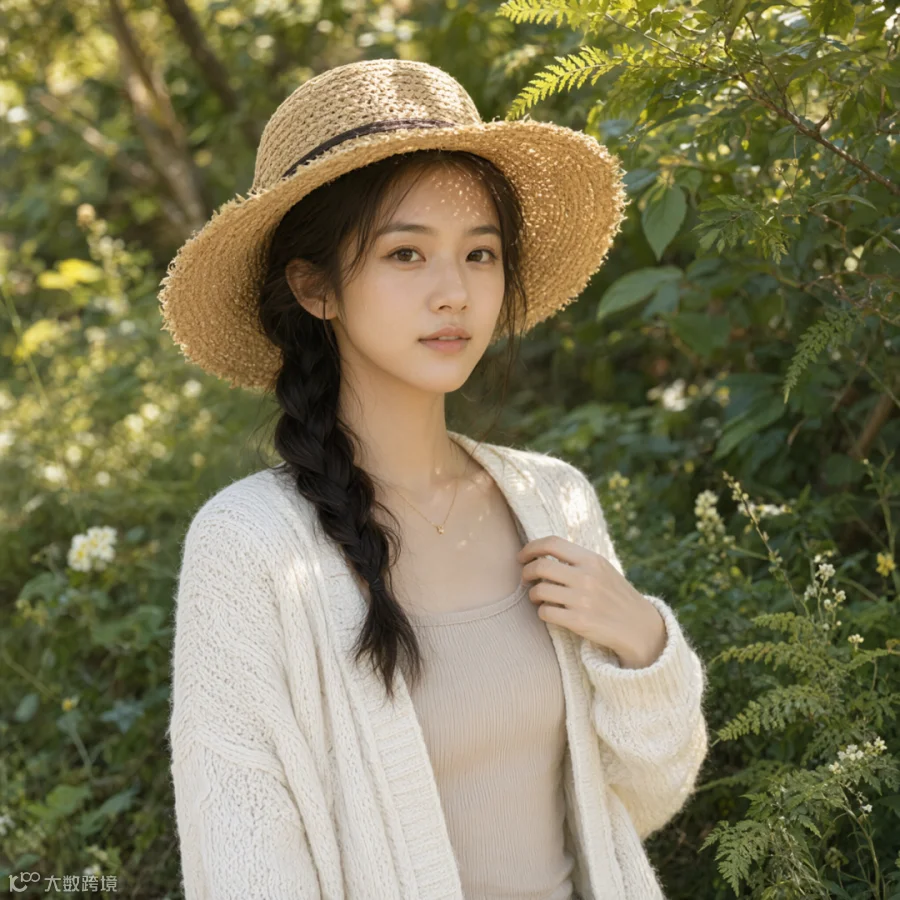
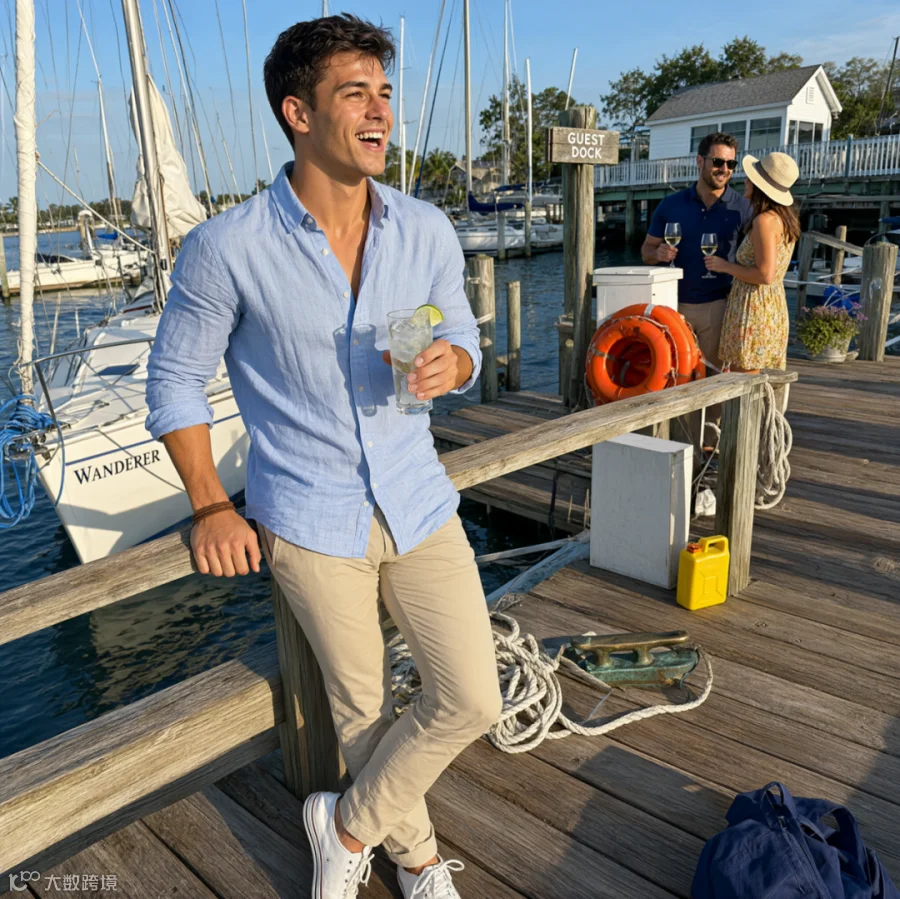
在人物表现上,Qwen-Image-2.1 增强了光影与细节刻画,让人像更具真实质感:
示例1
示例2
总结
Qwen-Image-2.1 以轻量的 7B 视觉生成模块为基础,将图像生成、透明图像与多种编辑能力整合在同一模型中。通过推理加速、最多 10 张参考图输入、灵活的局部编辑以及更好的人像和商品保真,模型为设计、内容创作、电商与视觉叙事提供了更高效的工具。
机器学习算法AI大数据技术
搜索公众号添加: datanlp

长按图片,识别二维码
阅读过本文的人还看了以下文章:
【模型高效部署】tensorrtx 深度解读,yolov11高性能推理实战案例
实时语义分割ENet算法,提取书本/票据边缘
整理开源的中文大语言模型,以规模较小、可私有化部署、训练成本较低的模型为主
《大语言模型》PDF下载
动手学深度学习-(李沐)PyTorch版本
基于40万表格数据集TableBank,用MaskRCNN做表格检测
《基于深度学习的自然语言处理》中/英PDF
Deep Learning 中文版初版-周志华团队
【全套视频课】最全的目标检测算法系列讲解,通俗易懂!
《深度学习入门:基于Python的理论与实现》高清中文PDF+源码
python就业班学习视频,从入门到实战项目
2019最新《PyTorch自然语言处理》英、中文版PDF+源码
《21个项目玩转深度学习:基于TensorFlow的实践详解》完整版PDF+附书代码
《深度学习之pytorch》pdf+附书源码
《Python数据分析与挖掘实战》PDF+完整源码
不断更新资源
深度学习、机器学习、数据分析、python
搜索公众号添加: datayx