

玩透大模型,绕不开两个核心关键词:Token(词元)与算力(FLOPs)。
很多人只会看模型参数量、API标价,却始终搞不懂:为什么有的大模型输入便宜、输出极贵?为什么千亿参数模型训练需要上万张H100?同样的Token数量,不同模型的算力消耗差距百倍?
所有问题的底层答案,都藏在Token与算力的绑定关系里。
重新读懂Token与算力
1、Token:大模型的通用文本计量单位
很多人误以为Token就是单个汉字或单词,这是典型认知误区。
Token是大模型输入输出的最小处理单元,是模型经过分词算法拆分后的独立文本单元,和我们日常的文字、词汇没有绝对对应关系。
行业通用换算标准:
● 英文场景:1 Token ≈ 0.75个单词
● 中文场景:1 Token ≈ 0.6-0.8个汉字
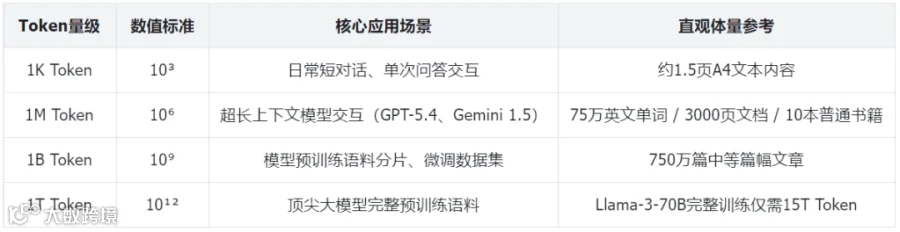
目前大模型的上下文长度、训练语料体量、所有平台的API计费,全部统一以Token为核心计量标准。为了方便直观理解,我们整理了行业通用量级对照:
2、算力:大模型运行的能耗核心指标
大模型语境下的算力,特指浮点运算次数(FLOPs)与运算速率,是衡量模型训练、推理硬件消耗的核心标准。行业通用算力单位换算:
● 1 PFLOPs = 10¹⁵ FLOPs/秒
● 1 EFLOPs = 10¹⁸ FLOPs/秒
主流商用GPU算力参考(FP16精度):
● A100:峰值312 TFLOPS
● H100:峰值990 TFLOPS,稀疏场景下可突破2 PFLOPS
模型训练 vs 推理的算力逻辑
绝大多数人混淆算力成本的根本原因:大模型训练和推理,是两套完全不同的Token算力换算逻辑。
训练是让模型“学习知识”,需要双向运算;推理是让模型“输出内容”,仅需单向运算,二者的算力消耗、瓶颈、量级天差地别。
1、训练阶段:高算力、超大规模运算
模型训练的核心是前向传播+反向传播,完成权重迭代学习,算力消耗极高,通用核心公式:
总算力FLOPs ≈ 6 × 模型参数量 × 训练Token总数
公式底层逻辑:Transformer架构中,每个参数单次Token前向运算需2次浮点计算,反向梯度更新需4次计算,合计固定6次运算消耗。
训练阶段整体特征:
● Token量级:万亿级起步(Llama-3为15T、GPT-4约13T)。
● 算力量级:10²⁴ ~ 10²⁵ FLOPs。
● 核心瓶颈:GPU算力峰值、卡间通信带宽、模型算力利用率(前沿模型仅40%-50%)。
行业公认的Chinchilla最优配比:算力预算固定时,模型参数量与训练Token数需按20:1比例同步扩容,这是大模型训练性价比最高的参数配置方案。
2、推理阶段:低延迟、显存带宽受限
推理无需反向传播,仅执行前向计算,算力消耗大幅降低,核心公式:
单Token算力FLOPs ≈ 2 × 激活参数量
推理阶段整体特征:
● Token量级:单次调用数百至数十万级。
● 算力量级:单Token 10¹⁰ ~ 10¹² FLOPs。
● 核心瓶颈:显存容量、显存带宽(解码阶段核心限制)、并发吞吐。
这里的关键区别在于激活参数量:稠密模型会调用全部参数计算,MoE混合专家模型仅激活部分参数,这也是稀疏模型推理成本远低于稠密模型的核心原因。
推理核心瓶颈:KV Cache决定真实吞吐
在实际落地部署中,显存占用永远比算力峰值更早触顶瓶颈,而显存消耗的核心元凶,就是KV Cache。
大模型生成每一个新Token时,注意力机制需要调取历史所有文本的Key、Value中间状态,这些数据需要实时缓存留存,即为KV Cache。上下文越长、并发数越高,KV Cache占用的显存就越大。
▶ KV Cache显存占用核心公式
KV Cache Size = 2 × 批次大小 × 上下文长度 × 层数 × KV头数 × 头维度 × 数据精度字节
以Llama-2-7B模型为例:FP16精度下,单个Token的KV缓存占用约128KB。当上下文拉满8K、并发数32时,仅KV Cache一项就会占用数十GB显存,体量甚至超过模型本身权重。
▶ 主流优化方案的价值
传统部署框架的显存利用率仅20%-30%,资源浪费极其严重。而vLLM等主流推理框架,通过分页注意力、连续批处理、前缀缓存三大核心优化,将显存利用率提升至96%,同等硬件条件下,模型吞吐能力直接提升10-24倍。
看懂主流模型的算力差异
结合真实模型参数与算力数据,能更直观理解上述逻辑的落地价值。
1、Llama-3-70B(稠密模型)
作为经典稠密模型,该模型训练需15T Token数据,代入公式可算出总算力约6.3×10²⁴ FLOPs。在50%算力利用率的常规条件下,需要上万张H100显卡持续训练数月才能完成。
推理层面,模型全部参数参与激活,单Token算力消耗达140 TFLOPs。受限于显存带宽瓶颈,A100显卡单卡单次吞吐仅93 Token/s,硬件成本极高。
2、GPT-4(MoE稀疏模型)
GPT-4总参数达1.8T,但采用Top-2专家路由机制,单次Token仅激活2%的参数(约36B)。依托13T训练Token数据,其有效算力消耗仅4.68×10²³ FLOPs,是同规模稠密模型的1/100。
稀疏架构的优势极致凸显:在保留顶尖生成能力的同时,将单Token推理延迟控制在百毫秒级,大幅降低硬件能耗。
算力成本决定API报价
所有大模型API的定价,本质都是算力成本的商业化摊销。行业统一以“百万Token”为计价单位,输入、输出价格差距巨大,核心根源就是算力消耗不同。
▶ 2026年主流模型定价参考
● GPT-5.4:输入$2.5/百万Token,输出$15/百万Token
● Claude Sonnet 4.6:输入$3/百万Token,输出$15/百万Token
● 国产Qwen3.6-27B:输入约¥0.05/千Token,性价比优势显著
▶ 价格差异的三大核心根源
● 参数规模:参数越大,单Token基础算力成本越高,70B模型成本普遍是7B模型的10倍左右。
● 模型架构:MoE稀疏架构通过部分参数激活,可降低一个数量级的有效算力消耗,这也是高端模型敢做大参数、保速度的核心。
● 部署优化:量化压缩、KV缓存优化、投机解码等技术,直接提升硬件利用率,压低单Token边际成本。
除此之外,前缀缓存、批量调度、并发限流等运营策略,能让实际使用成本再降低3-5倍,长文本场景的成本优化效果尤为明显。
一套完整的算力传导链
通读全文后,我们可以把大模型Token与算力的关系,浓缩为一条核心传导公式:
Token体量(计算基数)→ 参数量(算力乘数)→ 架构设计(激活比例)→ 硬件性能(处理速率)→ 优化策略(利用效率)→ 最终成本与定价
● 训练阶段的核心目标,是依托Chinchilla定律,在固定算力预算下,实现参数与Token的最优配比,用最低成本训练出最优模型。
● 推理阶段的核心目标,是通过架构创新、部署优化,在固定硬件条件下,最大化Token吞吐、最小化延迟与使用成本。

