


10 个关键问题 Q&A
- Nimble 是什么?
Bespoke Labs 开源的结构化快速决策模型,实现 TypeSafe Jev 的 Choice 原语,直接基于 token logits 做判定,不生成长文本。 - Nimble 是 Jev 蒸馏出来的吗?
不是。官方明确说明没有从 Jev 蒸馏,是独立训练,仅借鉴 Jev 的设计范式。 - Nimble 的 Schema 有什么硬性约束?
Schema 必须扁平,仅支持布尔或枚举;枚举选项上限 26 个,不支持嵌套 JSON。 - 对比式数据构造是什么核心思想?
构造成对样本,仅修改一处关键事实,让标签反转,迫使模型学习证据与决策之间的因果关系。 - ParallelScorer 相比 CUDA Scorer 优势在哪?
MLX ParallelScorer 对同一段上下文只做一次 KV Prefill,多个 schema 字段并行打分,减少重复计算,速度更快。 - Nimble 输出的概率可以直接当作真实准确率吗?
不可以。概率仅在你给定候选集合内归一化;0.9 不代表 90% 正确率,业务必须单独做阈值验证。 - Nimble 能生成自然语言解释、输出嵌套 JSON 吗?
不能。它只能从预设候选集合返回选定答案,无法生成解释、不支持嵌套结构。 - 训练使用什么微调方案与超参?
LoRA 微调,rank=16,学习率 5e-5,有效 batch=8,训练 1epoch,BF16 精度。 - Nimble 适合哪些业务场景?
工单路由、政策合规校验、客服优先级判定、内容风险分类、有序等级评分等结构化判定任务。 - Nimble 的主要短板是什么?
训练数据集规模小、覆盖领域有限,跨陌生领域泛化能力弱;仅支持文本输入,字段之间打分独立,需要业务层校验结果一致性。

一句话定位:Nimble 是面向结构化分类决策的轻量微调模型,不走生成式推理,直接读取候选 token 的 logits 做判定,主打高速、带概率输出的 Schema 驱动决策;不是通用大模型,是「System One 快速决策专用模型」,由 Bespoke Labs 开源,基座 Qwen3.5-9B,配套完整数据构造、LoRA 训练、本地推理代码。
一、设计思想(System One / Typesafe AI Choice Primitive)
传统 LLM 做判断:生成文本 / JSON,再解析,慢、容易格式出错、容易编造理由。 Nimble 思路:
-
预先定义扁平 Schema:字段只能是 boolean或enum(1~26 个选项),不支持嵌套结构 -
每个候选答案映射成单个 token;模型不输出长文本、不写推理过程 -
只读取这几个候选 token 的 logits,softmax 算出每个选项概率,直接返回结果 -
多个字段可以并行打分(MLX ParallelScorer,共享 KV Cache,一次 prefill,多字段并行计算,大幅提速)
核心理念来自 typesafe.ai 的 Choice primitive,和 Jev 同源,但Nimble 不是 Jev 蒸馏出来的,它是独立训练的开源复现方案,给社区一套完整 “数据配方 + 训练 + 部署”。
✅ 能干什么
输入一段文本 + 自定义扁平 Schema,得到:
-
路由分发(请求分到哪个渠道) -
条件布尔判断(是否满足策略) -
策略判定(按规则选出允许结果) -
分级打分(有序评级,输出期望分值)
返回:选中答案 + 每个候选的概率 + logits 原始值,不需要解析 JSON,从根源规避生成解析失败。
❌ 当前版本限制(非常关键)
-
仅支持文本输入,基座虽然带视觉,但 Nimble 不支持图片 - 不能自由生成文本、不能输出解释理由
,只能从你给定候选集合里挑选 -
Schema 必须扁平,无嵌套 JSON;enum 最多 26 个选项,boolean 只有 2 个 -
单 prompt 上限 2048 token(包含 schema + 字段描述) -
字段之间独立打分:A 字段看不到 B 字段结果,业务层自行校验一致性 -
概率≠真实校准精度:概率只是候选集合内归一化结果,0.9 不代表 90% 准确率;如果存在不在候选里的情况,要增加 no match选项 -
训练数据只有 2676 条合成样本,覆盖 10 个领域,泛化能力有限,适合领域内决策,跨领域会明显掉点
二、数据集:Contrastive Data Curation(对比式数据构造,本项目最大创新)

训练集全部合成数据,由模型校验,无人工标注。核心思路:成对构造样本,仅改动 1 个关键事实,答案翻转,其余文字完全不变。
四步构造流程
-
定义决策规则,提取影响结论的核心事实 -
构造成对样本:几乎完全相同,最多修改 8 个词,仅修改 1 个焦点事实,标签反转 -
自动校验:删掉任意一条证据,焦点事实必须无法判定;确保没有文字线索直接泄露答案 -
代码按规则生成标签,校验通过的样本对才入库
目的:强迫模型学到哪一条证据改变决策,而不是靠关键词记忆,提升判别能力。
数据集规模
-
train.jsonl:2826 条,实际训练使用 2676 条 -
eval.jsonl:324 条 holdout(162 对成对样本,仅 6 个领域) 任务分为三类: -
Choice 多选:856 条 -
Noul(Boolean 布尔判断):888 条 -
Score 有序评级:932 条
领域:Commerce、Education、Home、Media、Public services、Science、Software、Supply chain、Travel、Workplace。
三、模型训练细节(LoRA 微调 Qwen3.5-9B)
-
基座:Qwen3.5-9B -
训练方式:LoRA 微调 -
LoRA rank =16 -
LR=5e-5,有效 batch=8,1 个 epoch -
BF16,2048 token 上下文窗口 -
训练硬件:L40S;最终评估 H100 -
训练目标:候选 token 上的交叉熵,硬标签训练,不是 Jev 软蒸馏(代码预留支持未来软蒸馏)
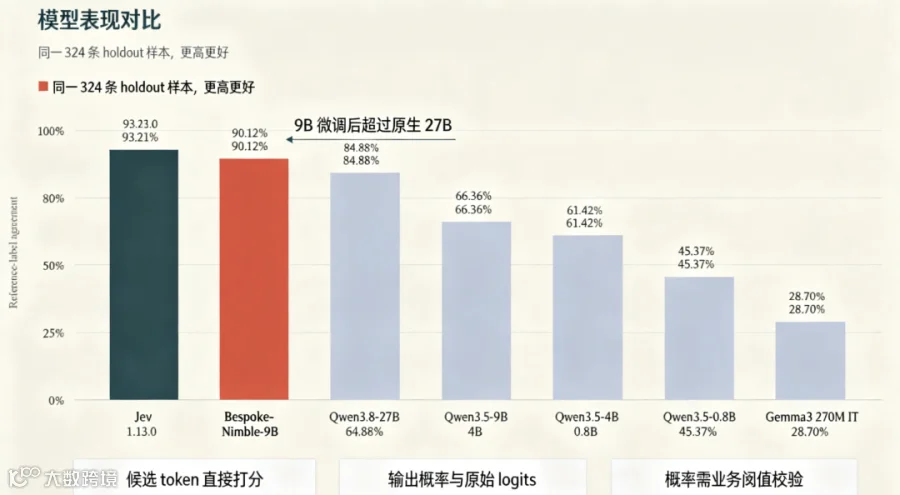
Holdout 324 样本评测结果(同测试集对比)
表格
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| Bespoke-Nimble-9B | 292 | 90.12% |
|
|
|
|
亮点:9B 微调后,超过原生 Qwen3.8-27B 大模型,仅比 Jev 低 3 个点。 ⚠️ 注意:这个测试集范围很窄,全部来自 6 个 source family,不能代表通用能力;项目文档也提供了公共 benchmark 脚本 (PUBLIC_BENCHMARKS.md),用于 VitaminC 等外部人工数据集测试。
四、推理引擎:两套 Scorer 实现
1. MLX ParallelScorer(Apple Silicon Mac,推荐)
-
一次 prefill 填充上下文 KV Cache,同一份文本下多个 schema 字段并行打分 -
极大节省 token 重复计算开销,适合一个文本一次性做多维度判定 -
限制:不能直接加载 LoRA,需要提前合并权重;不支持量化 -
硬件:M 系列 Apple Silicon,推荐 64GB 内存(合并权重阶段吃内存)
2. CudaCandidateScorer(NVIDIA GPU BF16)
-
每个字段独立完整 prompt、独立打分,没有并行 KV 复用 -
优势:可以直接加载 LoRA 适配器,不用提前 merge 权重 -
硬件:支持 BF16 的 NVIDIA GPU(H100/L40S 等)
性能延迟(H100,单字段,单位 ms)
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
在 H100 上单字段推理中位数仅 106ms,显著快于 Jev API;M5 Pro 64GB 本地会慢很多(中位数 444ms)。
五、目录结构
nimble/
├── scoring/          # MLX / CUDA 打分器核心代码
├── datasets/         # 对比式数据生成、标注流水线
├── evaluation/       # 评估、延迟benchmark
├── training/         # LoRA训练脚本
examples/             # Schema样例,输出样例
data/                 # train/eval jsonl数据集
evaluations/          # 本地运行生成,不提交git
assets/               # 图表、对比视频
docs/                 # 完整文档:训练、数据、并行打分、Modal部署
requirements/         # MLX / PyTorch / curator 三套依赖
tests/                # 单元测试
六、快速上手极简 Demo
import json
from pathlib import Path
from nimble.scoring.parallel_scorer import ParallelScorer

config = json.loads(Path(".cache/nimble-model.json").read_text())
scorer = ParallelScorer(**config)

schema = {
    "priority": {
        "type": "enum",
        "choices": ["HIGH", "LOW"],
        "description": "Urgency based on current business impact.",
        "choice_descriptions": {
            "HIGH": "A critical business operation is currently blocked.",
            "LOW": "An optional enhancement with no current business impact.",
        },
    },
    "requires_review": {
        "type": "boolean",
        "description": "Whether customers are unable to complete a purchase.",
    },
}
res = scorer.score("The payment service is down for all customers.", schema)
print(res["output"])
print(res["fields"]["priority"]["scores"])
输出示例:
{"priority": "HIGH", "requires_review": true}
七、Nimble vs Jev 对比
-
Jev:闭源 API,Typesafe 官方,效果略强;不可本地部署 -
Nimble:开源、可本地私有化部署;独立训练不是蒸馏 Jev,复刻 Jev 核心的「Choice 原语 + logit 打分」范式,提供完整从数据到训练的配方;效果略低一点,但是完全可控。
项目定位:开放版 Jev Recipe,给大家一套可以自己复现、自己做领域微调的 System One 决策模型方案。
八、适用场景 & 不适合场景
✅ 适合
-
工单路由、政策合规判定、客服优先级分级、内容二分类 / 多分类、风险判定 -
需要带概率置信度的结构化决策 -
低延迟、高吞吐的大量独立判定任务 -
私有化本地 GPU/Apple Silicon 部署
❌ 不适合
-
长文本生成、写摘要、解释推理理由 -
多轮对话、嵌套复杂 JSON 输出 -
跨大量陌生领域通用判断(训练数据域窄) -
图像 / 多模态输入
九、工程要点总结
-
创新是对比式成对数据构造方法,这比模型微调本身更有价值,可以迁移到其他基座做决策模型 -
ParallelScorer 的 KV Cache 复用,是业务批量多字段打分的性能关键 -
概率只是候选集合内归一化,不能直接当成真实准确率,业务侧要做阈值校验 -
训练数据全部合成,存在隐式偏差;上线前必须在真实业务数据上评估 -
环境要隔离:MLX、PyTorch、数据标注 curator 三套独立 Python 虚拟环境