最近 Jev 很火。

一次从 Intent 到 State Delta 的实验复盘
最初接触 Jev 时,我们想做的很简单:让它识别用户意图,再判断参数是否完整,最后交给 LLM 生成工具调用。但随着实验进入“最近吧”“改成30天”“那就第二个”等真实对话,这条看似顺畅的流程开始暴露问题。
真正让系统变得清晰的,是把自然语言理解、状态更新和执行校验拆开。Jev 解释用户这一轮想改变什么,代码保存并检查状态;只有遇到开放生成或复杂规划,才调用 LLM。本文沿着这条实验主线,说明这套架构如何形成,以及 Question 应该怎样设计。
一 从意图识别走向参数理解
第一组实验只做 Intent,也就是识别用户要办什么事。我们定义股票、天气和航班三个业务场景,再增加 unknown 作为兜底。面对“帮我看看腾讯的股价”,Jev 需要做的是在有限候选中选择最匹配的一项。

图 1 意图选择的最小设计 候选中保留明确的兜底项
这种设计把自然语言压缩成软件能处理的离散选择。于是,我们很自然地往前走了一步:既然能判断想做什么,能不能接着判断“信息够不够”?
第二组实验的输入是“帮我看看腾讯最近的股价走势”。股票查询需要证券、时间范围和指标三个槽位,看起来用户全都提到了。但“最近”到底是7天、30天,还是最近几个交易日?如果工具需要明确的起止日期,这句话还不能直接执行。
问题不在于模型能否识别“最近”,而在于我们把“提到了参数”和“参数可以使用”混成了同一个判断。
二 参数完整需要拆成四层
后来,我们用 Present、Resolved、Valid、Executable 四层描述请求从自然语言走向执行的过程。前三层主要描述槽位,最后一层判断整个请求。

图 2 Present → Resolved → Valid → Executable 四层模型
Present 问“有没有表达这个概念”。用户说了“最近”,时间概念就已经出现;如果根本没有时间表达,才属于缺失。
Resolved 问“能否得到足够明确的规范值”,也就是 canonical value。例如“最近7天”和“过去一周”可以按业务规则归一化为同一时间范围;“最近”仍然需要澄清。具体展开成日期时,还要由代码统一时区、边界是否包含当天,以及自然日或交易日口径。
Valid 问“这个值是否符合当前系统规则”。用户说“英伟达”,系统可以明确识别出 NVIDIA,但如果当前工具的证券白名单只有腾讯、阿里、苹果和特斯拉,这个值仍然不受支持。理解了实体,并不意味着工具能够处理它。
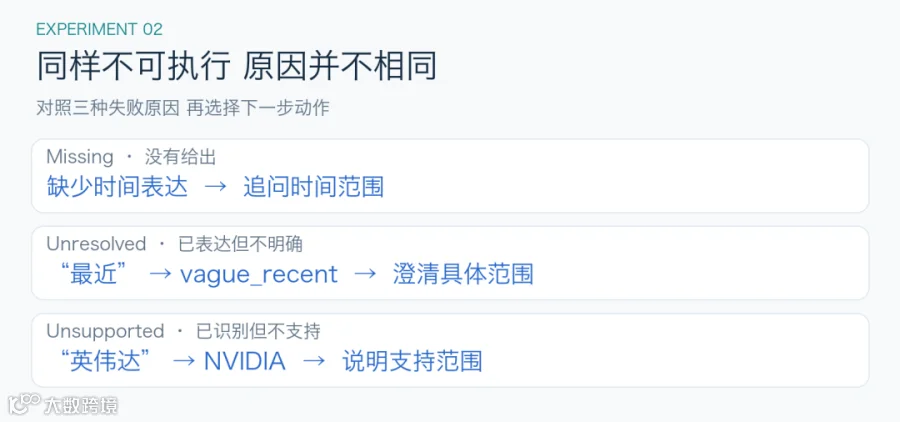
图 3 缺失 未解析 不支持 三类问题对应不同的后续动作
Executable 则是在已更新的状态上综合判断:必需参数是否齐全、解析是否完成、值是否合法,以及权限和业务条件是否满足。尚未解析的槽位,其有效性可以暂不判定,不能因为字段存在就把它标为有效。
因此,Missing、Unresolved、Unsupported 必须区分。缺失需要补充,模糊需要澄清,不支持则需要解释能力边界或让用户改选。
三 多轮对话需要输出 State Delta
真正的难题从第二轮开始。第一轮用户说“帮我看看腾讯最近的股价走势”,系统追问“你想看多长时间”,用户只回答“最近7天”。单看这四个字,没有股票意图,也没有证券名称。
这时,Jev 需要看到当前意图、已填槽位和 pending_slot,也就是系统正在等待的参数。上下文已经说明这是股票查询,且只缺明确的时间范围;本轮的任务就是解释这句话带来的变化。

图 4 Current State + User Turn → State Delta → Updated State
State Delta 可以理解成一份“修改说明”:本轮是在回答等待中的问题,目标槽位是时间范围,新值是最近7天。它不需要重新生成整份状态,也不应该替代码直接修改状态。
我们最初为省步骤,让 Jev 同时读取旧状态和新消息,推演新状态,再判断是否可执行。一次结果里,ready 的候选得分达到96%,但 blocking_slot 为 none 的得分只有57%,time_range 仍占43%。两个输出出现了张力。

图 5 拆分前后的单次观察 候选得分不等于真实正确率
一种合理解释是,旧状态中的 vague_recent 仍影响着后续判断。我们把过程拆开:2A 只解释本轮变化,代码实际合并状态,2B 再读取已经更新的状态。已展示的那组结果中,完整性、解析状态、有效性和就绪判断变得一致。
这支持了一个工程判断:理解变化与提交变化应当分开。它并不能证明生产环境能达到100%准确率,也不意味着后续每组场景的2B都已完成验证。
四 边界测试暴露的是问题设计
随后,我们把多轮测试扩展到补槽位、改值、切换意图、取消、继续、模糊回答、多槽位修改、指代、歧义和不支持的实体。测试的价值,是观察模型究竟在哪个环节犹豫,而不只是看最高得分是否漂亮。
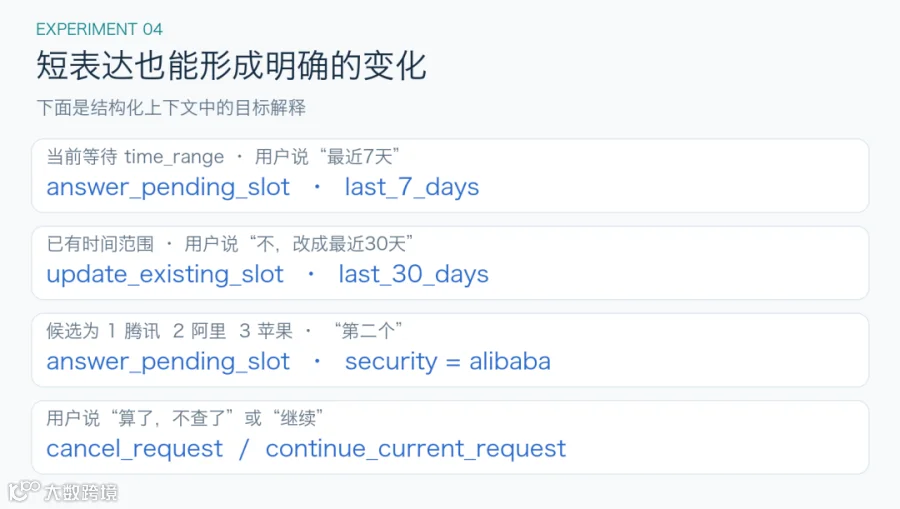
图 6 本轮表达要结合 pending_slot 和 candidate_options 解读
“那就第二个吧”尤其有代表性。系统先给出“1 腾讯、2 阿里、3 苹果”,再把 candidate_options 连同当前状态提供给 Jev,它才能把“第二个”映射成阿里。脱离这份候选列表,序号本身不能唯一确定实体。
同时,我们发现一些看似“不准”的结果其实来自候选重叠。曾经给 resulting_intent 同时设置 keep_current_intent 和 stock_query:当当前意图本来就是股票查询,用户只改时间时,这两个答案都成立。得分分散并不奇怪。
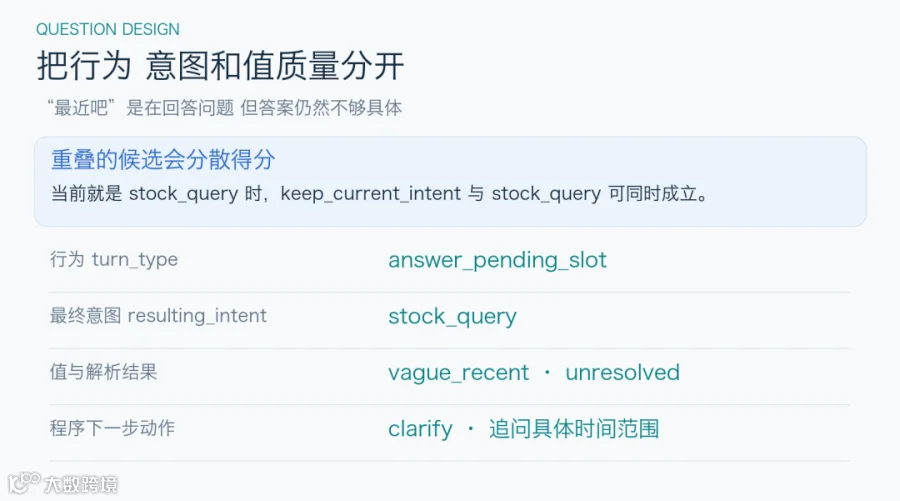
图 7 每个 Question 只承载一个判断维度
改法是把维度拆开。turn_type 只描述本轮行为,例如回答、修改、新建、切换、继续或取消;resulting_intent 只输出最终意图,例如股票、天气或航班。不要把“保持不变”这种操作和“股票查询”这种结果放在同一个候选集合里。
“最近吧”揭示了另一种混淆。它显然是在回答时间问题,所以行为可以明确;但值依然模糊,后续动作应该是澄清。把 answer_pending_slot 和 ambiguous 当成互斥答案,就把“行为类型”和“值的质量”混在了一起。
多槽位修改也一样。用户一口气改了证券和时间,就不应强迫它只选一个 target_slot。变化可以表示成多项 delta,或分别对各槽位判断是否更新,再交给代码统一处理。
五 意图切换是状态生命周期事件
当用户说“股票先不看了,看看上海明天天气”,任务已经从股票查询切换到天气查询。此时继续让模型逐项判断旧证券、旧指标应该 clear 还是 unchanged,只会制造额外问题。

图 8 切换意图后按新任务的槽位结构重建状态
更简单的方式是:Jev 判断这是切换意图,代码归档旧任务并建立天气状态,再解析上海和明天。旧股票槽位自然不会混入新任务。是否保留旧任务供恢复,也应是代码明确规定的生命周期策略。
“顺便看看天气”则可能意味着新增并行请求,而不是取消股票任务。new_request 与 switch_intent 的定义需要结合产品行为写清楚;不能仅凭出现另一个业务意图,就默认丢弃原任务。
六 最终架构按职责分工
至此,系统的职责已经可以收敛。Jev A1 识别对话行为与意图,Jev A2 把目标意图下的槽位表达归一化;代码接收变化、维护状态,并执行确定性检查。A1 和 A2 首先是逻辑职责划分,是否拆成两次调用,可以根据延迟和测试结果决定。

图 9 最佳实践架构 未通过检查时返回澄清或错误反馈
required、enum、JSON Schema、日期格式、权限和资源范围都属于代码检查。所谓四层模型,不是要求模型逐层回答四遍,而是让每一种判断都有明确的含义和负责方。代码检查字段存在时,也要区分“出现了键名”和“已经获得可用值”。
Semantic Gate 是可选的语义充分性检查。例如“分析昨天上海销量为什么下降”,市场、时间、指标形式上都齐了,但要解释原因,可能还需要对比期、渠道拆分或促销信息。只有这类难以用固定规则表达的业务判断,才值得再次使用 Jev。
语义门控应当输出明确结果:可以继续、需要补充什么,或现有信息只能支持怎样的结论。它不能绕过权限校验,也不应把尚未获得的业务证据当成已经存在。
LLM 同样不是必经步骤。如果状态中的字段已经能直接映射到工具参数,代码就可以完成调用;当任务需要开放文本、复杂搜索表达、SQL 生成、原因总结或多工具规划时,再引入 LLM。生成出的参数仍要按工具契约校验。

图 10 工具参数已确定时 直接映射比再次生成更简洁
以股票工具为例,证券、时间范围和指标都已确定时,程序可将规范值映射到实际参数。公司名也不总等于唯一证券:同一公司有多个上市地时,还需要解析到具体市场和证券标识。图中的简写用于解释架构,真正执行以业务目录和工具契约为准。
七 设计 Jev Question 的七条原则
1 让 Choice 尽量互斥。两个候选如果可以同时成立,就重新划分维度。对于“继续”“新建”“切换”等行为,写清楚与产品状态相关的判定边界。
2 区分 Missing、Unresolved 和 Unsupported。不要把所有不可执行情况都压成一个“缺参数”,否则系统无法选择正确的追问或反馈。
3 把行为和值质量分开。用户可能明确在回答问题,但答案仍模糊;也可能清楚地表达了一个当前工具不支持的值。
4 优先输出 canonical value。先让语义落到可控的规范值,再由代码映射实体标识、日期和工具参数。开放值无法唯一解析时,应显式保留未解析状态。
5 提供结构化 Current State。包含当前意图、等待槽位、已有值及必要的候选列表;相关上下文不足时再补充历史,避免把整段聊天记录无差别塞进每次判断。
6 把确定性规则交给代码。状态合并、必填项、枚举、格式和授权,都应有明确逻辑;只在确有语义难题时调用模型。
7 用测试数据制定自动执行门槛。结合最高候选得分、第一与第二候选的差距,以及真实错误案例决定何时自动处理、澄清或回退。不能把单次高分当成可靠性保证,也不必再单独问模型“你有信心吗”。
实际验证时,应分别记录行为识别、槽位解析和最终状态是否正确,再看完整请求能否成功执行。尤其要保留“第二个,哦不,第一个”“就按刚才那个,但换成阿里”这类修正和指代场景;它们比重复测试理想输入更能暴露架构问题。
让自然语言尽快落到明确状态
这一轮实验改变的,是我们给 Jev 安排的位置。它最值得承担的工作,是结合上下文,把人的表达转换成受控的 State Delta,让“换成昨天”“还是阿里”“算了”成为程序能够检查和执行的变化。
跨过这一步,状态由代码管理,规则由代码检查,复杂生成交给 LLM,工具通过 MCP 执行。这样,模型处理语义的不确定性,系统则用明确的状态和规则承接结果。