大数跨境

GPU开始边算边通信,NVIDIA把网络推进CUDA Kernel

GPU开始边算边通信,NVIDIA把网络推进CUDA Kernel 半导体产业报告
2026-09-21
3
导读:矩阵乘法还在计算后面的数据块,前面完成的那一小块结果已经开始跨GPU做all-reduce。
在大规模 AI 训练中,当模型被拆解至数十甚至数百张 GPU 运行时,矩阵乘法仅完成了一半工作。每张加速卡需将本地计算结果汇总并取回全局数据。传统流程中,网络通信往往需等待整块计算结束后才启动 all-reduce,导致计算结束前网络资源闲置。
NVIDIA 正通过主机侧通信调用、NVSHMEM 单边传输、NCCL Device API 以及 GEMM 与 all-reduce 融合等技术,消除这一时间空档。其核心目标是实现数据就绪即由 GPU 自主推动传输,无需等待 CPU 干预或整体计算完成。

多卡协同:局部结果的汇总机制

当模型层被切分至多张 GPU 时,每张卡仅生成局部结果。后续计算通常依赖 all-reduce 操作,即将各卡对应位置数值相加,并将总和广播回所有节点。
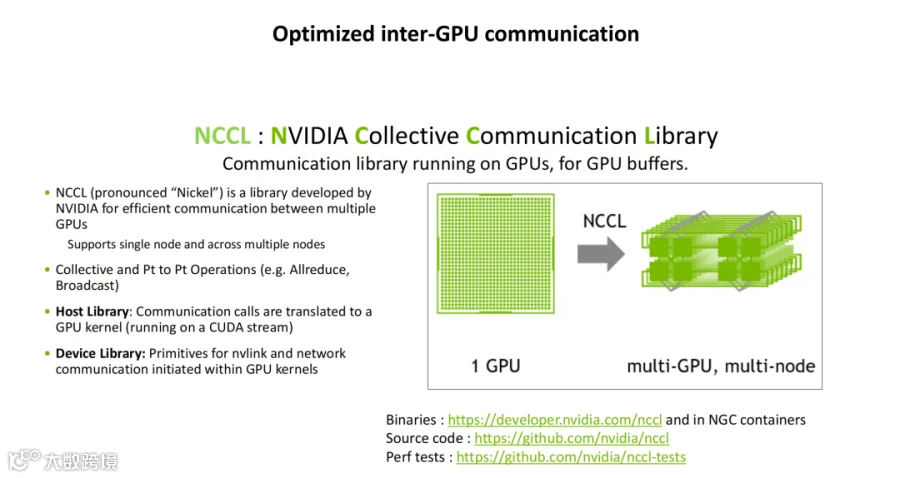
NCCL 作为 NVIDIA 专为 GPU 设计的通信库,支持单机内及跨节点的 all-reduce、广播和点对点传输。传统模式下,CPU 负责将通信指令插入 CUDA 流,随后 GPU 执行通信内核,数据传输依赖 NVLink、PCIe、InfiniBand 或 RoCE,且调度顺序主要由主机端控制。

单边传输:远端 GPU 的无感写入

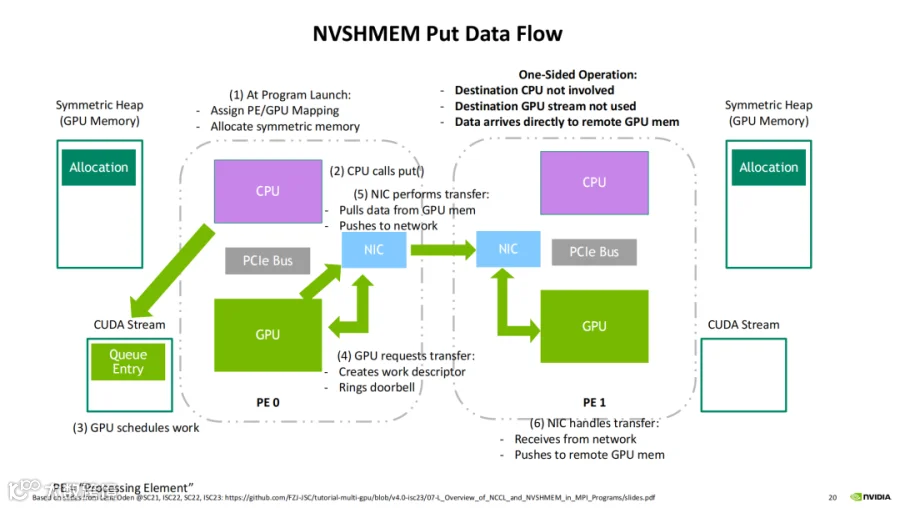
NVSHMEM 通过将多张 GPU 的部分显存组织为对称堆,使每个 GPU 拥有大小一致的地址空间。程序可利用统一偏移量直接定位远端缓冲区。
在此架构下,源端可发起 put 操作直接将数据写入远端 GPU 内存,无需目标端 CPU 参与或其 CUDA 流预先执行接收指令。网卡(NIC)从源显存读取数据,经网络写入目标端已登记的内存窗口,待数据到位后通过 signal 通知目标端 kernel 读取。
此类单边通信减少了双向同步等待,但资源分配与执行顺序仍需主机端预先规划。

内核自治:GPU Kernel 自主发起网络操作

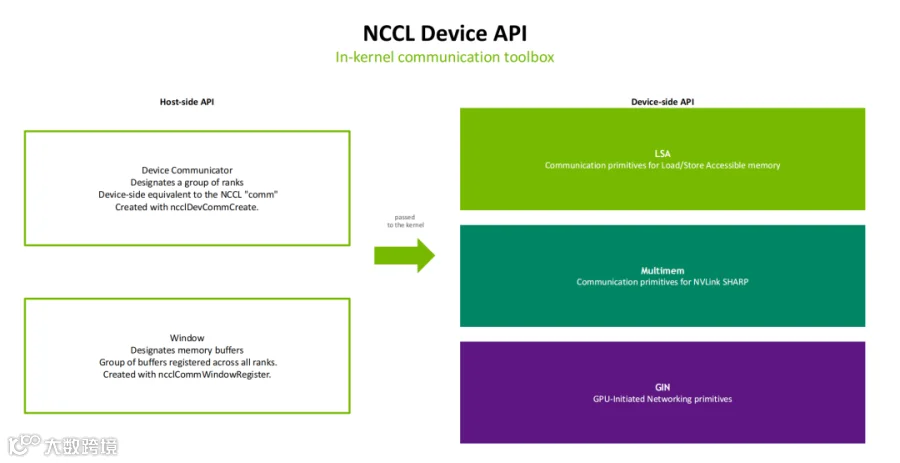
NCCL Device API 进一步下放控制权。主机端负责创建设备通信器、登记内存窗口并检查 LSA(Load-Store Access)与 GIN(GPU-Initiated Networking)能力;GPU kernel 获取句柄后,即可知晓参与者、缓冲区位置及线程协作关系。
LSA 允许一个 CTA(协作线程数组)直接获取对端窗口的可访问指针,通过常规 load/store 指令读取同组 GPU 数据,省去显式的 send/receive 轮次。
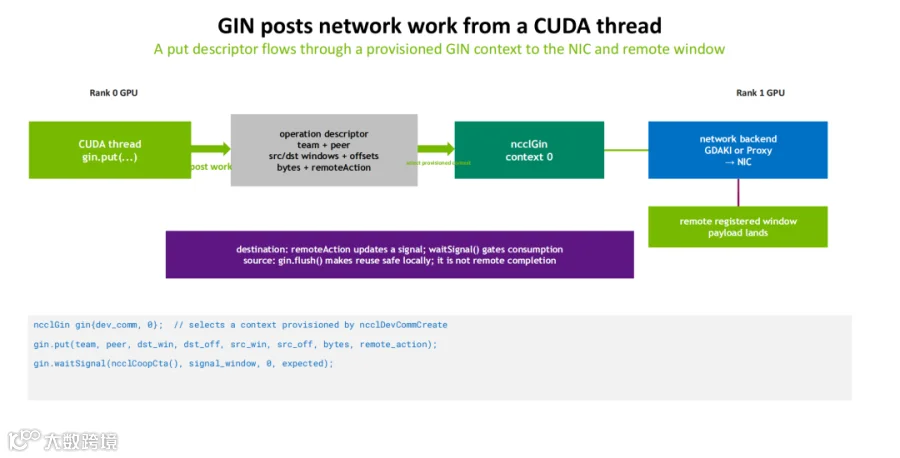
GIN 则将网络操作完全交由 CUDA 线程发起。线程将源/目标地址、字节数及远端动作封装为操作描述符,提交至预配置的 GIN 上下文,由网络后端和 NIC 完成数据投递。目标端仅在收到 signal 后消费数据,而源端的 flush 操作仅保证本地缓冲区可复用,不代表远端已完成写入。

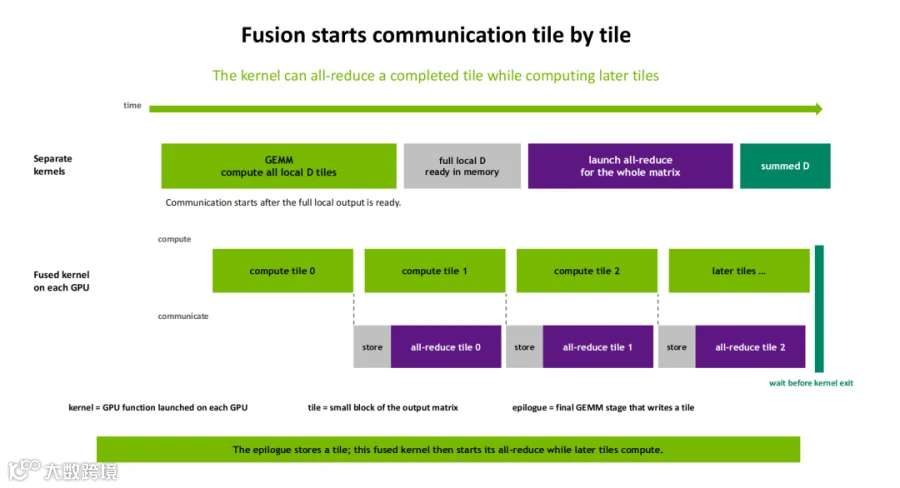
计算通信重叠:无需等待矩阵完整输出

MoE 场景下的高吞吐验证

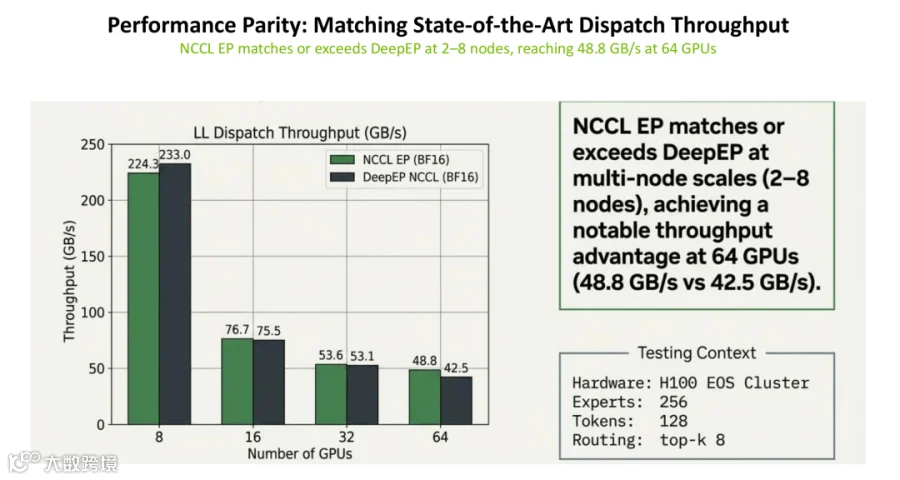
该技术在混合专家模型(MoE)中价值显著。MoE 需频繁且不规则地分发 token 并回收结果。NCCL EP 将 LSA 与 GIN 融入 dispatch 与 combine 流程。在 H100 EOS 集群测试中,64 卡配置下吞吐量达 48.8GB/s,优于对比方案的 42.5GB/s(测试条件:256 专家、128 token、top-k=8)。

GEMM 与 All-Reduce 的融合实践

更直观的应用是 GEMM 与 all-reduce 的融合。传统流程需等待整个矩阵乘法完成后再启动通信。融合 kernel 将输出划分为 tile(小块矩阵),每完成一个 tile 即启动对应的 all-reduce,同时 GPU 继续计算后续 tile。这种机制将串行流程改为计算与通信重叠,大幅压缩等待时间。
实现该融合需满足特定条件:每个 GEMM CTA 需使用设备可见的 NVSHMEM team,且参与通信的 block 必须保持驻留。只有预先配好 kernel、显存窗口、网络上下文及线程协作,才能有效实现重叠执行。

结语:通信即计算的一部分

主机侧 API 仍不可或缺,负责拓扑发现、能力检查及资源初始化。但运行时的变革在于:GPU 无需等待整块输出落地,也无需频繁回退至 CPU 请求传输。
随着 MoE 分发、张量并行及跨节点 all-reduce 成为训练主路径,通信性能的评估标准正从链路峰值带宽转向“数据何时进入网络”及“计算与传输的重叠度”。GPU 通信正从计算后的独立步骤,演变为嵌入计算 kernel 内部的持续动作。
【声明】内容源于网络
0
0
半导体产业报告
1234
内容 612
粉丝 1
半导体产业报告 1234
总阅读35.0k
粉丝1
内容612