本文作者:安筱鹏
题记
当 AI 智能体消耗的 Token 达到人类的 5 倍,数据究竟在被谁“使用”?2026 年 8 月,全球顶级投资机构 a16z 报告显示:今年 2 月,智能体的 Token 消耗才刚刚追平人类,半年后已是人类的 5 倍;与此同时,前沿企业与一般企业的 Token 消耗差距,从 2.6 倍悄然拉大到 8.3 倍。另一组事实更反直觉:某养猪企业以日 Token 消耗百亿量级,穿越艰难猪周期。数据的消费主体正在从人换成 AI,数据竞争力的密度正在被 Token 重新定义。在大数据产业博览会上,我们不谈流通、不谈确权、不谈入表,而是回到企业视角,追问数据要素的终极问题——如何提升核心竞争力,如何构筑自己的护城河。
本文主要观点源自 2026 年 8 月 29 日在贵阳举办的 2026 中国国际大数据产业博览会“词元——数据要素价值释放新路径”论坛上的主题分享,由阿里云智能副总裁、中国信息化百人会执委安筱鹏主讲,并根据演讲内容整理。
一、AI 时代的数据正在创造“真金白银”的价值
在数据要素主题的论坛上,我们跳出制度设计层面的讨论,回归企业视角:AI 时代数据对于企业的竞争力到底意味着什么?把议题锚定在竞争力与护城河上,可以将数据要素从政策概念拉回商业现实。
答案藏在三个反直觉的案例里:
首先是某养猪企业。养殖虽是传统第一产业,但其日 Token 消耗已达百亿量级,超过绝大多数第二产业巨头。在该行业,数据、Token 与 AI 深度咬合,帮助核心场景完成了从“人盯猪”到"AI 盯猪”的转变。
其次是美国公司 Harvey。它基于 100 亿 tokens 的案例法内容和 250 多个知识源,训练出法律专业垂直模型,服务超过 50% 的美国百强律所,估值超百亿美元,年化收入近 2 亿美元。
第三家是 OpenEvidence。它基于医疗领域独有的专业数据构建分析能力,覆盖 40% 以上的美国医生,估值 120 亿美元,成为全球生命科学领域最大的独角兽之一。
这三个案例的共同逻辑在于:竞争的关键不是“谁的模型更强”,而是谁率先构建了行业独有的数据资产并完成了 Token 化。数据竞争力的密度,与行业的“高低”无关,而与数据的排他性、实时性和嵌入业务流程的深度正相关。
麦肯锡报告指出,AI 落地效果不佳的主要原因,是 80% 的任务中 AI 无法获取上下文。这指向的不是 AI 能力不足,而是企业数据准备度不足。读懂私有数据,正在成为企业的核心竞争力。
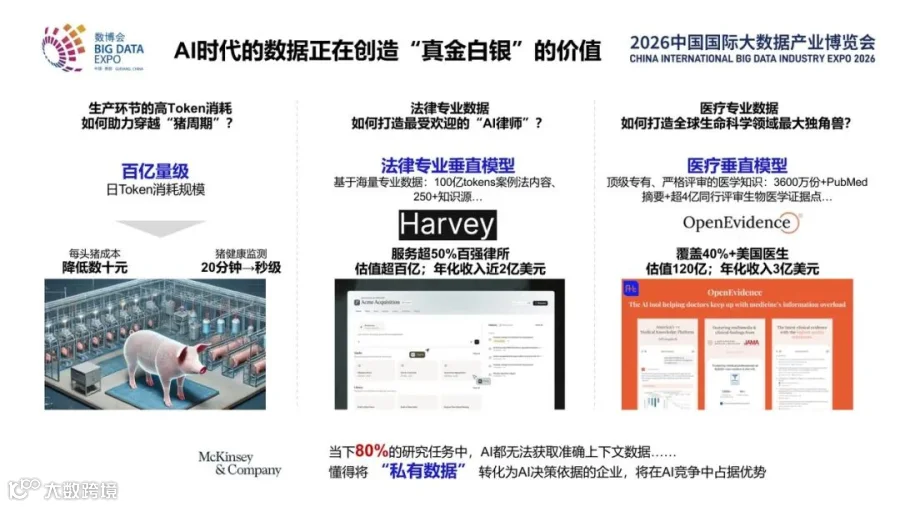
图 1|从三个案例,看 AI 时代数据创造的“真金白银”的价值
二、从 Digitalization 到 Tokenization:数据转化为竞争力的五种路径
谈论数据竞争力,必须厘清“数字化”与“数智化”的本质区别。二者并非同一条路上的先后阶段,而是两种不同的范式。
数字化(Digitalization)是将原子世界转换为比特;数智化(Tokenization)则是将已比特化的信息转换为可被 AI 加工的 Token。例如,手机拍照将电磁信号转为 0 和 1 是数字化;而将照片延展为视频、重构为声音,供大模型加工处理,则是 Tokenization。这是从数字化到数智化的价值跃迁。
在“原子→比特→Token→大模型→Token→比特→原子”的完整链路中,比特只是忠实记录,Token 才赋予数据“可被推理、可被生成、可被决策”的能力。中间那段"Token→大模型→Token",正是当前大多数企业尚未跨越的价值增量区间。
这意味着,过去十年在数字化上的投入(建系统、采数据、做报表)不会自动转化为 AI 时代的竞争力。数据的“量”不是问题,从比特到 Token 的“转化率”才是分水岭。过去的投入是门票,而非护城河。
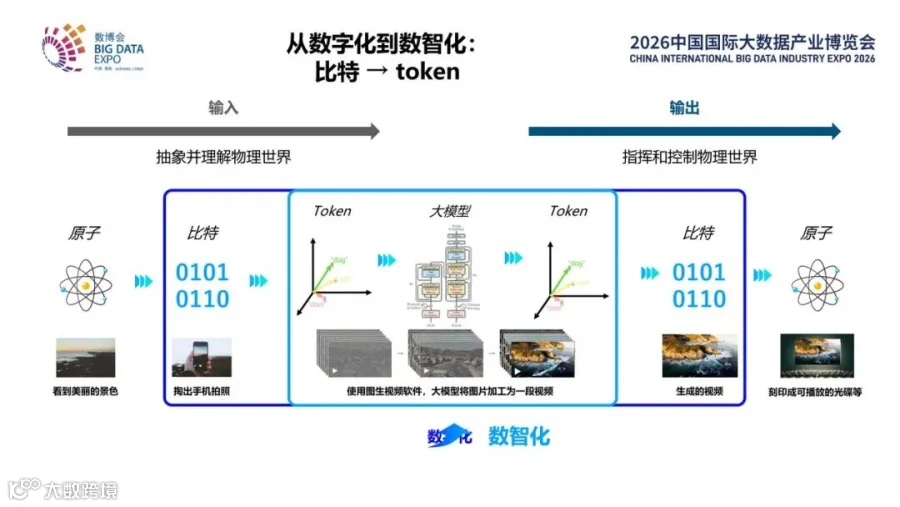
图 2|从数字化到数智化的完整链路:比特→Token
私有数据通过以下五种路径转化为竞争力,构成递进的壁垒阶梯:
- 将数据转化为模型预训练阶段的智能;
- 在预训练基础上,通过后训练和微调增强模型能力;
- 利用企业或行业数据构建基于 RAG 的知识库,实现检索与调用;
- 将数据、经验、流程、SOP 转化为企业和行业专属的 Skills;
- 让所有数据构建起模型使用时所需的上下文。
前两层的能力差距正被开源模型快速拉平;真正拉开差距的是后三层:RAG 提供外挂知识但仍可复制;Skills 封装了流程经验需长期积累;上下文工程深度绑定业务背景,几乎不可迁移。
当前许多企业反馈模型效果不佳,往往并非模型或算法问题,而是缺乏丰富的上下文。模型的竞争已经充分,上下文的竞争才刚刚开始。企业 AI 投入的重心,应从“选模型”转向“建上下文”。
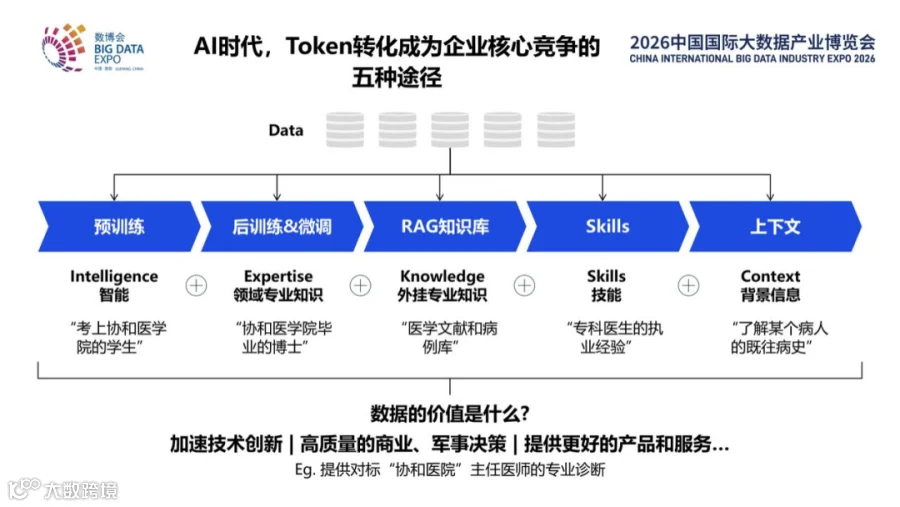
图 3|Token 转化为企业核心竞争力的五种途径与壁垒阶梯
三、Token 消耗的分化趋势:AI 时代的新“数字鸿沟”
Token 消耗的主体正在发生静默替换。a16z 报告显示,2026 年 2 月 AI 智能体的 Token 消耗首次超过人类用户,至 8 月已达人类用户的 5 倍。数据的消费主体从人切换到 AI,这是一次主体颠覆。
OpenAI 数据显示,前沿企业与一般企业在每月活跃用户输出 Token 上的差距,从 2.6 倍扩大到 8.3 倍;绝对值上前者已达后者的 17.1 倍。结论清晰:AI 时代的“数字鸿沟”,不再是“有没有上云”或“有没有用 AI",而是 Token 消耗的量级差。不用 AI 的企业与深度使用 AI 的企业之间的生产力差距正以指数级速度撕裂,后来者追赶成本将远高于先发者。
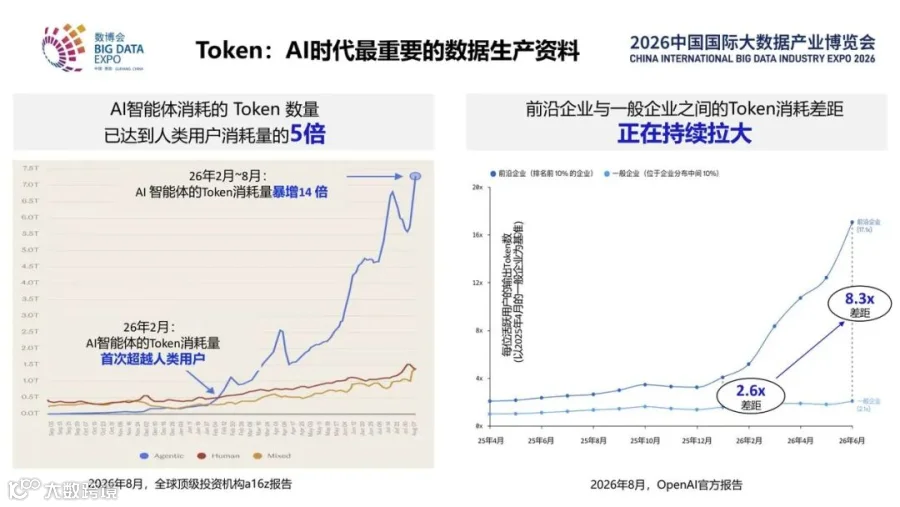
图 4|Token:AI 时代最重要的数据生产资料
通过两个案例具体感受 Token 如何转化为企业竞争力:
案例一:某养猪企业的数据壁垒
其壁垒来自四个维度叠加:特征精(1 万多名兽医经验标注为 80 余种独有标签)、体量大(330 多万台装备日新增 20 亿条数据)、链条全(全生命周期数据采集)、积累深(横跨多轮猪周期)。基于千问基座后训练的专属大模型,实现了多模态实时检测与秒级诊断,头均成本降低数十元,单人管理范围扩大 3 倍。最关键的是,其日 Token 消耗在 4 个月内增长数十倍,形成了数据喂养模型、模型优化决策、决策产生新数据的飞轮加速效应。
案例二:自动驾驶的数据处理升级
传统智驾研发是“手工小作坊”:硬盘快递回传、人工清洗标注、小集群训练,迭代周期以月计。领先企业则构建了“自动化生产线”:百万量产车数据实时上云,AI 自动标注与特征挖掘,大集群训练端到端模型,迭代周期缩短至数天。从“数月”到“数天”不仅是效率提升,更是竞争维度的根本转换。数据处理的工业化程度,直接决定谁能胜出。
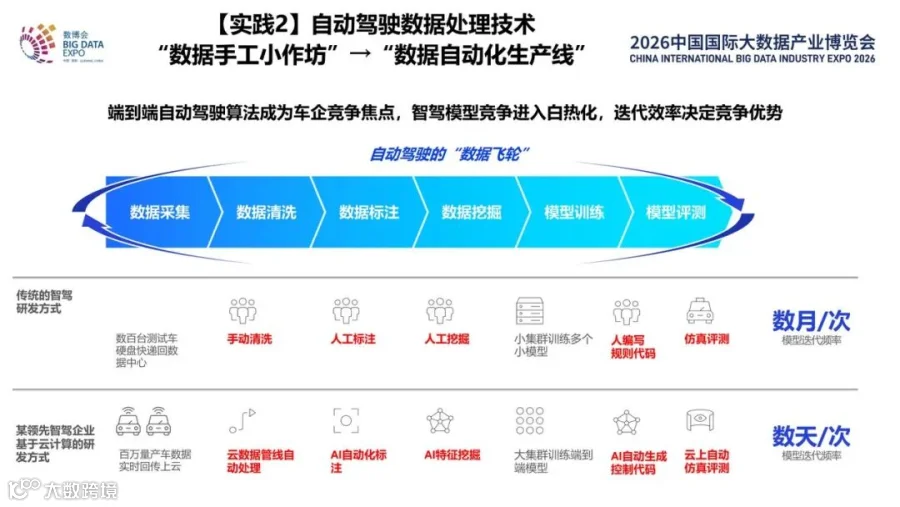
图 5|自动驾驶数据处理:从“手工小作坊”到“自动化生产线”
四、企业的下一步:三个平台、两个飞轮与两大趋势
要让数据与 Token 真正转化为竞争力,企业架构需要重写。AI 时代的企业架构正收敛为三大平台:
- 企业数据知识资产化平台:完成从采集、清洗、治理到 Token 化、向量化的全链路;
- 企业模型管理平台:覆盖持续预训练、微调、强化学习、评测与推理优化;
- 企业智能体开发运营平台:承担编排、多智能体协作、工具集成,以及智能体的运行时、身份、可观测与安全。
此外,还需构建两个飞轮:一是智能体交互数据回流形成“智能体运营飞轮”;二是模型后训练数据回流形成“模型训练飞轮”。两个飞轮咬合,确保企业 AI 成为“越用越聪明的活系统”。这一过程还需要新角色 FDE(Field Deployed Engineer)的介入,推动 AI 落地从“交付软件”转向“交付能力建设”。
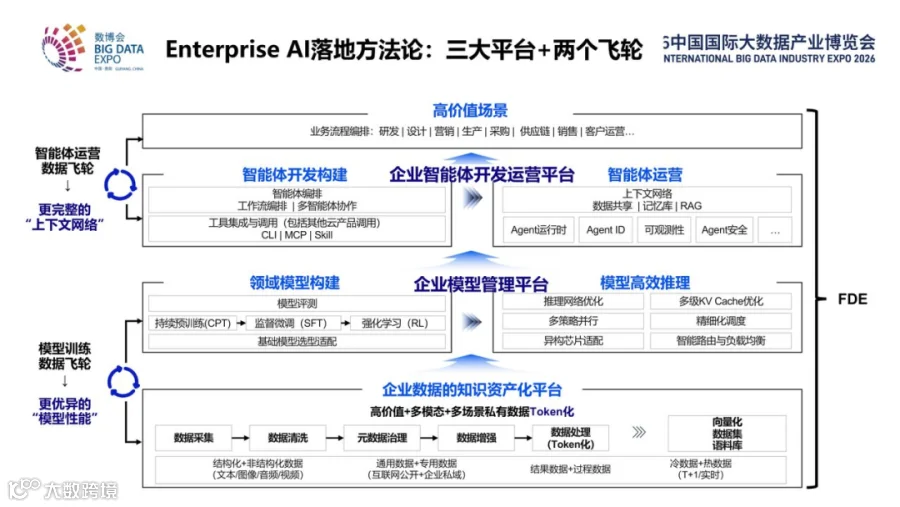
图 6|Enterprise AI 落地方法论:三大平台 + 两个飞轮
展望未来,两大趋势已然清晰:
趋势一:数据要素的升维
数据对象从结构化冷数据走向非结构化热数据;服务主体从服务人走向服务 AI,要求高频、实时、精准决策;处理技术从人编写规则代码走向 AI 自动化处理。企业系统正从记录系统进化为决策系统。
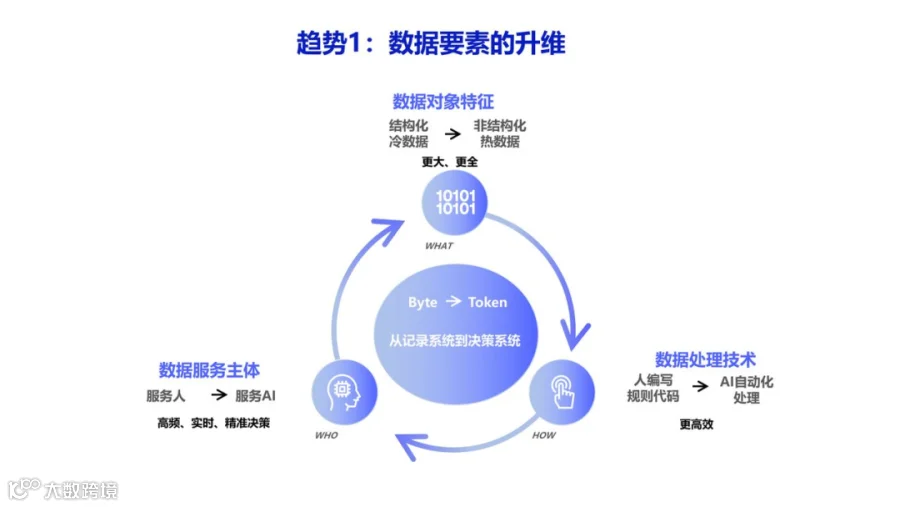
图 7|从对象特征、服务主体、处理技术,数据要素三方面升维
趋势二:超级智能体的崛起
SAP、Salesforce、Oracle 等全球软件巨头集体转向 Autonomous Enterprise 或 Agentforce。这表明 AI 正在对软件产品发起“斩首行动”:软件的入口层(脑袋)被智能体替代,功能层(身体)被原子化为 Skill、MCP 或 CLI。未来软件产业的价值将向“数据层”和“智能体平台层”两端集中。
回到核心问题:AI 时代,数据如何构筑企业的护城河?答案不在于存了多少数据或买了多强的模型,而在于把多少比特转化成了 AI 能理解、能推理、能决策的 Token,在于是否建起了别人拿不走的上下文、Skills 与飞轮。比特只是记录,Token 才是理解。当数据的消费主体已经从人换成 AI,这场跃迁,每一家企业最终都要完成。