

Agent 真正缺失的并非更长的 Context,而是一个能持续存在、可追溯且可纠正的“外部大脑”。
近年来在 Agent 领域的实践表明,模型智商已非瓶颈。Claude、GPT、Gemini、DeepSeek 等模型推理能力日益增强,Agent 也从简单问答进化为能查资料、写代码、调工具的多面手。然而,连续使用几天后便会发现一个核心痛点:Agent 缺乏长期记忆。
典型场景如:与 Claude Code 进行一下午对话,明确了数据库规范、环境隔离及文档格式,但次日开启新 Session 询问昨日结论时,它往往回答无法访问历史对话。许多人试图通过扩大 Context Window 或塞入历史聊天记录来解决,但这并非根本之道。Agent 急需的是一个独立于对话之外、长期存在且具备知识溯源与冲突处理能力的“外部大脑”。
这正是研究 GBrain 的初衷。它旨在解决比“让模型多看文档”更底层的问题:能否为 Agent 构建一个持续存在、可检索、可更新且可追溯的知识体系?本文将通过实战搭建过程,解析其核心逻辑与落地细节。
本文看点
01
编译式知识的核心定义
02
Brain-First 三条行为契约
03
跨 Session A→B 记忆实验
CLARIFY
GBrain 的本质定位
首先需明确误区:GBrain 既非简单的 Markdown 笔记库,也非单纯的向量数据库,更不能等同于传统的"RAG 检索”。
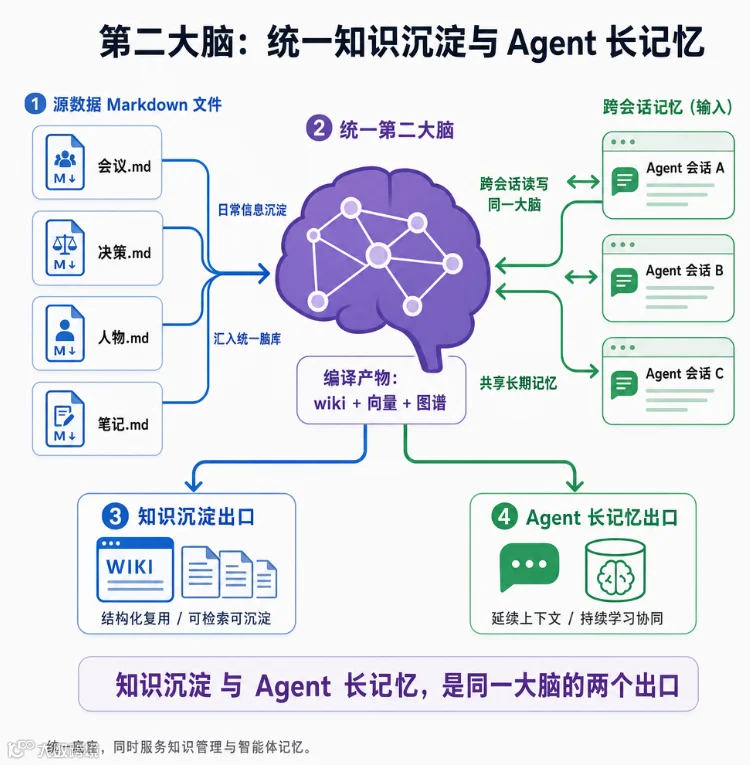
传统 RAG 流程(提问→Embedding→检索→生成)主要解决从海量文档中定位相关内容的问题。然而,Agent 的长期记忆需求更为复杂,涉及实体关系、当前状态、因果逻辑、时间维度及知识冲突等多重维度。真正的 Agent Memory 需处理 Knowledge、Entity、Fact、Relationship、Time、Source、State 等要素。GBrain 的核心价值在于将这些要素组织成一套可持续使用的结构化知识体系。
COMPILED
编译式知识:从“现查”到“预编译”
理解 GBrain 的关键在于“编译式知识”概念。若将普通 RAG 比作图书馆现场搜书,GBrain 则是在此之前已完成资料的整理、分类、索引构建及关系梳理。原始资料经解析后套用 Schema,提炼出 Entity 和 Fact,构建 Graph,最终形成一份 Agent 可直接调用的“编译好”的知识。
其核心不在于提问时临时检索,而在于将知识提前加工为 Agent 可理解的结构化数据。
GBrain 被定义为 compiled intelligence system,其链路为 Import → Structure → Link → Compile → Retrieve → Reason,远超传统 RAG 的 Query → Retrieve → Generate 三步走模式,解决了更深层次的知识应用问题。
INIT
实操:构建本地 Brain
GBrain 适合通过 PGLite 进行本地快速体验:
注意:GBrain 迭代迅速,请勿照搬旧版教程,应以官方文档关于本地初始化、PGLite 及 MCP 的最新指引为准。
初始化后的 Brain 是一个包含 Knowledge、Entity、Fact、Graph、Timeline 等容器的空壳,随后需进行数据导入。
SCHEMA
Brain 的数据结构
知识库的价值不在于 Markdown 文件本身,而在于其中的关系链与因果链。成熟的 Knowledge Brain 应包含以下基本对象:
Page
知识的具体载体,如项目文档文件。
Entity
现实世界中的对象,如人员、项目、公司。
Fact
关于实体的具体事实,如人员负责关系。
Timeline
记录事实发生与变更的时间点。
Graph
连接上述对象的关系网络。
GBrain 默认采用 gbrain-base-v2 schema,对应规范的分类体系。需区分“导入文档”与“建立知识”,前者仅是数据搬运,后者才是构建 Brain 的核心。
IMPORT
知识导入与同步
目录创建后可执行导入:
若资料持续变动,可使用 gbrain sync --watch 实现自动同步。建议初次尝试少量文档,重点验证 Agent 能否从中建立关系并复用,而非单纯测试存储容量。
建议初期仅导入少量文档,重点验证关系构建能力。
THINK
从 Search 到 Think:知识的综合应用
基础 Search 功能可快速定位文档,但复杂问题(如综合会议记录与人员信息判断项目负责人)需要更深层的处理链路:Search → 定位 Entity → 关联 Graph → Synthesis。GBrain 的 think 类能力正是为此设计,它将知识库从单纯的 Storage 升级为 Agent 推理所需的 Reasoning Substrate。
GOVERNANCE
知识治理:识别未知与冲突
企业 AI 的最大风险在于“一本正经地胡说八道”。优秀的知识系统应具备自我认知能力:有依据时给出带出处的回答;无数据时坦诚“信息不足”;面对冲突(如销售与财务数据不一致)时,应标记“存在冲突”而非随意选择。Knowledge Governance 的核心在于确保知识的可信度。
MCP
集成 Claude Code
GBrain 可通过 MCP 暴露能力供 Agent 调用。以 Claude Code 为例,注册命令如下:
确认列表中出现 gbrain: gbrain serve - Connected 即表示连接成功。注意务必添加 --scope user 参数将其注册为用户级 MCP,避免因切换工作目录导致工具失效。
PITFALL
MCP 接入后的“失忆”陷阱
即便接入了 Memory 工具,Agent 仍可能因未主动调用而“失忆”。工具仅提供能力,是否使用取决于 Agent 的行为策略。许多宣称支持跨会话记忆的失败案例,皆因忽略了这一层行为引导。
工具提供的是能力,行为决定的是 Agent 是否真的会用这个能力。
PROTOCOL
Brain-First Protocol:行为契约
解决上述问题的关键在于 Brain-First Protocol,包含三条核心契约:
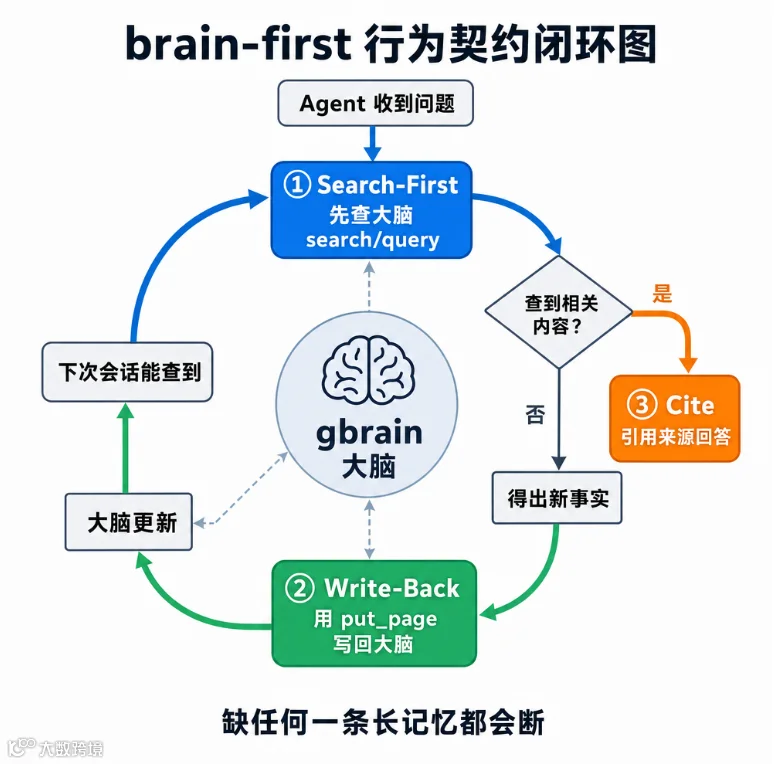
Search-First:回答涉及历史、偏好、规则等问题前,必须先查询 Brain。
Write-Back:产生新的长期有效事实(如项目规则)后,必须写回 Brain。
Cite:使用知识时必须标明来源,确保可追溯性。
这三条规则构成闭环:Search-First 解决“读得到”,Write-Back 解决“存得下”,Cite 解决“信得过”。
EXPERIMENT
跨会话记忆验证实验
验证跨会话记忆的标准实验步骤:
Step 1 · Session A 写入事实
让 Agent 通过 MCP 将特定事实(如 Brain-First Protocol 规则)写入 Brain,并验证写入成功。
Step 2 · 彻底关闭 Session A
完全退出 Session A,确保无任何上下文残留。
Step 3 · Session B 主动检索
在无历史的 Session B 中询问相关事实。若 Agent 能准确复述并注明来源,证明知识已成功经由 Brain 从 A 传递至 B。
至此,记忆才真正从 Conversation Context 迁移为 External Persistent State。
TIMELINE
事实演变与时间线追踪
真正的 Memory 系统需能处理事实变更。例如测试数据库从 test-db-01 变更为 test-db-02,系统不仅应返回最新状态,还需记录变更时间及新旧事实对比。GBrain 通过"compiled truth + 完整时间线”的设计,确保既能回答“现在什么是真的”,也能追溯“过去发生过什么”。
DECAY
Memory 的腐化与治理
长期运行的 Brain 可能面临知识漂移、重复录入、冲突矛盾、过时信息及自我投毒(Agent 写入错误事实并被引用)等问题。GBrain 提供 lint、doctor、dream 等工具进行运维,其中 dream 专注于发现潜在问题而非自动修改,体现了“发现问题与修正事实分离”的治理原则。
TEAM
从个人 Brain 到团队基础设施
进阶形态是团队共享 Brain,涉及权限管理、数据隔离、审计追踪及生命周期管理等企业级需求。理想架构应通过 Connector 自动接入 Slack、Git、CRM 等多源数据,实现自动化导入与编译,使 Brain 成为持续更新的知识系统,而非静态库。
COMPARE
GBrain 与竞品边界
不同方案侧重点各异:Mem0 擅长用户偏好等轻量记忆;Zep 侧重时间关系与对话图谱;Letta 聚焦 Stateful Agent 自主运行。GBrain 的核心优势在于将多来源、半稳定的知识与实体关系编译为 Compiled Brain。
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
选型关键不在于谁最强,而在于明确 Agent 究竟缺少哪一种记忆。
HYBRID
混合架构:更现实的落地方案
企业场景通常混合了稳定知识(手册、规范)与动态数据(工单、库存)。最优解是混合架构:Compiled Brain 处理稳定知识,RAG 处理实时文档,API 获取业务状态,Memory Layer 记录用户偏好。
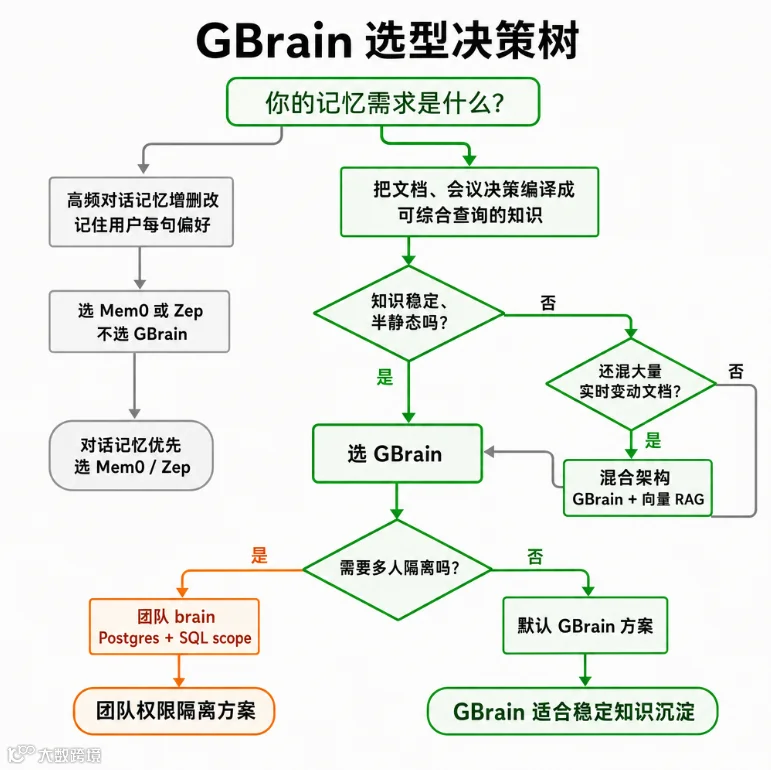
决策前需厘清三点:
1. 记用户还是记知识?偏好选 Memory Layer,业务规则选 Knowledge Brain。
2. 变化快慢?稳定做编译,多变走 RAG/API。
3. 共享范围?个人用 Local Brain,团队需加权限与审计。
THE END
结语
Agent 不应是每次见面都重置记忆的陌生人,而应是知晓项目背景、决策历史与业务规则的可靠同事。这需要模型、Context、Tools、Memory、Knowledge、State 与 Governance 的完整协同。
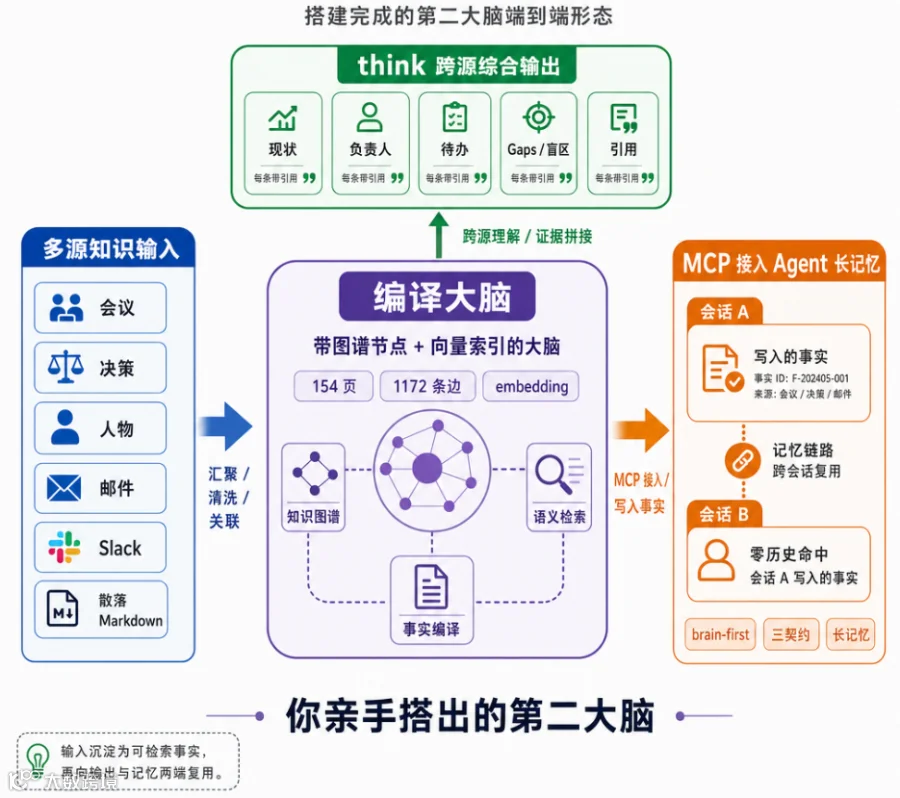
未来的方向是从“给 Agent 找资料”转向“为 Agent 构建一个持续存在的知识世界”。在这个世界里,历史可追溯,新知可写入,旧误可纠正,争议可标记。这或许才是 RAG 之后,Agent 进化的终极形态。
END