

哈喽,大家好~
最近有同学问:“两个特征都很重要,为什么模型只盯着其中一个?”
很多时候,不是模型偏心,而是特征的量纲差距太大。一个特征取值在 附近,另一个动不动就是几千,模型计算时自然更关注后者。
我们就来聊聊机器学习中非常常用的数据预处理方法,数据标准化。
为什么要做数据标准化
假设我们用“身高”和“月薪”判断一个人的运动习惯:
-
身高大约在 厘米; -
月薪大约在 元。
如果直接计算距离,月薪相差 元产生的影响,会远大于身高相差 厘米。这样一来,月薪几乎掌握了全部话语权。
以KNN为例,它需要计算样本之间的欧氏距离:
其中, 和 表示两个样本在第 个特征上的取值, 表示特征数量。
当某个特征的数值特别大时,它在距离中占据主导地位。标准化要做的事情,就是把不同特征拉回相近的尺度。
KNN、SVM、逻辑回归、神经网络都很关注特征尺度;决策树、随机森林主要根据切分点工作,对标准化没有那么敏感。
标准化的核心原理
最常见的是Z-score标准化:
这里, 是原始值, 是该特征的均值, 是标准差, 是转换后的结果。
例如某个特征均值为 ,标准差为 。当 时:
这表示该数值比均值低 个标准差。
标准化后,每个特征的均值接近 ,标准差接近 。注意,它并不会把数据压缩到 ,这是标准化与归一化最容易混淆的地方。
一个完整案例
我们生成一个二分类数据集,然后故意制造量纲差异:
-
特征1乘以 ; -
特征2乘以 ; -
使用KNN完成分类; -
对比标准化前后的决策边界、交叉验证结果和测试集指标。
大家可以把代码执行~
import numpy as np
import matplotlib.pyplot as plt

from matplotlib.colors import ListedColormap
from sklearn.datasets import make_classification
from sklearn.model_selection import (
    train_test_split, StratifiedKFold, cross_val_score
)
from sklearn.neighbors import KNeighborsClassifier
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import make_pipeline
from sklearn.metrics import accuracy_score, f1_score, roc_auc_score

# 1. 数据集
X, y = make_classification(
    n_samples=900,
    n_features=2,
    n_redundant=0,
    n_informative=2,
    n_clusters_per_class=2,
    class_sep=1.25,
    flip_y=0.06,
    random_state=42
)

# 人为制造量纲差异
X[:, 0] *= 0.1
X[:, 1] *= 1000

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.25,
    stratify=y, random_state=42
)

# 2. 通过交叉验证选择K
ks = np.arange(1, 42, 2)
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)

raw_mean, raw_std = [], []
std_mean, std_std = [], []

for k in ks:
    raw_model = KNeighborsClassifier(n_neighbors=k)
    std_model = make_pipeline(
        StandardScaler(),
        KNeighborsClassifier(n_neighbors=k)
    )

    raw_scores = cross_val_score(
        raw_model, X_train, y_train, cv=cv,
        scoring="accuracy", n_jobs=-1
    )
    std_scores = cross_val_score(
        std_model, X_train, y_train, cv=cv,
        scoring="accuracy", n_jobs=-1
    )

    raw_mean.append(raw_scores.mean())
    raw_std.append(raw_scores.std())
    std_mean.append(std_scores.mean())
    std_std.append(std_scores.std())

best_raw_k = ks[np.argmax(raw_mean)]
best_std_k = ks[np.argmax(std_mean)]

raw_model = KNeighborsClassifier(n_neighbors=best_raw_k)
std_model = make_pipeline(
    StandardScaler(),
    KNeighborsClassifier(n_neighbors=best_std_k)
)

raw_model.fit(X_train, y_train)
std_model.fit(X_train, y_train)

print("Best raw K:", best_raw_k)
print("Best standardized K:", best_std_k)
这里使用Pipeline把标准化和模型绑在一起。交叉验证时,StandardScaler只会使用当前训练折的数据计算均值和标准差,避免数据泄漏。
标准化如何改变决策边界
x_min, x_max = X[:, 0].min() - 0.05, X[:, 0].max() + 0.05
y_min, y_max = X[:, 1].min() - 300, X[:, 1].max() + 300

xx, yy = np.meshgrid(
    np.linspace(x_min, x_max, 450),
    np.linspace(y_min, y_max, 450)
)
grid = np.c_[xx.ravel(), yy.ravel()]

models = [
    ("Raw features", raw_model),
    ("Standardized features", std_model)
]

point_cmap = ListedColormap(["#00D9FF", "#FF2E88"])
area_colors = ["#3DE8D0", "#FF5FA2"]

fig, axes = plt.subplots(1, 2, figsize=(14, 5.5))

for ax, (title, model) in zip(axes, models):
    pred = model.predict(grid).reshape(xx.shape)

    ax.contourf(
        xx, yy, pred,
        levels=[-0.5, 0.5, 1.5],
        colors=area_colors, alpha=0.30
    )
    ax.contour(
        xx, yy, pred,
        levels=[0.5], colors="#6A00FF",
        linewidths=2
    )
    ax.scatter(
        X_test[:, 0], X_test[:, 1],
        c=y_test, cmap=point_cmap,
        s=28, edgecolors="white", linewidths=0.5
    )

    ax.set_title(title, fontsize=14, fontweight="bold")
    ax.set_xlabel("Feature 1")
    ax.set_ylabel("Feature 2")
    ax.grid(alpha=0.15)

plt.suptitle("KNN Decision Boundary: Raw vs Standardized",
             fontsize=16, fontweight="bold")
plt.tight_layout()
plt.show()
左图是原始数据,KNN的距离几乎被数值巨大的特征2控制。右图经过标准化后,两个特征可以共同参与距离计算,决策边界也更贴合样本结构。
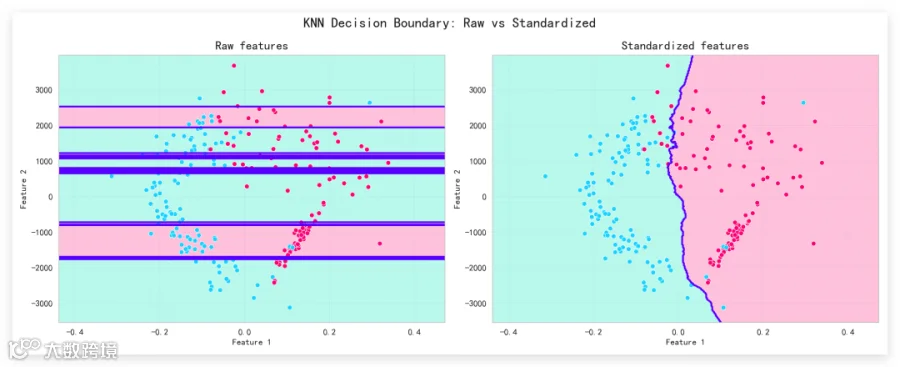
也就是,标准化没有改变样本关系,而是重新平衡了每个特征的发言权。
比较不同K值和模型指标
def evaluate(model):
    pred = model.predict(X_test)
    prob = model.predict_proba(X_test)[:, 1]

    return [
        accuracy_score(y_test, pred),
        f1_score(y_test, pred),
        roc_auc_score(y_test, prob)
    ]

raw_metrics = evaluate(raw_model)
std_metrics = evaluate(std_model)

raw_mean, raw_std = np.array(raw_mean), np.array(raw_std)
std_mean, std_std = np.array(std_mean), np.array(std_std)

fig, axes = plt.subplots(
    2, 1, figsize=(11, 9),
    gridspec_kw={"height_ratios": [2, 1.3]}
)

# 上图:交叉验证曲线
axes[0].plot(
    ks, raw_mean, color="#FF7A00",
    marker="o", linewidth=2, label="Raw"
)
axes[0].fill_between(
    ks, raw_mean - raw_std, raw_mean + raw_std,
    color="#FFB000", alpha=0.20
)

axes[0].plot(
    ks, std_mean, color="#7B2CFF",
    marker="s", linewidth=2, label="Standardized"
)
axes[0].fill_between(
    ks, std_mean - std_std, std_mean + std_std,
    color="#B66DFF", alpha=0.20
)

axes[0].axvline(
    best_std_k, color="#00B894",
    linestyle="--", label=f"Best standardized K={best_std_k}"
)
axes[0].set_title("Cross-validation Accuracy with Different K")
axes[0].set_xlabel("Number of Neighbors")
axes[0].set_ylabel("CV Accuracy")
axes[0].legend()
axes[0].grid(alpha=0.2)

# 下图:测试集指标
labels = ["Accuracy", "F1", "AUC"]
pos = np.arange(len(labels))
width = 0.34

axes[1].bar(
    pos - width / 2, raw_metrics, width,
    color="#FF7A00", label="Raw"
)
axes[1].bar(
    pos + width / 2, std_metrics, width,
    color="#7B2CFF", label="Standardized"
)

axes[1].set_xticks(pos)
axes[1].set_xticklabels(labels)
axes[1].set_ylim(0, 1.05)
axes[1].set_ylabel("Score")
axes[1].set_title("Test-set Performance")
axes[1].legend()
axes[1].grid(axis="y", alpha=0.2)

plt.tight_layout()
plt.show()

print("Raw metrics:", np.round(raw_metrics, 4))
print("Standardized metrics:", np.round(std_metrics, 4))
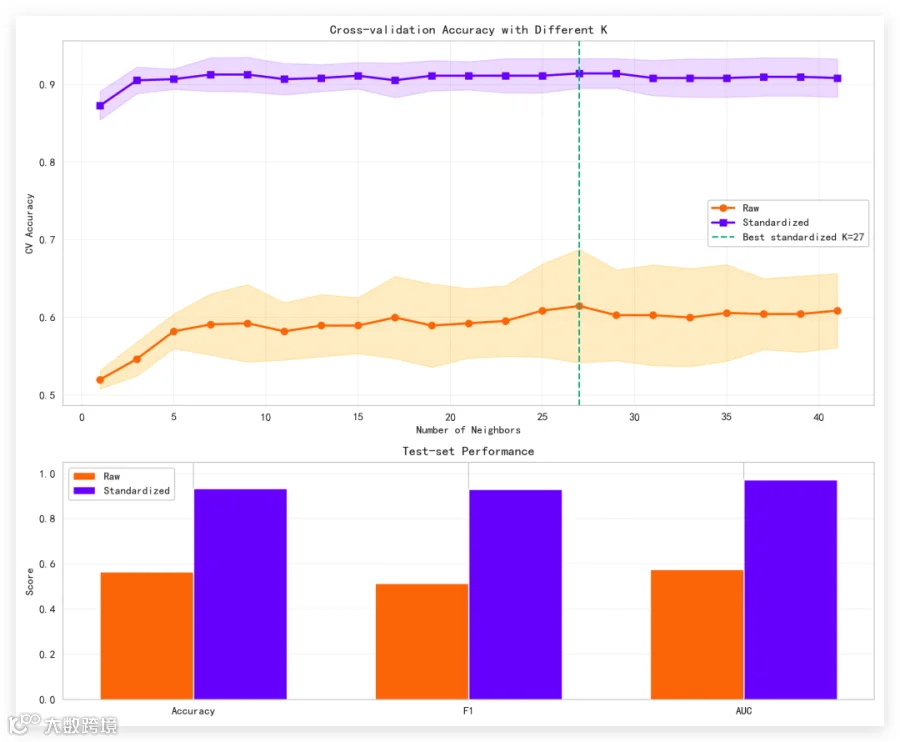
上半部分展示不同 值下的交叉验证准确率,阴影表示不同折之间的波动。曲线越高、阴影越窄,说明模型效果越好、稳定性也越强。
下半部分同时比较Accuracy、F1和AUC。我们这里不只看准确率,是为了避免单个指标带来的片面判断。
注意点
最重要的一点是:只能使用训练集计算均值和标准差。测试集必须沿用训练集得到的
和
,不能重新fit。使用Pipeline就是最省心的做法。
如果数据中有大量极端值,均值和标准差会受到影响,这时可以尝试RobustScaler。对于独热编码后的
特征,通常不需要直接标准化;对于稀疏矩阵,则要注意设置with_mean=False。
最后
数据标准化的核心,不是让数据“看起来整齐”,而是消除量纲差异,让模型公平地使用每个特征。对于KNN、SVM、逻辑回归和神经网络,它往往还是训练稳定、参数可调的基础。