


导读
摘要:手工、自动化、数字化混着跑的工厂,数据治理从哪下手?先立三层模型,再走六步闭环,用"产线可用"验收。
数据治理的第一步,不是补自动化,也不是上大屏,而是给产线立三层模型——静态、动态、治理。
这篇文章讲清三件事:验收标准只有一条——产线可用;关键动作只有一个——给产线立模型;落地路径只有一条——盘、模、接、治、用、运,顺序不能反,基础不牢别谈 AI。
同一条产线上,一头还是纸质工单,另一头已经在自动上传数据。
有的工序靠老师傅记录和口头交接;有的设备 PLC 天天在采数,却没几个人看;有的区域 SCADA、MES、ERP 都在跑,彼此之间互不通气。
这不是哪家厂没跟上,这是大多数工厂的长期状态:不是"没数字化",而是"不均匀地数字化"。
工业智能的基础是数字化,数字化的基础是数据接入。可当同一个厂里手工、自动化、数字化同时存在,很多人的第一反应是:把落后的补上来。
补自动化当然对,但它解决不了眼下的数据问题——设备改造以年计,而产线的数据每天都在产生。
等不起的这段时间里,最该先做的事,恰恰是把模型立起来。
先把验收标准定下来:产线可用
做数据治理之前,先回答一个问题:做给谁看?
工业数据治理的核心目标只有一个:服务产线、确保产线可用。离开这条标准,治理很容易跑偏——变成比谁接的点位多、谁的报表漂亮。
产线不关心报表,它只关心三件事:
可信:数据准不准、有没有出处、口径是否一致。调度敢不敢按它做决定,全看这一点。
可控:谁能看、谁能改、数据流向哪里。出了异常,能不能查到源头、及时止损。
可靠:该到的时候到不到、断不断。产线三班倒,数据也不能停。需要建立兜底机制解决数据传输问题的风险
这三条,就是数据上线前的验收单:一条不满足,宁可不接。
数据治理做得好不好,不看报表有多漂亮,要看产线敢不敢用它做决定。
第一步不是接数据,是给产线建模
那具体怎么接?
很多工厂的做法是:MES 连 ERP,ERP 连 SCADA,设备直连平台,一个系统对一套接口。结果是接口越接越多,像一张蜘蛛网;换个系统,全部重来;手工环节的数据,永远进不了这张网。
换个思路:不按系统接,按产线里的"对象"建模。设备、物料、工单才是数据的天然挂点——系统只是对象的一件衣服,衣服会换,对象不换。
一个完整的产线模型,要覆盖三层:
-
• 静态:实体、属性、关系——有什么,长什么样。 -
• 动态:状态、事件、动作、时间——在发生什么,此刻怎样。 -
• 治理:约束、标识、责任、质量——凭什么可信、可控、可靠。
下面逐层展开。
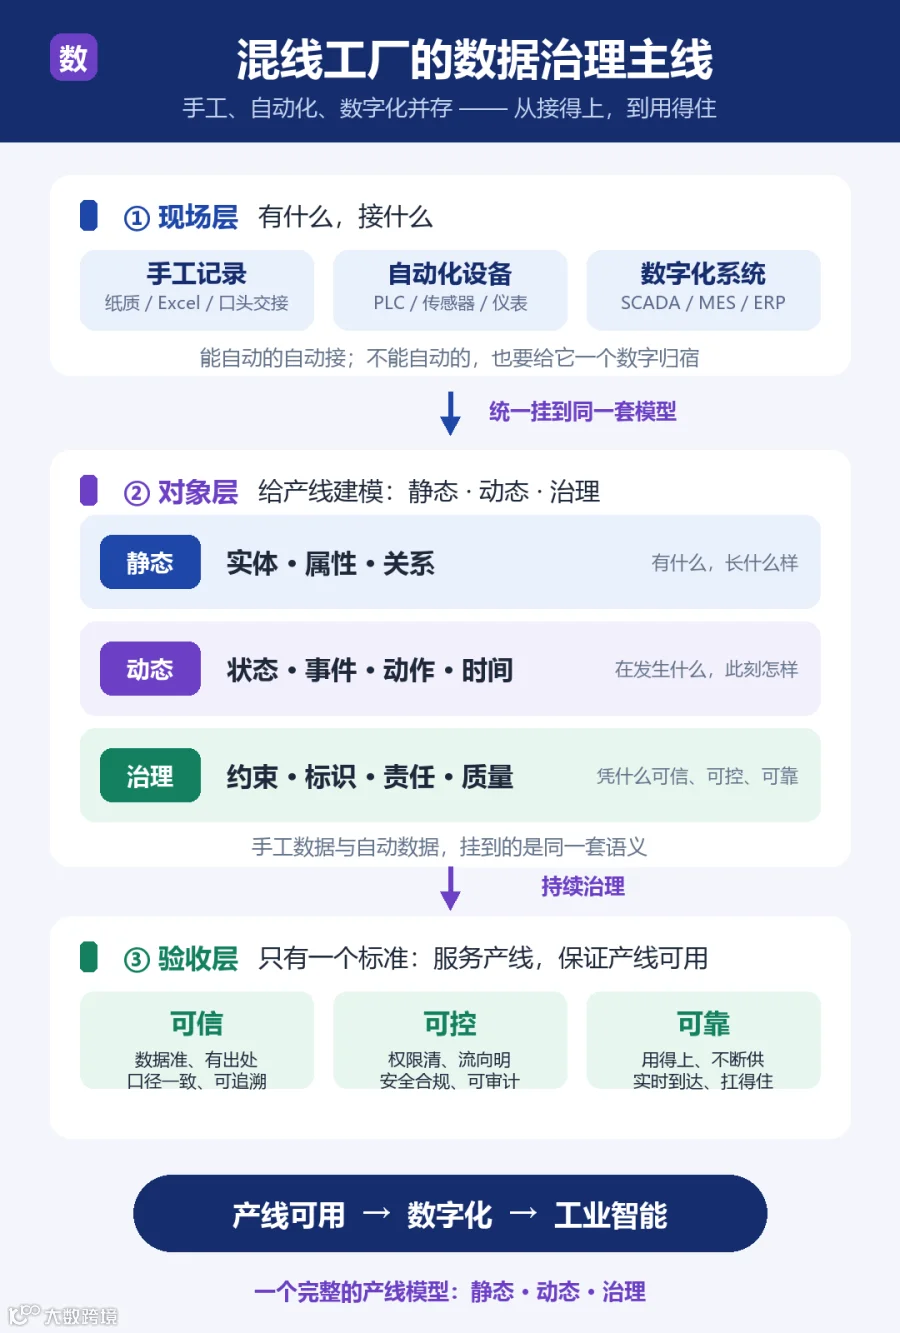
静态层:先说清"有什么"
静态回答的是:产线上有哪些对象,它们长什么样。
-
• 实体:设备、物料、工单、人员。数据的"户口"。 -
• 属性:型号、规格、量纲、精度、采样频率。同一个实体在不同系统对不对得齐,全看属性口径。 -
• 关系:谁属于谁、谁加工谁、谁供应谁。设备挂在产线上,工单落在工序上。
这一层最像"档案"。不管数据是手工来的还是自动来的,先得知道记的是谁、记的是什么。
手工时代,这些信息也在——在台账上、在交接班本里。建模不是发明新东西,是让它们变成数据世界里有名有姓的成员。
动态层:再说清"在发生什么"
动态回答的是:产线此刻怎么样,正在发生什么。
-
• 状态:运行、停机、维修、待料。产线此刻什么样。 -
• 事件:报警、故障、工艺切换的触发点。状态为什么变,答案在事件里。 -
• 动作:派工、切换、报工、停机。下一步做什么。 -
• 时间:每个状态和事件发生在哪一刻。产线数据时序相关,没有时间,一切都对不上。
这一层最容易漏掉事件。只记状态、不记事件,就像只有病历、没有病因——知道它停了,不知道为什么停。
举个例子:"3 号炉当前温度"是状态。有传感器的设备自动采,手工工序按规程人工录。温度超限是事件:自动设备自己报,手工工序由操作工按规程上报。来源成熟度不同,但在模型里,它们是同一个字段、同一个口径。
治理层:最后回答"凭什么信"
数据挂上模型还不够,还要回答三个问题:可不可信、谁负责、能不能用。
-
• 约束:工艺范围、节拍、公差。什么允许,什么不允许——数据合不合规,规则说了算。 -
• 标识:设备和物料有没有统一编码。同名不同物、同物不同名,是数据打架的源头。 -
• 责任:谁录、谁改、谁审核。每一行数据都要能追到人。 -
• 质量:准不准、全不全、有没有出处。质量规则不是事后检查,要在接入时就带上。
对应到数据管理里:约束与标识属"数据标准",责任属"数据治理与安全",质量属"数据质量"——这正是能力域划分。
静态是骨架,动态是血肉,治理是免疫系统。
落地六步:盘、模、接、治、用、运
模型是地图,流程是走路。真正落地,顺序一步都不能反——不盘清不建模,不建模不接入,不验收不上线,不用起来不算数。
六步归三段:盘、模——把模型立起来;接、治——让数据通起来;用、运——把价值做出来。
① 盘:盘清家底,先别接数据。
以产线为轴,从原料进场走到成品出厂,逐道工序问四件事:谁在做、数据在哪里(纸、表,还是系统)、成熟度是哪一档、痛点是什么。
产出的不是一份报告,是三张清单:对象清单、数据源清单、成熟度与痛点地图。同时定人:业务牵头、IT 支撑,每条产线都有明确的数据责任人。这一步先不产出数据,只产出建模的底稿。
② 模:立好模型,把语言的规则定下来。
就是前面说的静态、动态、治理三层。再统一编码与口径:设备、物料、工序各一套编码;"产量""停机"这些词,全厂只允许一个定义。
存量系统不用推倒重来——治理在模型层做,系统是衣服,模型才是身体。
③ 接:分级接入,先接影响产线可用的。
排序标准不是系统新旧,而是"缺了它,产线会不会出事"。
能自动的,走自动化通道:PLC、传感器、SCADA,用 OPC UA(IEC 62541)这类标准协议,或者 MQTT(ISO/IEC 20922)加 Sparkplug B 这类消息规范。
接不了系统的环节,留人工入口——扫码报工、终端录入都算接入。前提是:进模型、进流程、有人负责。命名层级可参照 ISA-95(IEC 62264)的"企业—工厂—区域—工作中心—工作单元"。
数据接得全,不如接得清楚;接得清楚,才治得下去。
④ 治:上规则,每一步都过验收。
规则不贪多,按验收标准来:质量与口径保"可信"(准不准、全不全、一数一源);权限与留痕保"可控"(谁能看、谁能改、可审计);时效与容错保"可靠"(到得及时、不断供)。
发现异常,不是躺在报表里,而是自动回到责任岗位。每一批数据上线前,用"可信、可控、可靠"过一遍:一条不满足,就不放行。
⑤ 用:找个场景,跑通闭环。
选一个产线痛点——设备异常响应、瓶颈工序进度、质量追溯——让数据能触发动作:报警、派工、叫停。
数据一旦能驱动动作,业务方就会主动要数据。到这一步,治理才算被证明有价值。
⑥ 运:把治理变成日常,再谈智能。
定度量(数据质量、场景使用率、问题闭环率),写进岗位职责;模型和规则复制到下一条产线——复制的是模型,不是又上一套系统。
基础扎实了,再往模型治理和 AI 走。
有人会问:这么一步步走,是不是太慢?混线工厂最怕的从来不是慢,是接了一堆数据,产线一样用不上。
别倒着来:先基础,再智能
最后说顺序。
"传统数据治理是基础,AI 数据治理是升级,两者相辅相成、不可或缺。"顺序做反,代价很大。
传统治理的对象主要是数据本身:主数据、业务数据、报表数据,管的是标准、质量、权限。
到了 AI 阶段,治理对象扩展到"数据 + 模型 + 训练与推理过程 + 输出结果"——数据治理的一次小疏漏,会变成模型每一次回答的偏差。
治理清单也跟着加长:偏见与公平、幻觉与事实一致性、数据与模型双重安全、可解释与可追溯。这些不是等模型上线才想,而是在数据阶段就要埋好伏笔。
基础不牢,模型越聪明,错得越快。
所以路线图是四步:夯实数据治理基础 → 建立模型治理体系 → 构建 AI 运营闭环 → 释放业务价值。混线工厂也不例外,只是基础这一段,要走得更扎实。
回到车间
不用等全厂自动化,从一条产线开始,先做四件事:
一,盘:挑痛点最明显的那条产线,一页纸盘清对象、数据源、成熟度和痛点。
二,模:把这条产线的核心对象(设备、物料、工单)统一编码和口径。
三,接与治:接一批、验一批,"可信、可控、可靠"不过关就不上线。
四,用:挑一个能触发动作的场景跑通,让产线先尝到甜头。
不是把工厂推倒重来,而是让三种方式,说同一种语言。
如果你们厂也在手工、自动化、数字化混着跑,把这篇文章转给负责数字化的同事——先盘清,再建模,再接入。