AI 前沿 · JEV
一个不会说话的模型,凭什么爆火
写不出一个字,两天十几万开发者排队内测
CHAPTER 45 · 前沿篇
2026 年 9 月 15 日,硅谷的开发者圈子里突然开始传一个名字:Jev。
这个模型有个特别反常的地方——它一个字都写不出来。不能聊天,不能写邮件,不能写代码,也不能解释它为什么这么想。你问它问题,它不会回你一段话,只会给你一个数字、一个选项,或者一个「是」或「否」。
按常理,这样的东西应该没人要。可事实是:发布当天它长时间挂在 Hacker News 首页;据媒体报道,创始人的发布帖有约 420 万次浏览、近 2 万个赞;发布不到两天,十几万开发者排队申请内测;Vercel、Cloudflare、LangChain 这些主流平台很快接了进去。
一个「哑巴」模型,凭什么?
这件事真正值得关注的,不是又多了一个新模型,而是它戳破了一个我们习以为常的误解——AI 不是非得会说话,才能替你干活。
▲ 一个不会写字的模型,只做判断,却带置信度、毫秒级响应
CHAPTER 01
做这件事的人,恰恰最有资格「反水」
那个创始人叫迪奥戈·阿尔梅达(Diogo Almeida),前 OpenAI 研究员,是 2022 年那篇 InstructGPT 论文的主要作者之一,也是 RLHF(基于人类反馈的强化学习)这项技术的共同发明者。OpenAI 在 GPT-4 的贡献名单里,把他列在「Foundational RLHF and InstructGPT work」一栏。
说人话就是:今天 ChatGPT 之所以能「听懂人话、好好跟你聊天」,这套方法有他一份功劳。
然后他做了件很戏剧性的事。他在自己的社交账号上写:
「After co-inventing ChatGPT, I kept asking myself: why have superhuman chat models not led to AGI?」(共同发明 ChatGPT 之后,我一直在问自己:为什么聊天能力已经超过人类的模型,没有带来通用人工智能?)
他还给自己贴了个标签,大意是「做了 ChatGPT,又黑 ChatGPT」。
他给出的答案不是「模型还不够强」,而是「方向从一开始就偏了」。他的原话是:我们花了四年时间,在「处理人类语言」这件事上做得非常出色,但这套能力对自动化来说并没有用——因为计算机使用的是另一种语言。
于是他在 2024 年离开 OpenAI,创办了 TypeSafe AI,隐身两年,做出了 Jev,同期宣布完成 4000 万美元种子轮融资。
CHAPTER 02
过去四年,我们让 AI 干了一件很别扭的事
要理解 Jev 到底改了什么,先得看清过去几年几乎所有 AI 软件都在走的那条路:
业务状态 → 提示词 → 大模型 → 一段自然语言或 JSON
→ 解析 → 校验 → 程序做决定
过去几年几乎所有 AI 软件都在走的通用路径
这条路径太普遍了,以至于很少有人觉得它奇怪。但仔细想想:如果软件真正想知道的只是「这个客服工单要不要升级」「这次操作风险高不高」「下一步该点哪个按钮」,为什么非得先让模型写一段像人类回答一样的话,再由程序把这段话翻译回一个判断?
有位作者打了个很妙的比方:这有点像你想要一个红绿灯,却先请一位哲学家写一篇关于交通秩序的短文。
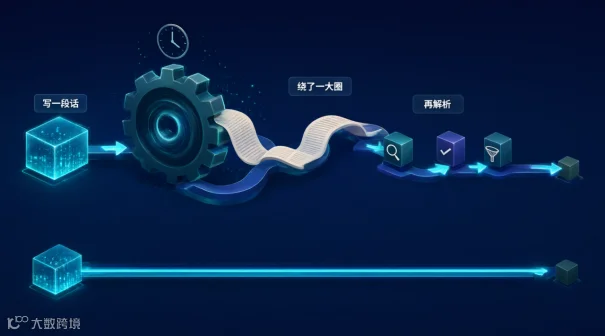
▲ 过去 AI 软件的通用路径——先写一段话,再解析回判断,绕了一大圈
一个具体的例子
假设客服系统收到一条投诉记录,需要判断三件事:这个用户会不会流失、要不要转人工、要不要退款。
传统大模型的做法
它会先写一段话——「这名用户有较高流失风险,建议转人工处理,并考虑退款。」然后程序还得从这句话里,把「高风险」「转人工」「退款」这几个真正有用的信息再抠出来。
Jev 的做法
你提前告诉它,我只要三个答案。它读完同样的记录,直接返回「流失风险 82%」「转人工 91%」「退款 37%」。程序拿到就能用,不用再解析一段话。
差别有多大?在发票欺诈检测这个场景里,有报道提到:传统大模型需要 8 秒以上才能得出结论,而 Jev 只要 0.1 秒。这不是「快一点」,这是「快两个数量级」。
CHAPTER 03
Jev 改了什么:从「写一段话」到「给一个判断」
用一句大白话概括 Jev 的接口:你给它一段乱七八糟的原始信息,它给你一个提前规定好格式的判断,外加一个「我有多确定」的分数。
它只做三件事:
01 选择:从你预设的选项里挑一个,最多 255 个选项;
02 打分:在你规定的范围内给一个分数;
03 判断真假:针对一个是非问题,给一个「是」的概率。
有个解释特别到位:你不能让它写一段话,但你可以问它「这段文字里有没有出现某个问题」,它会回答有或者没有,同时告诉你它有多确定。
为什么能快这么多
因为大模型是「一个字一个字往外蹦」的——前一个字出来了,才能算下一个字,所以再快也得排队。Jev 换了个思路:所有答案一次并行算完。这跟当年 Transformer 取代 RNN 是同一个逻辑:用并行取代串行。
真正的门道,在训练方法里
比「快」和「便宜」更值得琢磨的,是它背后那套训练方法。阿尔梅达把方法叫做 RLCD,中文可以理解为「面向校准决策的强化学习」。要理解它,得先看这几年 AI 训练的路线演变:
第三条才是关键。如果模型说「我有 90% 的把握」,那统计上就该有大约 90% 是对的。这个性质听起来很学术,但它决定了 AI 能不能真的被塞进自动化流程里。
因为有了可信的概率,程序就能分级处理:
· 置信度高于 0.90 → 自动执行,不用人管;
· 在 0.7 到 0.90 之间 → 交给更强的大模型复核;
· 低于 0.7 → 交给人来决策。
这才是 Jev 最有价值的地方:它不只是快,它开始「知道自己有多不确定」。
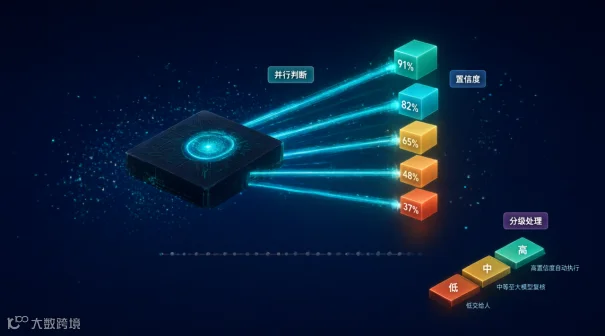
▲ 所有答案一次并行算完,每个判断都带一个置信度,按高低分级处理
CHAPTER 04
它现在真能干什么:几个跑起来的场景
Jev 的定位不是「替代 ChatGPT」,而是补上大模型不擅长的那一环:高频、微小、有后果、需要毫秒级响应的判断。
场景一 · 过滤不想看的内容
一位开发者用 Jev 做了个浏览器插件,专门过滤社交媒体上那些引战骗回复、加密货币推销、政治争吵的内容。每刷出一条新帖子,Jev 就在后台判断一次,命中就折叠掉,平均只要 380 毫秒。
场景二 · 给命令做安全审查
Vercel 的一位工程师说,他们原先用 OpenAI 的模型跑「命令安全审查分类器」,换成 Jev 之后,速度提升了 5 到 18 倍,准确率还更高。
场景三 · 给商业邮件分类
另一家公司的技术负责人把 Jev 和 Gemini 做了对比:Gemini 准确率略高一点,但成本高出 10 到 20 倍。他更看重的是 Jev 返回的「真实概率值」——有了这个概率,程序才知道哪些邮件可以自动处理、哪些必须人工看。
场景四 · 给大模型当检查员
Jev 不一定要替代大模型,它可以站在大模型旁边,实时检查大模型的行为:这一步做得对不对、有没有被诱导、该不该换个模型来处理。因为够快够便宜,它可以对每一次大模型调用都做一遍检查。
还有些更「玩」的用法:有人让 Jev 实时操控经典游戏《毁灭战士》,每秒决策 10 次,每小时成本约 7 美元;有人拿它搭交易机器人。
这些场景的共同点是:它们都不需要 AI 写出一段漂亮的话,只需要它给出一个能直接执行的判断。
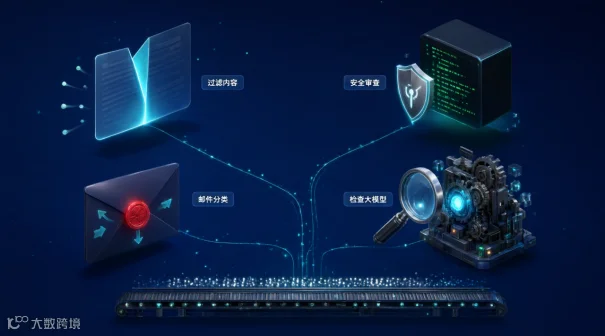
▲ 四种已经跑起来的高频小判断场景,汇聚到一条高速流水线上
CHAPTER 05
那个「7 秒订票」的演示,到底怎么做到的
上面这些例子里,最让人摸不着头脑的大概是这一个:有人让 AI 自己打开订票网站,点单程、填出发地、填目的地、选日期、点搜索,全程 7 秒跑完。
很多人第一反应是:Jev 是不是被训练成了一个特别会「上网」的 AI?
不是。而且答案比想象中朴素得多。
第一,网页操作本来就不需要「深度思考」
一个 AI 在网页上要做的,翻来覆去就那么几件事:点、滚、输入、等、停。然后再从一堆按钮和输入框里,挑出「下一步该点哪一个」。这两件事——选什么动作、选哪个目标——本质上就是两道选择题。
第二,页面早就被「翻译」成了一份清单
这是整个演示里最关键、也最容易被忽略的一步。在 Jev 出手之前,程序已经先把网页读了一遍——不是截图,而是直接读网页的底层结构(HTML)和无障碍信息,把页面上所有能点的、能填的东西整理成一张带编号的清单:第 1 项是单程按钮,第 2 项是出发地输入框,第 3 项是搜索按钮……
于是 Jev 收到的不是一张图片,而是一道干净的选择题:「当前有这些可操作项,下一步该做哪个动作、作用于哪一项?」它只需要回答「点,第 3 项」,再附上一个把握有多大。
第三,Jev 只负责「点哪里」,不负责「写什么」
如果这一步需要往输入框里打字(比如「苏黎世」),那是另一个专门负责写字的模型干的活。所以准确的说法是:Jev 不是那个「看懂屏幕的大脑」,它是那个「决定下一步做什么」的反射神经。它自己甚至看不了图片——目前它只接受文字和结构化的数据。
这也解释了它为什么能快成那样。传统做法是:截一张全屏大图 → 传给能看图的模型 → 模型盯着图片想几秒 → 慢吞吞写出一段「我认为应该点击……」 → 再从中抠出一个坐标 → 浏览器点一下 → 再截图……一轮下来几十秒就过去了。换成「读清单 + 做选择题」之后,中间那些「写」和「读」的环节全被砍掉了。
有一点要说明:那 7 秒并不是「从打开浏览器到出结果」的全部时间。按演示方的口径,计时是从页面已经加载完成之后开始的,不包含打开网站的时间,但包含了模型调用、填字、点击和等待页面加载。
这个案例真正的启发,不是「AI 会自己上网了」,而是「一件事可以拆给不同的模型干」。看懂屏幕的、负责规划的、负责写字的、负责快速做小决定的,各干各的。
CHAPTER 06
如果把它接进 WorkMate,能用在哪儿
说到这儿,可能有人会问:这些例子都是开发者写的代码,我不写代码,跟我有什么关系?
关系其实很直接。Jev 这类模型真正改变的不是「谁能用 AI」,而是「AI 做一次判断要花多少钱」。当一次判断便宜到接近免费,能被塞进自动化的判断就会多到爆炸——你日常工作里那些「每天都要判断几十次、但每次都不值得专门找人」的小事,第一次有了被接手的可能。
先说清楚一件事
WorkMate 目前并没有接入 Jev。下面不是「我们已经做到了」,而是站在「如果接进去」的角度,看看它可能在哪些地方起作用。
要判断能用在哪儿,得先抓住 Jev 的两个特点:
01 它只做判断,不做生成。它不会写邮件、不会写报告、不会跟你聊天。它只会回答「是或否」「选哪个」「打几分」,并告诉你它有多确定。
02 它便宜到可以「随手用」。便宜的意义不是省钱,而是以前不值得用 AI 做的事,现在值得了。
顺着这两点往下想,能接的地方其实很清楚。
第一处 · 该不该打扰人
WorkMate 里有一个设计,和 Jev 的思路几乎是同一个方向:遇到删除、外发、付款这类有后果的动作,AI 不会自己拍板,而是停下来弹一张卡片等人确认。这个设计解决了一个大问题,但也带来一个新问题:如果每件事都要问人,人就成了瓶颈。Jev 这类模型能补上的,正是「哪些该问、哪些不用问」这一层:先让它快速判断一下风险高低、紧急程度、是否属于常见情况,高风险的照旧弹卡片,低风险的直接放行。它不是来替代人工确认的,是来帮人工确认「减负」的。
第二处 · 定时任务要不要干活
WorkMate 的定时任务可以让 AI 在固定时间自动跑一件事。但「到点就跑」有个天然的粗糙:今天没有新数据、这周没什么变化,它照样跑一遍,跑完你也不想看。如果前面加一道 Jev 式的判断——「今天有没有值得处理的新情况?」——没有就跳过,有才真正启动。省下的不只是钱,还有你被无用结果打扰的次数。
第三处 · 数字员工的前置分流
WorkMate 里的数字员工是可以被派活的 AI 同事。但派活之前,往往得先想清楚「这件事该给谁」。如果先让一个便宜的判断模型看一眼任务内容,判断它属于法务、财务还是业务,再决定派给哪个数字员工,派活这件事就从「每次都要人想」变成「大部分时候自动分流」。
第四处 · 翻资料:先筛后读
WorkMate 有知识库,可以让 AI 基于公司资料回答。但资料一多,「把相关文件都读一遍再回答」这件事就很贵。Jev 式的用法是反过来:先把问题拆成几个明确的是非题——「这份资料里有没有提到交付周期?」「有没有提到违约条款?」——用极低的成本快速筛一遍,只把命中的那几份交给会写字的模型去细读。先筛后读,而不是先读后筛。
这四处有一个共同点:它们都不是「让 AI 变得更聪明」,而是把原本因为太贵、太慢而放弃的判断,重新捡回来。
所以如果真要说 Jev 对 WorkMate 这类平台意味着什么,答案不是「多了一个模型可以选」,而是——过去那些「想想还是算了吧」的自动化场景,现在可以重新拿出来算一算了。
CHAPTER 07
别急着封神:它还没证明的事
写到这里,得给这股热度泼一点冷水。Jev 确实有意思,但有几件事必须说清楚。
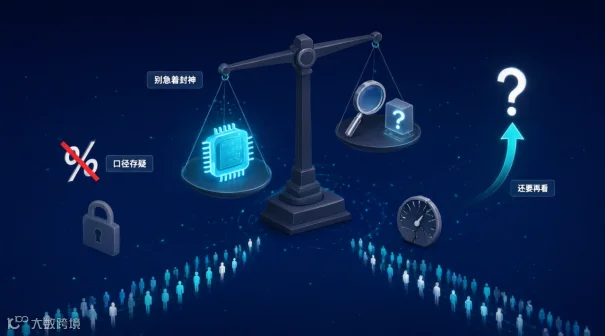
▲ 厂商宣传的数字与第三方核验之间的天平,明显倾斜
① 零幻觉 ≠ 判断永不出错
官方说它的类型错误率和幻觉在数学上等于 0,因为输出结构在架构层面就被约束住了。但媒体核验指出:这只能保证它不会输出你预设格式之外的东西。如果选项只有 A、B、C,它保证不会输出 D——但它仍然可能在 A、B、C 里选错。所以「不会幻觉」应该理解为「不会跑出格式」,而不是「判断永远正确」。官方也注明,那个 0% 不是测出来的,是机制保证的。
② 惊人的倍数来自自家评测
「快 193.6 倍、便宜 444.6 倍」出自 TypeSafe 自己设计的工作流评测,4 个工作流由自家团队制作,评测没有用现实世界的标准答案,而是把另外两个前沿模型的预测概率取平均当作参考答案。官方自己也承认,这些数字代表实际性能的上限,而且对照组模型还得额外经过一层封装才能输出完整概率,会拖慢它。这不是造假,但也不是中立第三方测试。
③ 架构没有公开
官方只说了「新模型架构」、并行采样器和新的训练方法,没有公开参数规模、网络结构、预训练方式和训练数据。有外部观察者推测,它可能构建在某个开放权重的大模型之上。
④ 概率校准还没被外部验证
RLCD 这个方向本身很有价值,但公开材料里还看不到足够完整的校准指标,也没有系统展示「当输入的数据分布发生变化之后,它的置信度是否仍然可靠」。
⑤ 它不聪明,记性也很差
一位长期跟踪 AI 工具的开发者做了个很直白的比喻:它的聪明程度大约相当于一个 switch 语句——适合分类,不适合思考。他还实测过:让 Jev 下跳棋,它快到几乎瞬间落子,但他「几乎没怎么专心就把这个模型打爆了」。更关键的是它的上下文窗口只有 32k——这意味着它看不到太多前因后果,每次判断几乎都是「看一眼当前状态、立刻给答案」。
⑥ 它很容易被用错地方
热度一起来,就有人提议用它来给不同大模型的输出打分、或者用它来压缩 AI 的对话记忆。前者的问题是:它没有能力分辨两个复杂答案的优劣;后者的问题是:压缩记忆本质上是一次「总结」,而它恰恰不擅长总结。一个只做快判断的模型,被拉去干需要思考的活,结果只会是又快又错。
⑦ 它不是从石头里蹦出来的新发明
分类器、重排序模型、奖励模型这些「专用判别模型」早就存在,而且都比大模型便宜得多。有开发者指出,早在生成式 AI 占据所有注意力之前,这类「窄而专」的模型就是主流做法;甚至有人在开源社区用另一种架构做出了思路非常接近的东西。TypeSafe 真正押注的,是一个更进一步的假设:能不能把过去高度专用的判别模型,做成一个通用的基础模型——既能读懂复杂的自然语言和程序状态,又能跨任务做各种判断,还能给出可靠的概率。
那位开发者给了一个特别实用的判断标准,比任何参数表都好用:「你看到全部信息之后,几秒钟能回答这个问题?」如果不到 10 秒——比如「这件衣服是什么颜色」——那 Jev 这类模型大概很适合;如果超过 10 秒,那它多半不合适。
换句话说:需要思考的,它不行;需要分类、排序、快速判断的,它很行。
所以,评价 Jev 最该看的指标,可能不是「快了多少倍」,而是——它能覆盖多少原本必须交给大模型的判断。
CHAPTER 08
结尾:真正的变化,是 AI 不必每次开口了
Jev 火了之后,网上很快出现了两种声音:一种说「大模型要被颠覆了」,另一种说「这不就是个高级 if 语句,炒作」。我觉得两种都说偏了。
Jev 自己明确说了:它不是 Agent,不负责决定整个工作流,也不生成下一步计划。代码依然控制流程,它只接手那些「写死规则很困难、又没必要调用完整推理模型」的模糊判断。它更像一个可以被调用的「语义 if」——传统代码写 if 金额 > 10000,它处理的是 if 这笔交易看起来可疑 > 0.92。
所以真正的变化不是替代,而是分工:大模型继续负责开放式生成、复杂推理和长程规划;Jev 这类模型则被埋进流程深处,每秒完成大量分类、路由、检查和决策。一个 Agent 内部,不需要每一步都调用最贵的前沿大模型。
而这件事对普通人和企业的意义,藏在一个经济学概念里——杰文斯悖论,这也是 Jev 这个名字的由来。
19 世纪,蒸汽机越来越高效,理论上烧同样的煤能干更多活,人类应该少烧煤才对。结果刚好相反:因为用煤越来越划算,越来越多行业开始用煤,整个社会的煤炭消费量反而暴涨了。效率提高、单次消耗下降,总消耗却上升。
TypeSafe 用这个名字,赌的就是「智能也会发生杰文斯悖论」:当一次判断便宜到接近免费,能被自动化的判断就会多到爆炸。
对我们来说,这件事的落点其实很小、也很具体:
SUMMARY
别急着问「我该用哪个模型」,先问「我每天有哪些判断,是重复的、有明确标准的、但又不值得专门找人的」。
因为这一轮真正的变化,不是 AI 变聪明了,而是它开始变得便宜到可以随手用了。
如果这篇文章让你重新审视「哪些判断值得交给 AI」
点赞 · 在看 · 收藏,让更多人看见判断型模型的价值
点赞 · 在看 · 收藏 三连,我们下篇见