近日,DeepSeek-V4.1-Flash 正式发布并开源。奥尼同步启动模型适配与推理优化,在模型发布当天完成生产上线,实现Day0适配。
官方给出的最低显存门槛是 614GB,对标 GB200 级数据中心环境。
奥尼用单台 8 卡服务器、672GB 总显存、无 NVLink 互联,承载了 552B 模型与 1M Token 上下文。
GPU 数量减半,聚合吞吐反而更高,单卡效率提升约 3–4 倍。对正在规划算力预算的团队来说,百万级上下文推理的门槛从买一个集群降到了买一台服务器。
01
跨硬件架构适配:打通底层Kernel
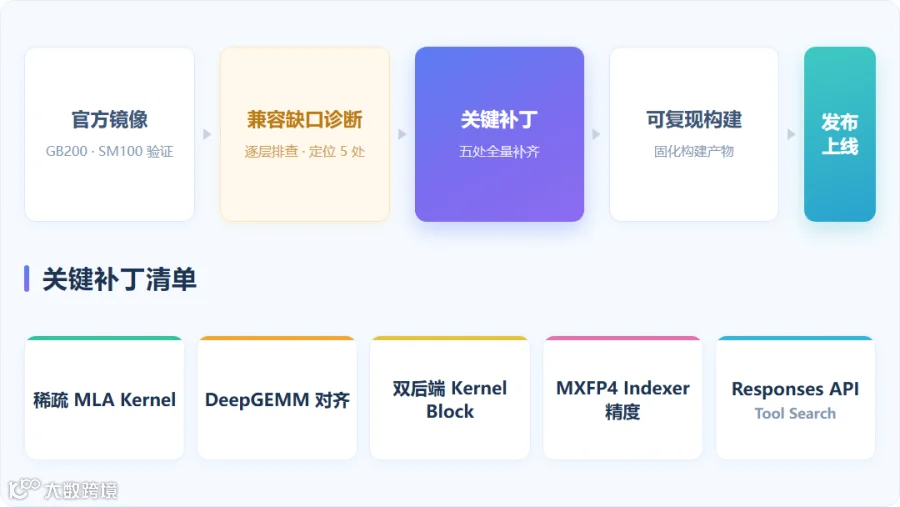
V4.1-Flash的官方镜像验证环境为GB200(SM100),迁移到其他硬件架构后有五处兼容缺口,无法直接使用。
奥尼逐层排查并完成关键补丁,固化为可复现构建,覆盖稀疏 MLA Kernel、DeepGEMM 对齐、双后端 Kernel Block、MXFP4 Indexer 精度与 Responses API Tool Search,从权重下载、镜像固化到服务点亮全部在发布当天完成。
新模型迭代越来越快,拉开差距的不只是算力资源,更是模型、推理框架与底层环境之间的协同适配能力。这一层做不通,再多的卡也只是闲置资产。
02
推理专项优化:释放8卡算力效率
跑通只是第一步,奥尼从解码效率、显存管理、运行开销三个方向做了专项调优:
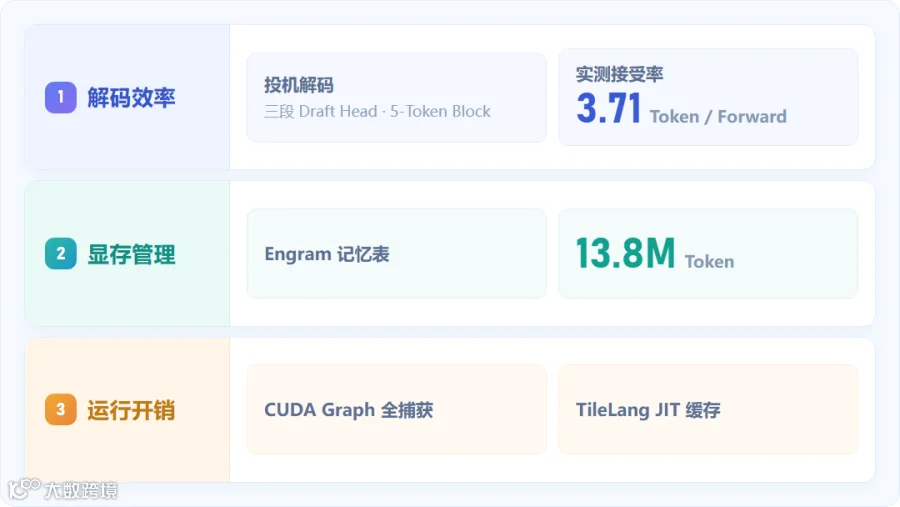
解码效率:让每个 Token 生成得更快。用三段 Draft Head 做 5-Token Block 投机解码,实测接受率 3.71 Token/Forward,高于官方 GB200 参考值(约 2.99),Decode 阶段保持毫秒级 TPOT。
显存管理:为百万上下文腾出空间。把约 189GiB 的 Engram 记忆表自动 Offload 到主机内存,腾出 13.8M Token 的 KV 池,为 1M 上下文与并发请求留出余量。
运行开销:让长请求不再抖动。采用 CUDA Graph 全捕获并结合 TileLang JIT 缓存持久化,长请求不再反复重编译,响应稳定性明显改善。
03
性能实测:单卡效率提升约 3–4 倍
128K 长上下文、Warm 稳态下,与上一代 16 卡 PD 方案同口径对比:
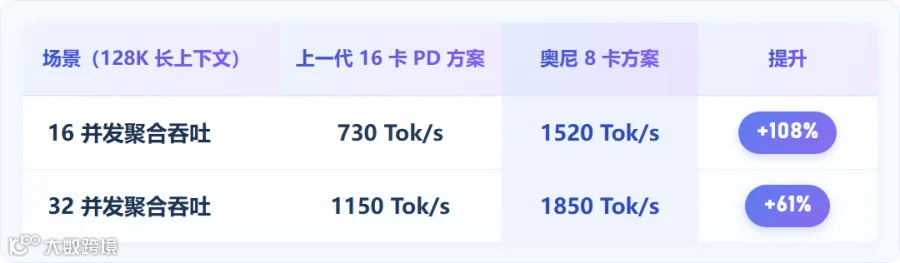
响应也更稳,128K / 32 并发下 TPOT 10.2ms(上一代 14.3ms),TTFT 平均下降 59%、p99 下降 73%;并发从 8 到 32,TPOT 只劣化 2.0 倍,上一代是 2.7 倍。
生产验收全量 20/20 通过,原生多模态能力已随本次适配一并验证通过,服务支持 OpenAI / Anthropic 双协议与 Responses API。
GPU 数量减半,聚合吞吐却提升 61%–108%。
以上数据均在 128K 长上下文口径下取得;本次为单节点 8 卡部署,未做 PD 分离与多节点扩展,13.8M Token 的 KV 池为按 890 B/Token 估算的理论容量。
目前,奥尼已完成 DeepSeek-V4.1-Flash、Kimi K3、GLM 5.3、MiniMax H3 等多款主流模型的适配,并可通过 TokenPond 元池平台为企业提供更便捷的模型接入与调用能力。
面向快速迭代的模型生态,奥尼将持续推进主流模型的适配、推理优化与生产验证,为企业 AI 与 Agent 应用提供稳定高效的推理算力支撑。
栏目推荐
部分信息来源:
奥尼电子
文稿 |蔡展桦
一审 |胡绰妍
终审 |杨逸韵
探索更多
AI门户
视频号
AI营
联系我们