

Qwen 家族开源了全新的图像模型 Qwen-Image-2.1,在生成质量、推理效率与成本之间取得了良好平衡。它将文生图与图像编辑统一到单一模型中,视觉生成组件仅含 70 亿(7B)参数,并原生支持透明图像的生成与编辑。
本次更新带来四大核心改进:
紧凑高效:轻量级架构配合推理优化,兼顾画质与计算成本;
原生透明、创作编辑一体:根据提示词直接生成普通或透明图像,可编辑透明图层,也能从照片中抠取主体;
强大的编辑能力:支持最多 10 张参考图、局部区域编辑、人物与商品保真,覆盖广泛任务;
真实质感与精致美学:排版、人像光影与细节全面提升,画面更具视觉冲击力。
01 / 紧凑而高效
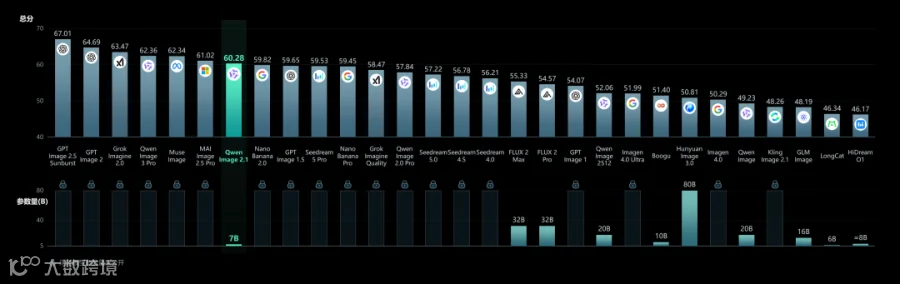
Qwen-Image-2.1 采用轻量级架构,视觉生成组件由 32 层单流 DiT(Single-Stream DiT)和 70 亿参数构成。虽然体积小巧,生成质量却相当出色。下面的 Qwen-Image-Bench 对比展示了它与其他开源及闭源模型的表现。
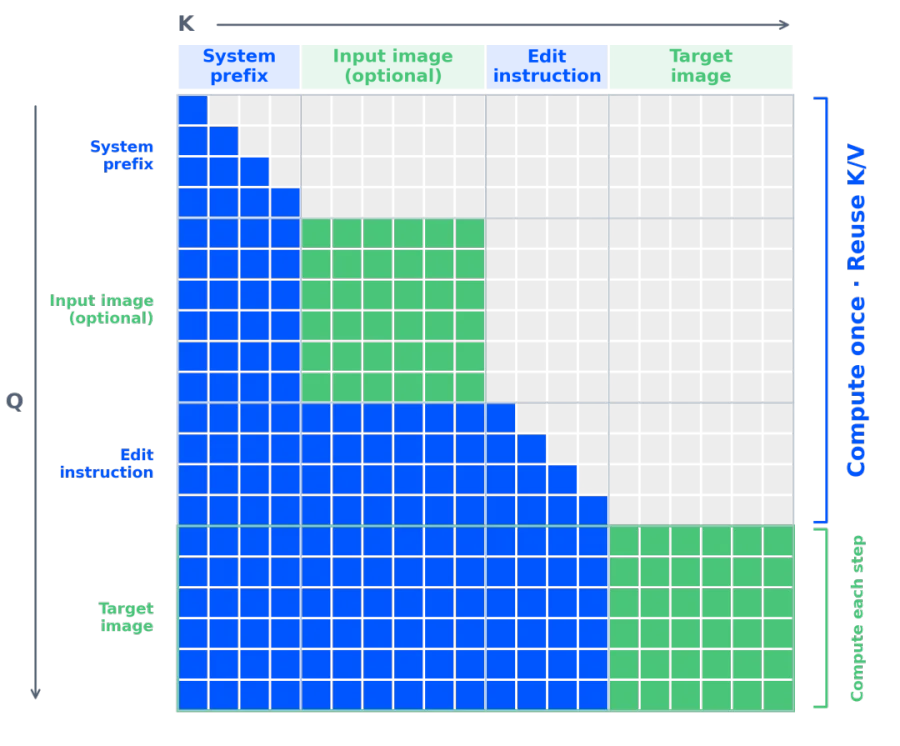
推理效率是另一个重点,尤其是在多图输入的编辑场景。这得益于混合粒度注意力架构:文本(系统前缀与编辑指令)使用 token 级因果掩码,图像生成则使用块级(chunk-level)掩码。同时,KV 缓存复用让输入图像和编辑指令作为静态上下文,在首步一次性计算并缓存,从而加速推理、降低显存占用。
02 / 原生透明:创作与编辑一体
原生透明是本次发布的重要升级。2025 年 12 月发布的 Qwen-Image-Layered 是专门支持透明图像生成的模型,而 Qwen-Image-2.1 将这一能力整合进统一模型——由提示词决定输出普通图像还是带透明通道的图像。
以下是通过文字直接生成的透明图像示例:
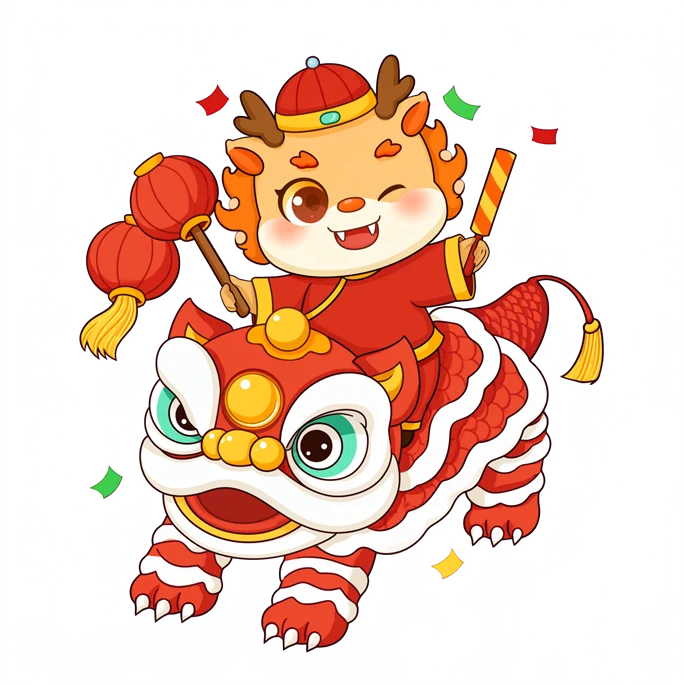
除了单体素材,模型还能生成由多个元素组合而成的复杂透明图像,为设计与素材创作打开更多想象空间。
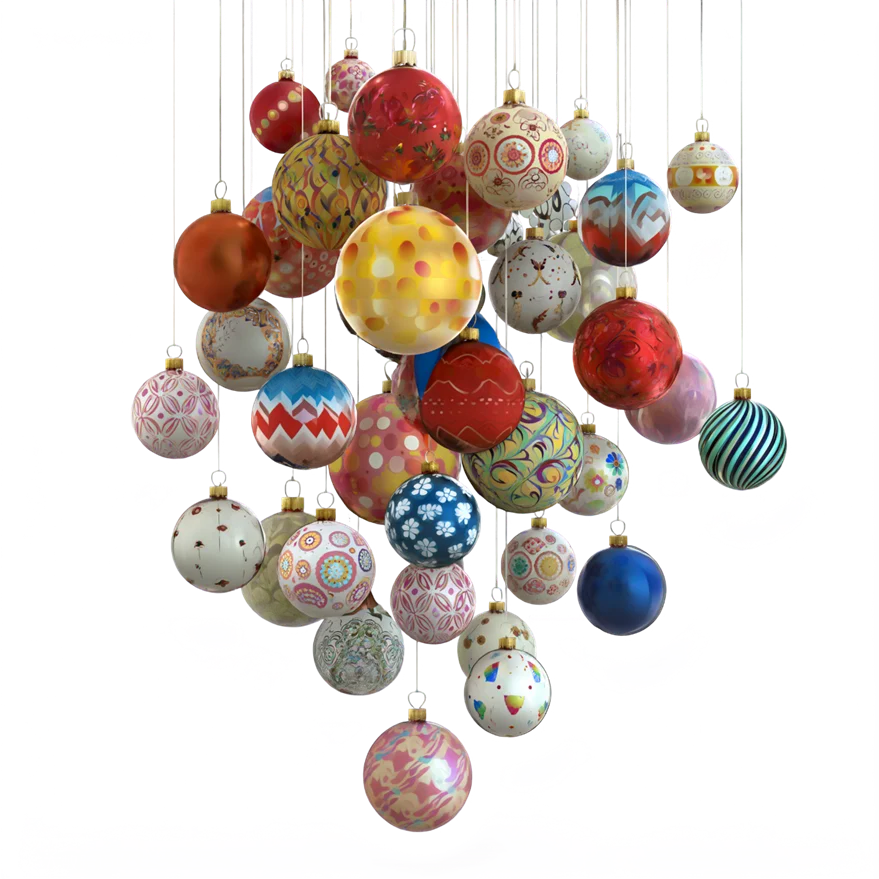
得益于生成与编辑的统一,Qwen-Image-2.1 可以直接编辑透明图像,例如在保留透明背景的前提下改变人物表情(左为输入,右为结果)。
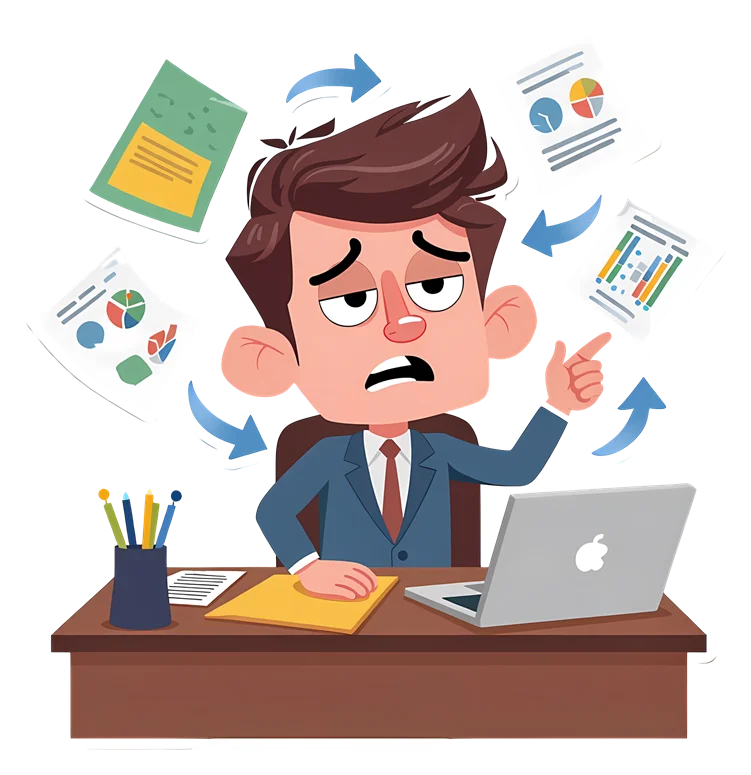
透明图层中的文字同样可编辑。下面的例子将 "BLOOM" 替换为 "Qwen-Image"。
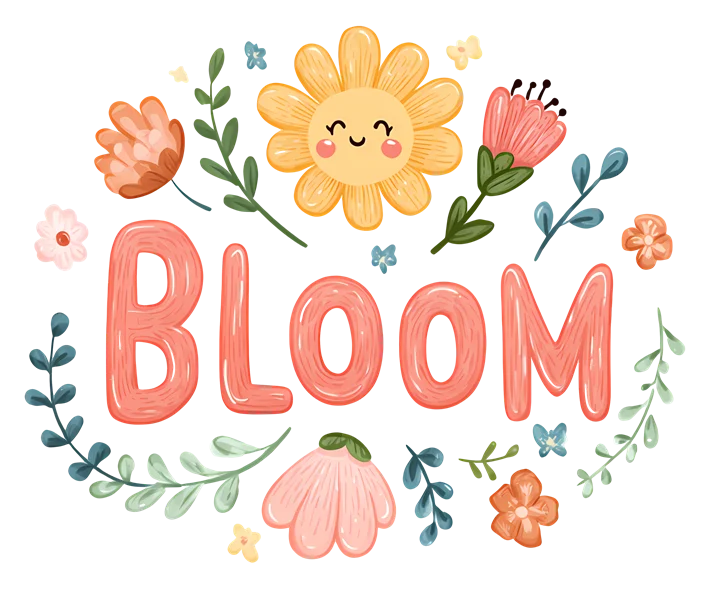
这一能力还延伸到真实照片:给定一张 RGB 图像,模型可以提取目标主体并输出带透明通道的 RGBA 图层,方便后续设计合成时复用素材。
03 / 多才多艺的编辑能力
Qwen-Image-2.1 的编辑能力在四个方面得到提升:多参考图、局部编辑、保真性与任务覆盖面。
多参考图:最多支持 10 张输入图
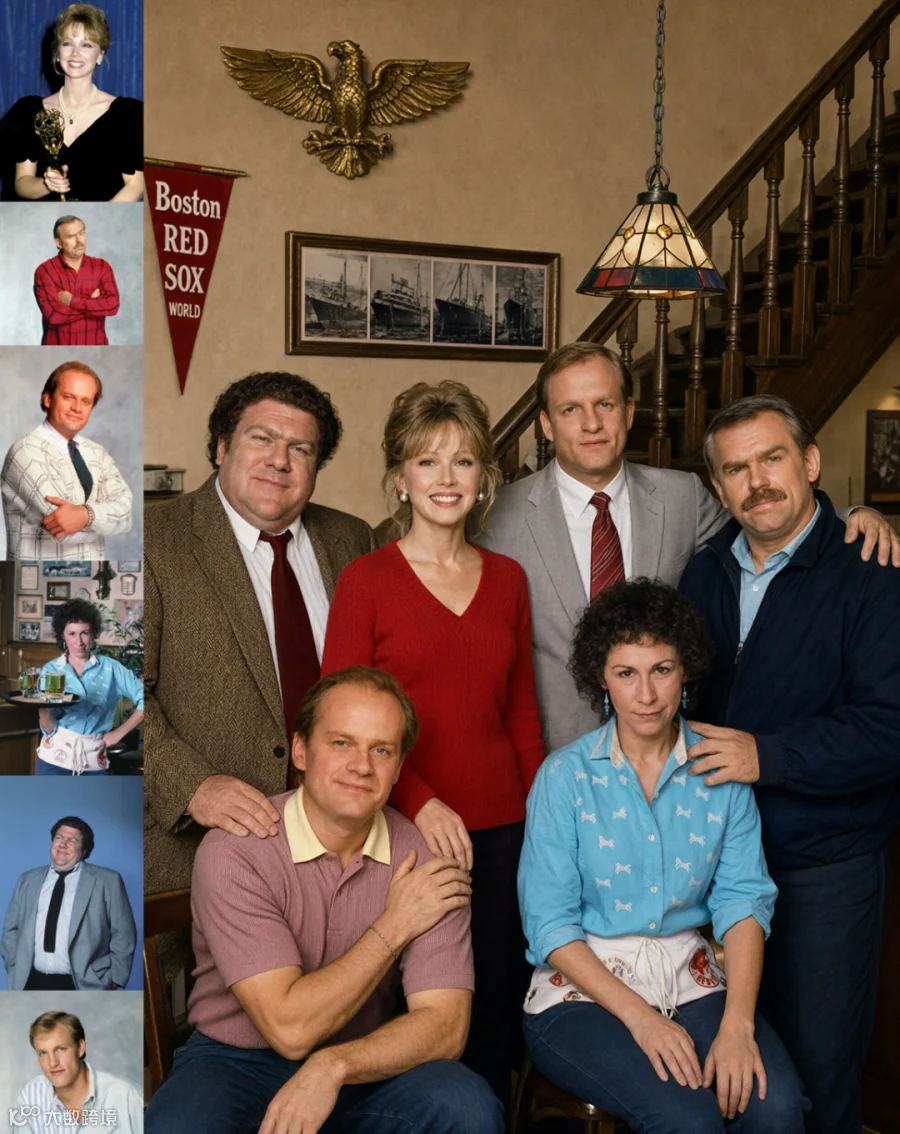
模型支持最多 10 张参考图,可将多个主体与素材融合为连贯的画面。在下面的合影示例中,左侧六张单人肖像被合成到同一张照片中。
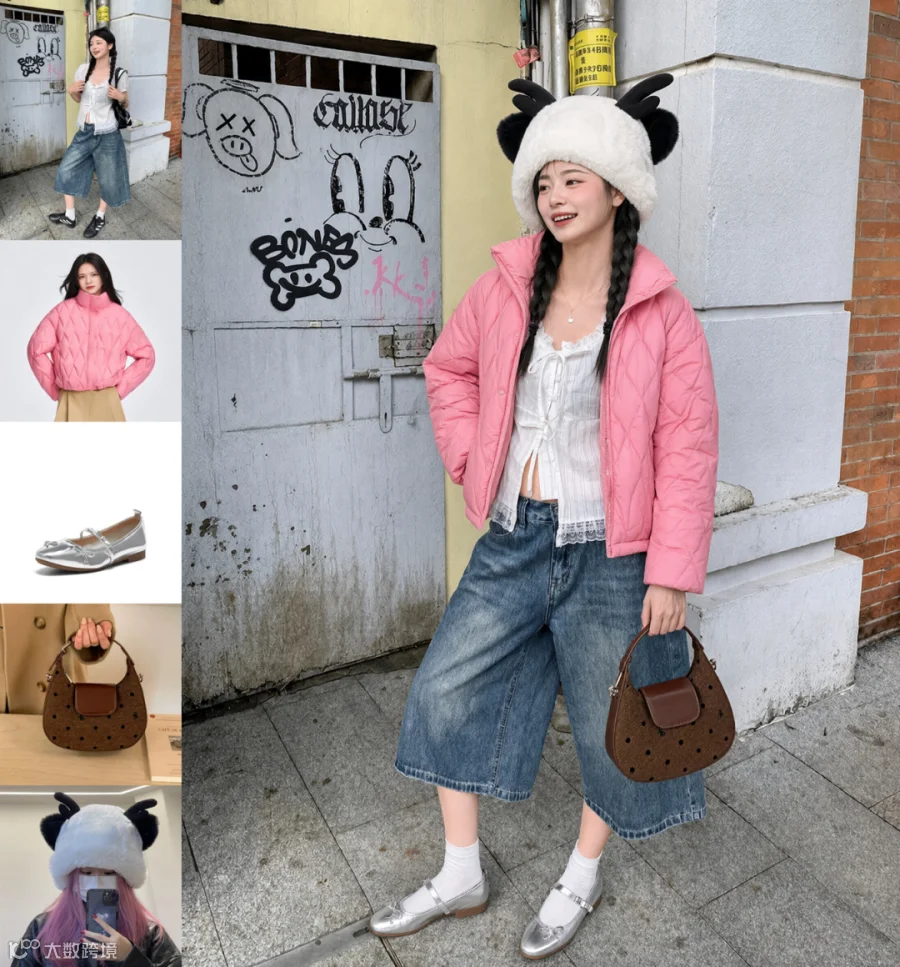
虚拟试穿场景下,模特、服装、鞋子、包包与帽子共五张输入可组合为完整穿搭。
室内设计中,模型可用 10 张家具图生成完整的房间布局。

局部编辑:灵活的区域选择
Qwen-Image-2.1 支持圆圈标注、涂鸦标注和独立掩码三种方式来指定编辑区域。
第一个示例使用不同颜色的圆圈同时标记三个区域:“移除蓝色圆圈中的金属手表,将红色圆圈中的头发改为黑色,将绿色圆圈区域替换为灰色短袖亚麻睡衣。”(左为标注输入,右为结果。)

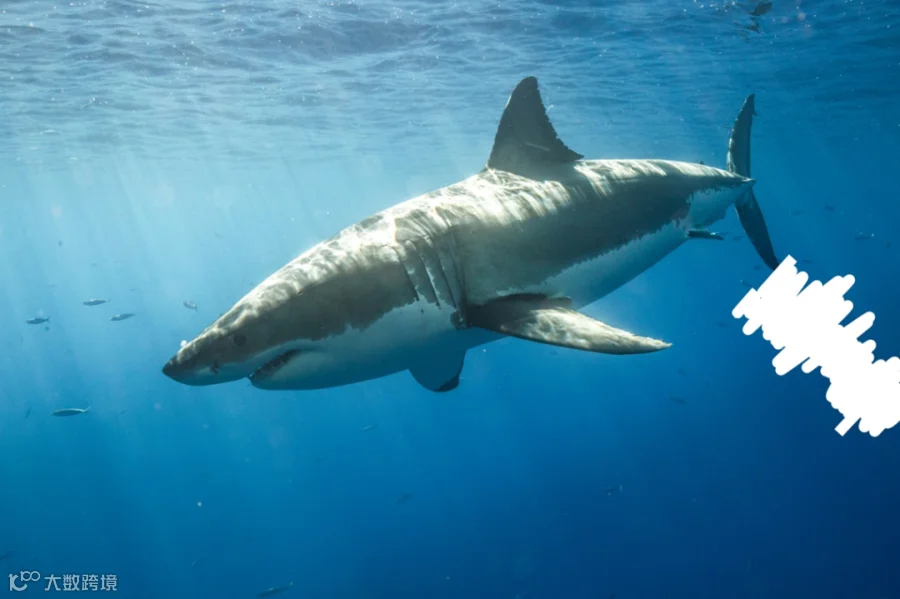
涂鸦标注提供了另一种指定区域的方式。下例中,模型在输入图右侧白色标记区域内添加了一名潜水员。
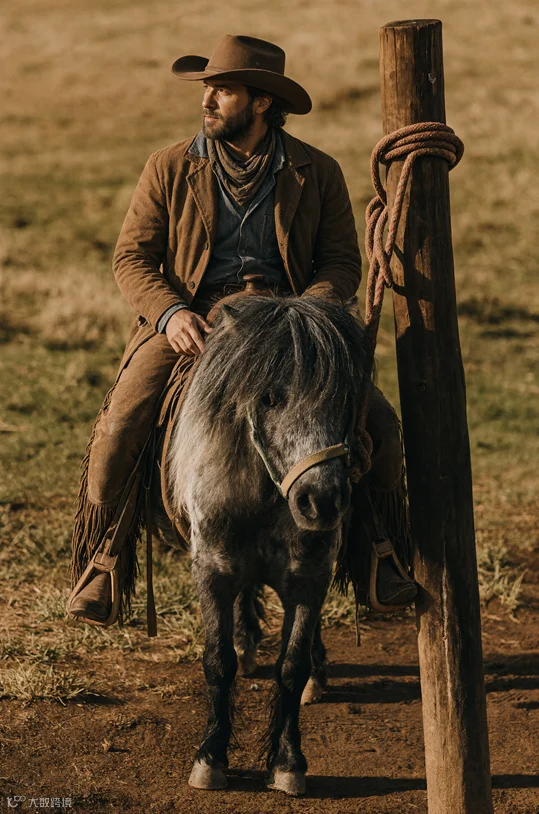
由于圆圈和涂鸦会遮挡原始内容,Qwen-Image-2.1 还支持将原图与独立掩码作为两个输入,完整保留原始画面。下面的示例使用这两张图让模型生成一位骑马的牛仔:
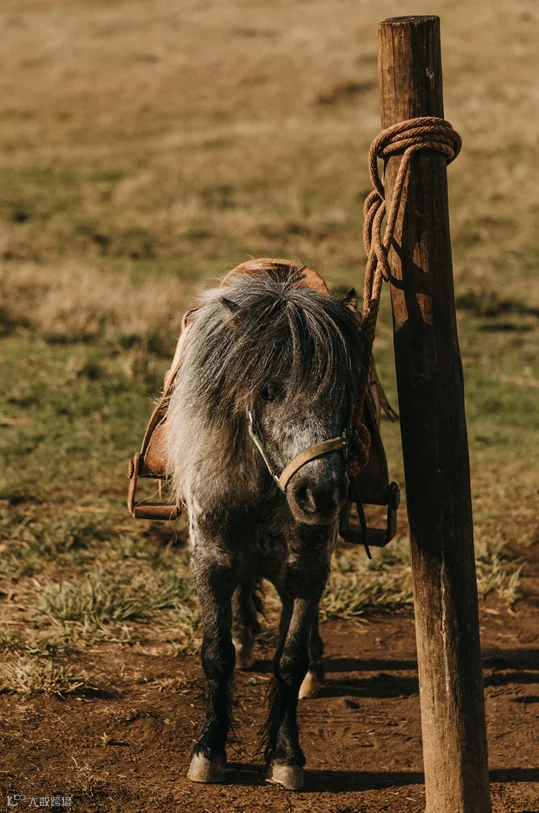
模型只编辑掩码指定的区域,得到如下结果:
局部编辑还支持连续创作。通过在保留画面其余部分的同时逐步修改,编辑结果可以组装成简单的动画,比如博客中展示的水豚“葫芦兄弟”示例。
保真性:人物与商品的稳定还原
保真性提升聚焦于人物身份与商品一致性。人像方面,模型更好地保持面部特征,使人物身份在编辑前后保持一致(每组左为输入,右为结果)。
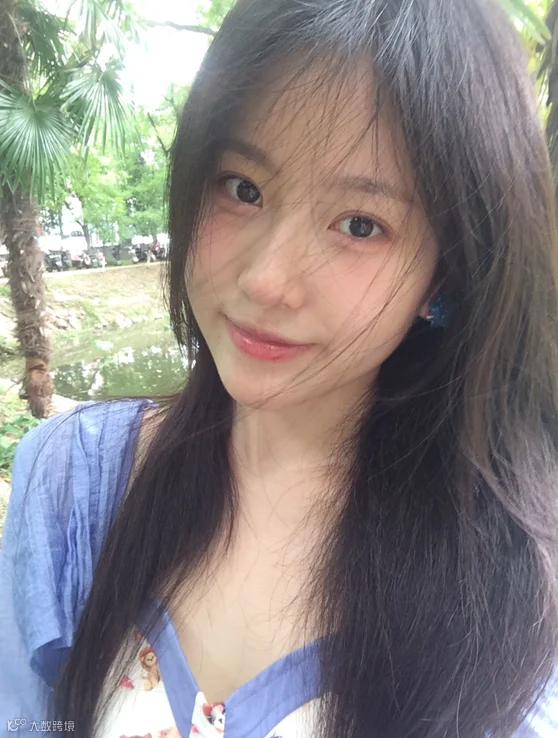
商品编辑方面,模型力求保留文字、纹理与形状,让产品的关键特征在新画面中保持一致。
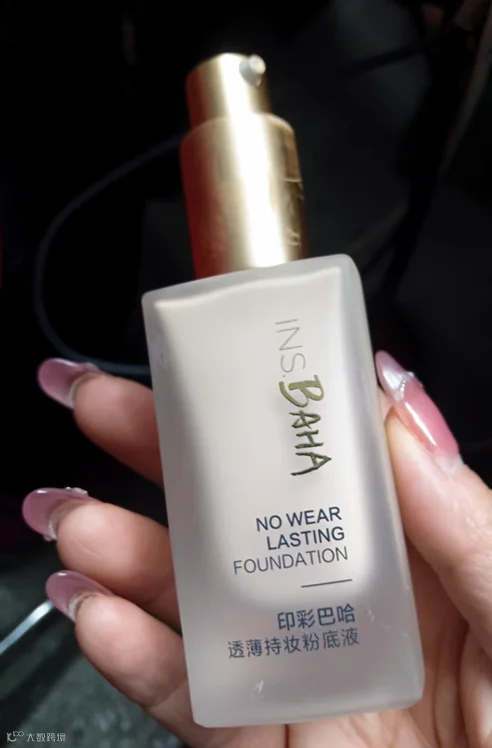
任务覆盖:全景图、信息图与分镜
Qwen-Image-2.1 支持全景图、信息图、分镜等广泛的编辑任务,在不同应用间均衡发力。例如,从一张自拍出发:
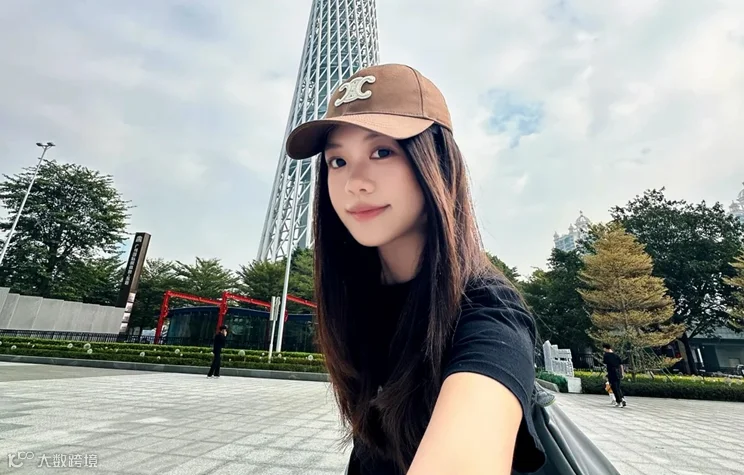
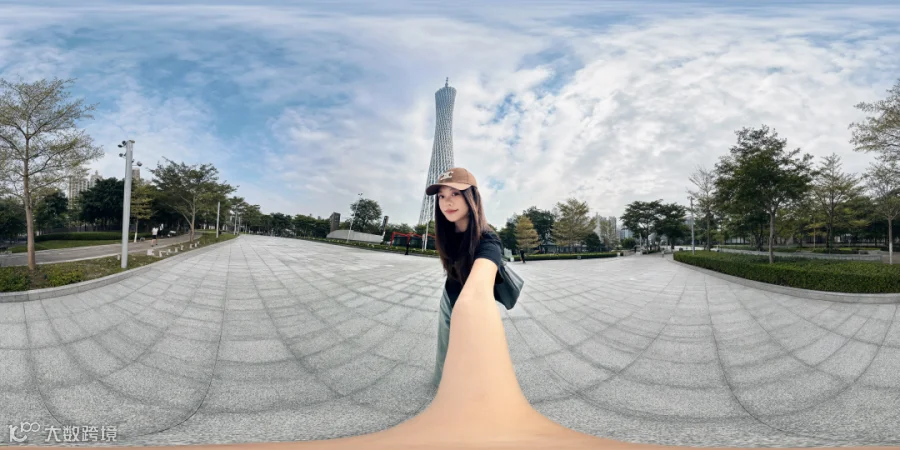
模型可以生成如下全景图,并可在可视化工具中浏览不同视角:
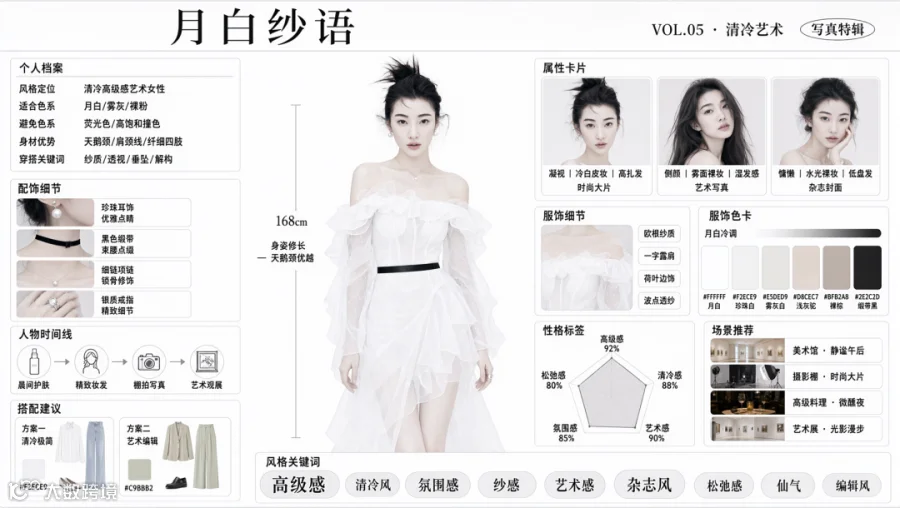
信息图生成方面,一张模特照片可以扩展为细节丰富、信息量充足的构图。
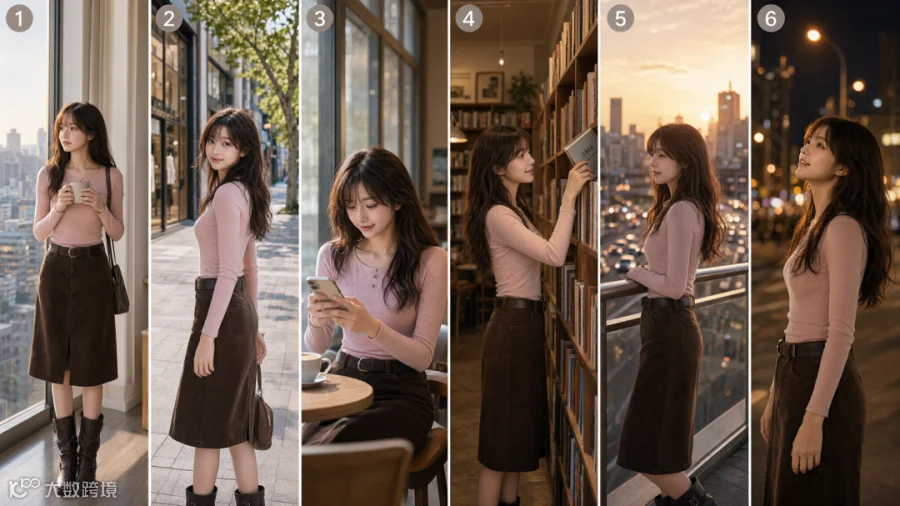
模型还能将三视图角色参考转化为完整分镜,为叙事与视觉创作提供素材。
04 / 真实质感与精致美学
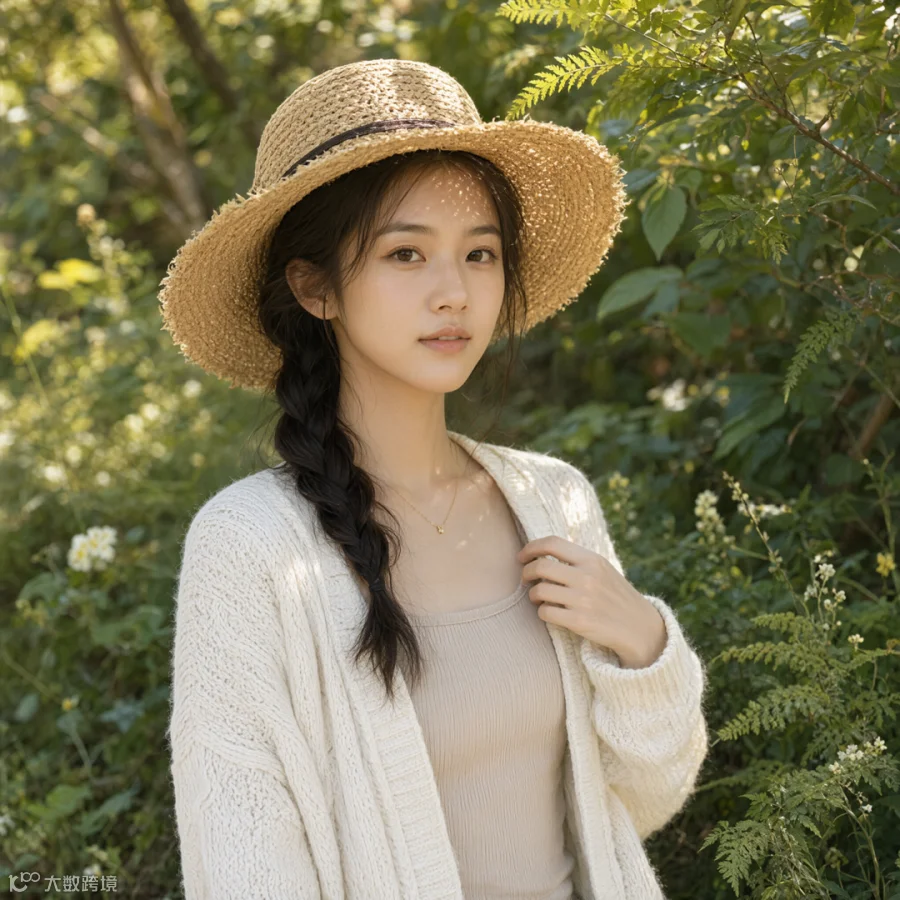
Qwen-Image-2.1 进一步提升了视觉质量,尤其注重文字排版与人像。文字渲染不仅关注内容本身,还考虑字体风格、排版布局以及它们与整体构图的关系。
人像方面,改进的光影处理与细节刻画让生成图像更加逼真。
05 / 结语
凭借仅 7B 参数的视觉生成组件,Qwen-Image-2.1 将图像生成、透明能力与丰富的编辑功能汇聚于一身。更快的推理速度、最多 10 张参考图的支持、灵活的局部编辑,以及对人物与商品的更高保真度,使其成为设计、内容创作、电商与视觉叙事领域的实用工具。
祝大家创作愉快!模型已在 GitHub、Hugging Face 和 ModelScope 开源。