

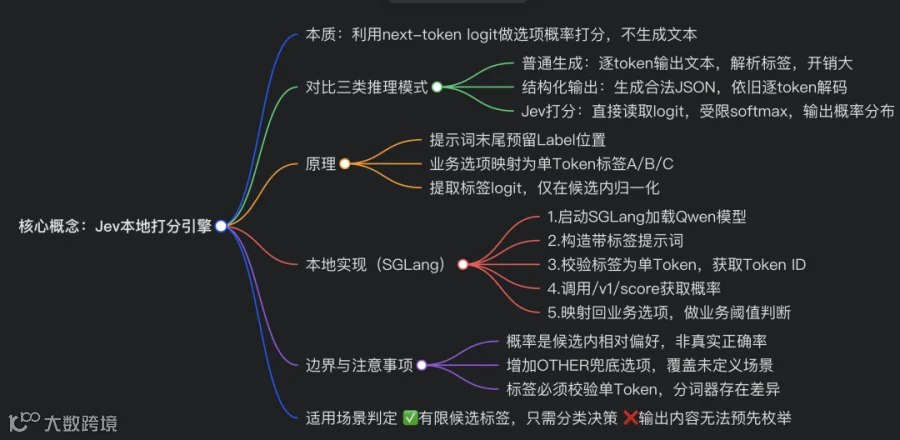
编者摘要:本文介绍如何基于 SGLang 本地复现 Jev 的大模型打分决策能力,无需微调模型。传统 LLM 调用采用自回归逐 Token 生成文本或结构化 JSON,再由应用解析标签,存在多余解码开销;而 Jev 式固定答案打分仅读取提示词后首个位置的 Logit,对预设单 Token 候选标签做受限 Softmax,直接输出各选项概率分布,省去生成循环,延迟更低。
实现时,需将业务选项映射为 A/B/C 这类单 Token 标签,提前校验标签分词结果,调用 SGLang /v1/score接口获取概率,再映射回业务含义。要预留 OTHER 兜底标签,应对选项不全场景。打分得到的概率仅代表候选内相对偏好,不等于真实准确率,需要标注数据做概率校准。
三种推理模式适用场景不同:未知输出内容用普通生成;候选值无法枚举时用结构化输出;候选集合预先确定、仅需分类决策时,优先使用打分。基准测试表明,在工单路由、简历筛选、费用审核等分类任务上,打分推理速度显著优于自回归生成。本文仅复现推理链路,不包含 Jev 原生权重、RLCD 训练与完整评估体系。
10 个关键问题 Q&A
- Jev 是什么?本文复现了 Jev 的哪部分?
Jev 是闭源的 LLM 决策引擎。本文只复现打分推理链路,不包含 Jev 模型权重、RLCD 训练、完整评估和校准系统。 - Jev 打分和结构化输出最大区别?
结构化输出依旧逐 Token 生成 JSON 文本;Jev 打分不生成任何文本,直接读取候选标签的 logit,计算候选集合内概率分布。 - 为什么要用 A/B/C 单 Token 标签,不直接对 “billing” 短语打分?
自然短语大概率由多个 Token 组成,多 Token 序列打分复杂,还会受文本长度干扰;单 Token 标签能统一在同一个输出位置读取 logit。 - 打分得到 0.91 概率,代表模型 91% 情况下判断正确吗?
不是。该数值仅代表在给定候选集合内的相对偏好,模型真实准确率需要标注数据集评估与概率校准。 - SGLang 的 /v1/score 接口做了什么?
接收 prompt 与指定 label_token_ids,前向推理后提取对应 Token 的 logit,支持受限 Softmax,直接返回各标签概率。 - 什么时候要增加 OTHER/ESCALATE 兜底标签?
候选列表无法覆盖全部真实情况时。否则遇到不在候选内的输入,模型仍强行在给定选项分配概率,造成错误决策。 - 打分方案相比普通 LLM 生成的优势?
跳过自回归循环,推理延迟更低;一次性返回完整概率分布,业务可基于置信度阈值做自动处理或人工复核。 - 哪些场景不适合 Jev 式打分?
输出内容无法提前枚举的场景,比如写邮件、生成解释文本、开放式问答,这类场景仍需要文本生成。 - 为什么必须校验标签是单个 Token?
打分机制读取的是同一个下一个位置的词表 logit;如果标签分词为多个 token,无法在同一位置读取分值,打分逻辑失效。 - 三种推理模式怎么快速选型?
输出未知内容→普通生成;候选无法枚举但需要规范格式→结构化输出;候选集合固定,仅需分类决策→Jev 打分。 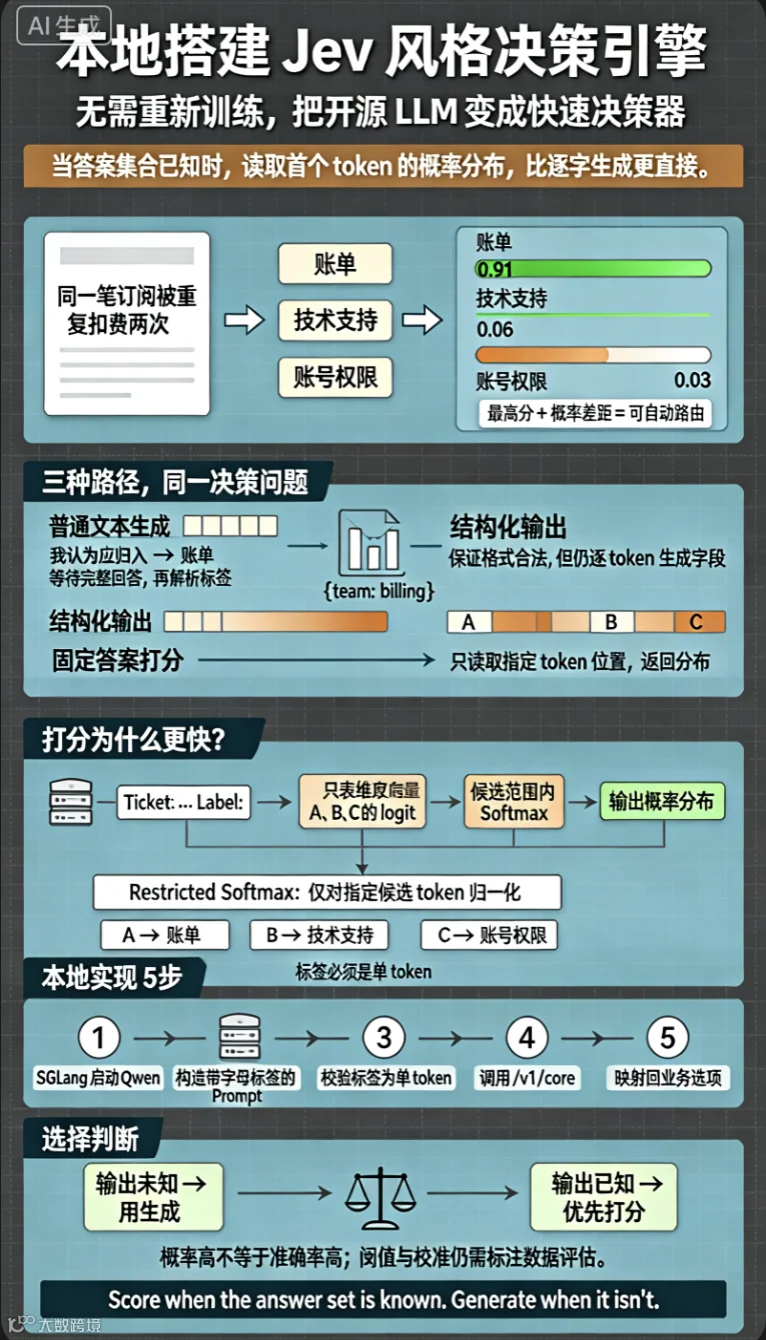
附录 搭建你自己的风格Jev(完全本地部署)
本文将介绍如何把开源大语言模型改造成一套高速本地决策引擎,无需对模型做微调。内容涵盖下一个 token 打分、带概率分布的固定选项判定、SGLang 框架,以及在同一模型上,将该方案与传统文本生成做实操基准测试。
很多大模型调用场景,根本不需要生成全新文本。应用侧已经预知所有可能的答案,只需要模型从中选出一项即可。
举个例子:一条客服工单写着:“同一笔订阅被重复扣费两次。”应用需要把这条工单路由到三个团队中的一个:账单团队、技术支持团队、账号权限团队。
常规大模型调用,是让模型生成一段回答。返回内容可能是一句话、一个标签,或是一段 JSON。应用需要等待文本生成完毕,再解析文本,提取出目标团队。
如果所有合法答案本身都是已知选项,这套流程其实完全多余。 实际上,有一种更高效的实现方式:把这个请求当成一次决策任务,这正是 Jev 的核心思路。应用把工单 / 查询语句和 3 个可选答案传给 Jev,模型一次性输出每个选项的打分(下文会详细说明实现原理):
账单团队 0.91技术支持 0.06账号权限 0.03
本例中账单团队概率最高,应用代码还能直观看到模型对该选项的偏好强度。
这就是 Jev 具备的能力,本文会教你在本地复现这套机制。 我们只需要输入查询文本 + 候选答案列表,一次打分请求,模型就能输出决策结果与概率分布,全程不需要生成句子或 JSON 对象。
虽然 Jev 本身是闭源项目,但这套推理范式在多款开源大模型上都可以实现。 具体来说,我们会基于 SGLang(调用/v1/score接口)完成实现,使用通义千问(Qwen)和 DeepSeek 模型进行测试,并和结构化输出、普通文本生成做对比。
先说明预期:本文复现的是推理链路,不是完整的 Jev 系统。Jev 还包含打分接口不具备的模型训练与概率校准环节。
固定答案打分 ≠ 结构化输出
很容易把 Jev 的机制和结构化输出混淆:两者都限制模型返回内容,但在推理服务内部,二者的工作逻辑完全不同。
还是上面这条客服工单的例子,结构化输出可能返回如下 JSON:
{"team": "billing"}
指定的 JSON schema 只会保证返回合法对象,但并不会让模型直接完成分类选择。 底层上,模型依旧是逐个 token 生成:先输出左大括号、字段名、字段值、右大括号。生成结束后,应用再读取 team 字段。配套视频演示了这个过程。
而 Jev 所用的打分方案:应用直接提供 3 个团队作为全部合法结果集合。服务端读取每个结果对应的模型打分,直接返回上文所示的概率分布,不会生成 JSON。
我们可以一次性返回全部三个选项的分值,而不是只输出 “账单团队”,这样应用代码就能区分两种完全不同的场景:
结果1        结果2
账单  0.91   账单  0.46
技术  0.06   技术  0.44
账号  0.03   账号  0.10
上面两种情况,最高选项都是账单团队。 但第一种偏好非常明确,第二种两个选项分值几乎持平。应用可以设置策略:第一种工单自动流转,第二种交由人工复核。
分值仅由模型给出,下游业务规则由应用代码定义。 举例:可以要求最高分选项概率大于 0.8,并且比第二名高出至少 0.2。这类阈值写在业务代码里,方便测试和调整。
注意:0.91 代表,在这 3 个候选选项内,账单团队占据 91% 的概率权重。这不代表模型判断的正确率就是 91%。想要衡量真实准确率,需要带标注的数据集,也就是后文会提到的概率校准问题。
简单总结:结构化输出是生成一段合法结构化文本;固定答案打分,是针对应用预先已知的候选集合,输出概率分布。
大模型如何生成首个输出 Token
在讲解如何把因果大模型改造成 Jev 风格决策引擎前,我们先理解大模型常规的生成步骤。
-
分词器把提示词转为 Token ID。 -
模型处理这个序列,为下一个位置输出一个向量。 这个向量里,对应词表中每一个 token 都有一个数值。例如 Qwen 的词表有数万个 token,向量就包含数万个数字。 这些原始数值叫做Logits(对数几率)。Logits 越大,代表模型越倾向把这个 token 作为后续输出。此时数值还不是概率。
常规生成流程:服务端基于解码参数(温度等)处理这个向量,选中一个 token,追加到提示词末尾。 模型再为下一个位置生成新的词表维度向量。生成 / 解码循环不断重复,直到遇到停止符或者达到输出长度上限。
但做限定范围的决策任务时,我们只关心第一个向量即可。
回到客服工单路由例子,应用限定 3 个答案:
账单团队、技术支持、账号权限
我们在提示词里给每个答案分配简短标签:
A = 账单团队 B = 技术支持 C = 账号权限
提示词末尾要求只返回其中一个标签:
将这条客服工单归入唯一分类。 工单:同一笔订阅被重复扣费两次。 可选标签: A = 账单团队 B = 技术支持 C = 账号权限 仅返回标签。 Label:
Label:是提示词的最后文本。 模型接下来要输出的位置,正常情况下就是 A、B、C 三者之一。
处理完这段提示词后,模型照常生成该位置对应的词表维度向量。向量内包含 token A、B、C 的 logit,以及词表里其他所有 token 的 logit。
打分链路只需要执行 4 步:
-
获取 A、B、C 对应的 Token ID; -
取出词表向量中这三个位置的 logit 值; -
忽略其余所有 logit; -
仅针对选中的这三个数值做 Softmax 归一化。
举例:取出的 logit 为 8.2、5.5、4.8,在三者范围内做受限 Softmax,得到约 0.91、0.06、0.03。再映射回账单、技术支持、账号权限。
⚠️ 归一化仅限定在我们声明的候选选项内。不是问 A 在整个词表里有 91% 的概率; 而是:在应用排除了所有其他回答之后,模型在 A/B/C 三个选项之间的偏好分配。
这套操作 SGLang 已经在/v1/score接口原生实现。 它把提示词送入模型,读取指定 token 位置的分值,直接返回打分结果。我们不用修改 Qwen 模型代码,手动提取最终张量。
顺带一提:为什么要用 A/B/C 标签,而不是直接对 “账单团队”“技术支持”“账号权限” 这几个短语打分? 因为一段可见文字不一定是单个 token。 例如:
-
“billing” 在某个分词器里是 1 个 token,在另一个分词器里可能拆成多个; -
“technical support” 几乎一定会占用多个 token。
如果直接比较短语,就需要序列打分:先给第一个 token 打分,追加 token,再给下一个打分,合并整条短语的分值,文本长度也会干扰对比结果。
而单 Token 标签可以规避这个问题:每个选项只用词表里同一个位置的单个条目代表,同时提示词里依旧保留完整语义描述:
A = 账单相关问题与扣费异常
B = 产品故障与技术问题
C = 登录、密码及账号访问问题
模型在读取提示词时能看懂描述。标签只作为我们后续读取 logit 的目标 token。
但我们必须验证每个标签确实是单个 token。 例如分词器常会把开头空格并入 token。字符串"A"和" A"对应的 Token ID 完全不同。
聊天模板也可能在答案位置前自动插入空白或控制 token。 规避方法:使用模型原生聊天模板渲染完整提示词,确定答案位置预期接续的文本;调用/tokenize接口校验。如果标签分词后不是 1 个 token,直接舍弃该标签。
这套标签映射逻辑放在打分客户端内部。应用层传入的是业务语义选项(billing、technical_support),永远不需要传入 Token ID,也不会收到 A/B/C。这就是上层 API 可以和模型底层标签解耦的含义。
最后:如果候选列表无法覆盖全部情况,需要预留兜底选项。 举个例子:安全事件工单进入只包含账单、技术、账号三类的路由器,受限 Softmax 依旧会把全部概率分配给这三个错误选项。 解决办法:增加OTHER或ESCALATE兜底标签,应对所有选项都不匹配的场景。
使用 SGLang 搭建本地打分接口
本地示例只需要一套推理服务。SGLang 将 Qwen 加载进显存,对外提供原生 HTTP 接口,我们写 Python 脚本直接请求该服务。
完整流程:
-
用 SGLang 启动 Qwen 模型服务 -
编写带字母标签的决策提示词 -
调用接口对标签做分词,校验单 token -
调用 /v1/score一次请求获取打分 -
将返回概率映射回业务选项
步骤 1:SGLang 启动 Qwen 模型
创建 Python 环境,安装依赖包:
python3 -m venv .venv
source .venv/bin/activate
pip install "sglang[all]==0.5.10.post1" "requests==2.34.2"
启动模型服务:
python -m sglang.launch_server \
  --model-path Qwen/Qwen2.5-0.5B-Instruct \
  --host 127.0.0.1 \
  --port 30000
首次启动会从 Hugging Face 下载模型,后续启动复用本地缓存。加载完成后,Qwen 常驻显存,SGLang 在 30000 端口监听。 保持这个 SGLang 进程持续运行,再执行下面的客户端代码。
步骤 2:定义候选选项、构造提示词
新建decide.py,写入代码:
import json
import requests

BASE_URL = "http://127.0.0.1:30000"
MODEL = "Qwen/Qwen2.5-0.5B-Instruct"

choices = {
    "A": "billing and payments",
    "B": "technical support",
    "C": "account access",
}

ticket = "I was charged twice for the same subscription."
choice_lines = "\n".join(
    f"{label} = {meaning}" for label, meaning in choices.items()
)

prompt = f"""Ticket: {ticket}

Question: Which category matches the ticket?
Allowed labels:
{choice_lines}
Return only the label.
Label: """

print(prompt)
字典保存答案的两层表达: A 是用于打分的 token;“billing and payments” 是返回给应用的业务含义。 分词、打分、结果映射全程,两者顺序必须保持不变。
生成的提示词原文:
Ticket: I was charged twice for the same subscription.

Question: Which category matches the ticket?
Allowed labels:
A = billing and payments
B = technical support
C = account access
Return only the label.
Label:
提示词以Label:结尾。我们要获取紧随其后位置的模型分值,不要求 SGLang 生成 token。
步骤 3:解析标签对应的 Token ID
在提示词代码下方追加:
label_token_ids = []

for label in choices:
    response = requests.post(
        f"{BASE_URL}/tokenize",
        json={
            "model": MODEL,
            "prompt": label,
            "add_special_tokens": False,
        },
        timeout=30,
    )
    response.raise_for_status()
    token_ids = response.json()["tokens"]

    if len(token_ids) != 1:
        raise ValueError(
            f"{label!r} is not a single token: {token_ids}"
        )

    print(f"{label!r} -> {token_ids}")
    label_token_ids.append(token_ids[0])
SGLang 的/tokenize接口返回 Qwen 分词器输出的整数 Token ID。如果一个标签分词后得到多个 token,直接抛出异常。打分请求要求每个选项只占用词表一个位置。
Qwen/Qwen2.5-0.5B-Instruct 运行输出示例:
'A' -> [32]
'B' -> [33]
'C' -> [34]
每个列表只有一个整数,说明全部标签都是单 token。后续打分接口读取词表 32、33、34 位置的值。
这个校验也提醒我们:不要假设不同模型分词行为一致。在 Qwen 可用的标签,换到别的分词器可能会被拆成多个 token。
步骤 4:请求 SGLang 获取三项概率
继续追加打分请求代码:
response = requests.post(
    f"{BASE_URL}/v1/score",
    json={
        "model": MODEL,
        "query": prompt,
        "items": [""],
        "label_token_ids": label_token_ids,
        "apply_softmax": True,
    },
    timeout=120,
)
response.raise_for_status()
score_response = response.json()

print(json.dumps(score_response, indent=2))
scores = score_response["scores"][0]
query:完整提示词; items为空字符串,代表对提示词末尾紧接着的位置打分; label_token_ids:告诉 SGLang 读取词表里哪三个位置; apply_softmax:将选中 logits 归一化为概率。
因为 items 数组只有一项,返回的 scores 只包含一组分值。在同一份 Qwen 权重上运行得到返回:
{
  "scores": [
    [
      0.67776233,
      0.310878605,
      0.011359035
    ]
  ]
}
这三组分值依次对应 A、B、C。Softmax 之前原始 logit 为 25.277620、24.498226、21.188837。硬件与精度设置不同,数值会小幅浮动。
接口文档说明,返回分值列表顺序和label_token_ids保持一致。第一个分值对应 A,第二个 B,第三个 C。
步骤 5:模型标签转回业务决策
脚本收尾,增加映射逻辑:
probabilities = {
    choices[label]: float(score)
    for label, score in zip(choices, scores, strict=True)
}

decision = max(probabilities, key=probabilities.get)

print(
    json.dumps(
        {
            "decision": decision,
            "probabilities": probabilities,
        },
        indent=2,
    )
)
新开终端运行脚本python decide.py,输出示例:
{
  "decision": "billing and payments",
  "probabilities": {
    "billing and payments": 0.6777623295783997,
    "technical support": 0.31087860465049744,
    "account access": 0.011359035037457943
  }
}
打分计算由 SGLang 在/v1/score内部完成。SGLang 服务一次性完成标签分词、Qwen 前向推理,返回概率。
本例中账单团队得分最高,但概率仅 0.678。如果业务策略要求阈值 0.7,这条工单就不会自动处理,转入人工复核。阈值需要基于标注数据集评估确定。
对比打分推理与自回归生成的延迟
上面的单次请求演示了原理。我还搭建了小应用,大批量测试这套机制的表现。
演示程序支持多款开源模型:Qwen3 4B、Qwen2.5 0.5B /1.5B、SmolLM2 1.7B、TinyLlama 1.1B、DeepSeek-R1-Distill-Qwen 1.5B。
Jev 风格打分链路调用决策方法:
result = engine.decide(request)
answer = result["answers"]["decision"]
choice = answer["choice"]
probabilities = answer["probabilities"]
decide()内部,SGLang 接收/v1/score请求,附带 A/B/C 的 Token ID。 SGLang 运行提示词推理,读取这三个下一个 token 分值,归一化,然后直接返回。不生成任何输出 token。
标准生成链路,在同一个引擎调用生成接口:
result = engine.generate_response(
    case["state"],
    case["question"],
    list(case["criteria"].items()),
    max_tokens=32,
)
该方法向/v1/chat/completions传入相同上下文、问题和候选选项。 Qwen 生成回答和简短解释,最多 32 个 token。应用在返回文本前 100 字符内,提取匹配的合法选项。解析结果和标注标签一致则判定正确。配套视频演示两种方案对比。
我基于本地固定数据集模拟了 100 条测试用例。 数据集场景包含客服工单路由、候选人筛选、费用审核。数据集自带标准答案,界面可以同时展示速度与准确率。
远端 SGLang 测试代码用线程屏障同时启动两组 worker:
starting_line = threading.Barrier(2)

def worker(lane, runner):
    starting_line.wait()
    for case in cases:
        updates.put(runner(case))

workers = [
    threading.Thread(target=worker, args=("jev", run_jev)),
    threading.Thread(target=worker, args=("llm", run_llm)),
]

for worker_thread in workers:
    worker_thread.start()
屏障会同时释放两个工作线程。两条链路按顺序处理各自用例。Jev 打分 worker 上一个请求结束立刻发起下一次打分;标准生成 worker 同理。
两条链路同时跑,但不会一次性并发提交全部 200 个请求。SGLang 接收两条链路的并发任务,通过连续批处理调度。两种请求共用同一张 GPU、显存带宽与调度器。
配套视频并排对比 Jev 方案和常规 LLM 生成。
注:视频 8 秒后做了倍速处理,所以 LLM 请求看起来完成很快。 两条链路同时启动,服务端使用 Qwen/Qwen3-4B-Instruct-2507,共用同一个 SGLang 实例。
如何选择合适方案
打分方案并不能完全替代文本生成。Jev 这套思路,仅适用于推理前应用就已经定义好输出空间的场景。
适配场景特征:
-
存在有限且有意义的标签集合; -
每个标签对应不同下游动作; -
调用方只需要标签和概率分布,不需要生成新文本。
结构化输出则不同:它只定义返回内容的语法格式,解码器依旧逐个 token 生成字段名与字段值。 当候选值无法预先枚举时,选用结构化生成;打分方案只有候选集合已知时,才能跳过自回归解码循环。
一张图对比普通 LLM 解码、结构化输出生成、Jev 式打分:
简单选择准则,看你需要的输出形式:
-
推理前不知道输出内容 → 使用生成; -
输出候选集合已知,只需要做选择 → 使用打分。此时第一个 next-token 向量已经包含排序结果,直接读取排序,省去不需要的自回归循环。
再次强调:本文项目复现的是Jev 风格推理机制,不是 Jev 模型权重、RLCD 流程,也不是完整评估栈。