编者摘要:LangChain 联合 TypeSafe AI 测试了 Jev 作为智能体评估器的效果。Jev 属于 System One 决策模型,并非传统自回归大模型,不生成文本,直接返回带概率的类型化输出,支持选择、打分、布尔判定三类评估任务。当前智能体评估分为代码评估(稳定但适用范围窄)与 LLM-as-judge(灵活,但不稳定、昂贵、速度慢),Jev 有望成为第三种方案。
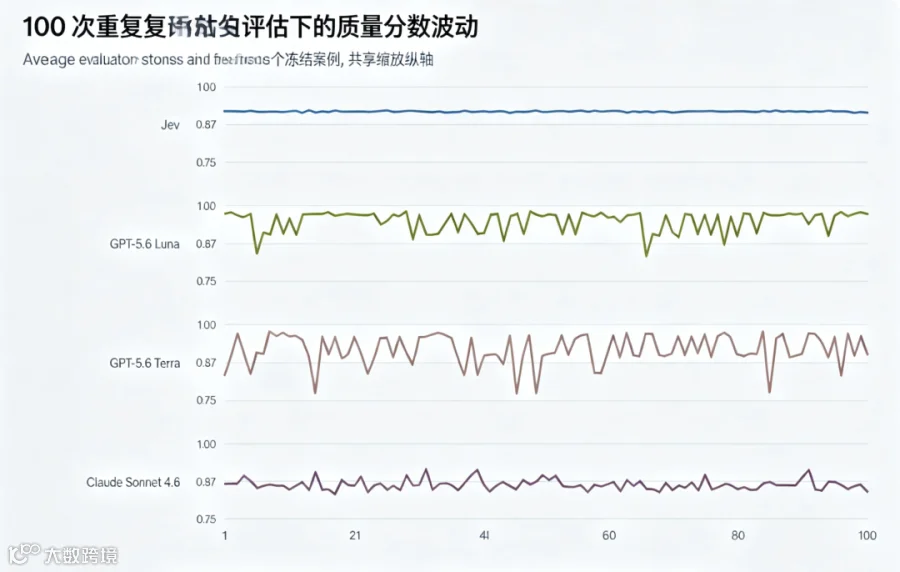
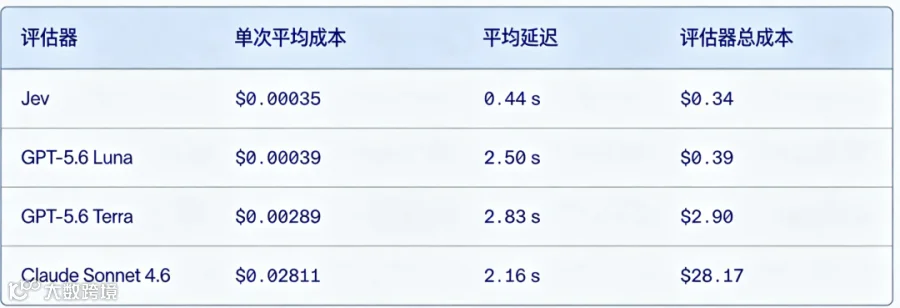
本次实验以天气查询智能体轨迹为固定测试集,人工标注作为真值基准,对比 GPT 与 Claude 模型。结果显示 Jev 在二元判定上 100% 匹配人工标注,打分方差远低于其他模型,稳定性提升数十至上百倍;单次调用仅 0.00035 美元,平均 0.44 秒,总成本远低于 Claude。低成本高稳定的特性,让大规模线上智能体评估成为现实,能够对更多生产轨迹持续监控,更早发现模型退化。
但实验规模较小,结论通用性有待验证;低成本会放大评估器本身的错误,仍需人工校验。System One 模型可大幅压缩智能体测试成本,缩短智能体开发反馈闭环。
10 个关键问题 Q&A(基于 Jev vs GPT vs Claude Judge 评测数据)
背景:这组数据是大模型作为评判器(LLM-as-Judge)的对比,核心维度:单次调用成本、延迟、信号价值(准确率 × 可重复性)、规模化成本
Q1:本次对比的 4 个评判模型分别是谁?
A:Jev、GPT-5.6 Luna、GPT-5.6 Terra、Claude Sonnet 4.6。全部作为 LLM Judge(大模型裁判),用来评估模型输出质量。
Q2:哪个评判模型单次调用成本最低?低多少?
A:Jev,单次调用成本仅 $0.00035。
-
对比 GPT-5.6 Luna:$0.00039,略高于 Jev -
GPT-5.6 Terra:$0.00289,是 Jev 的 8 倍多 -
Claude Sonnet4.6:$0.02811,达到 Jev 的 80 倍以上
Q3:延迟表现最好(响应最快)的模型是哪一个?差距有多大?
A:Jev,0.44 秒,大幅领先其他模型。 GPT-5.6 Luna 2.50s,Claude Sonnet4.6 2.16s,GPT-5.6 Terra 最慢 2.83s。Jev 延迟仅为第二名 Claude 的约 1/5。
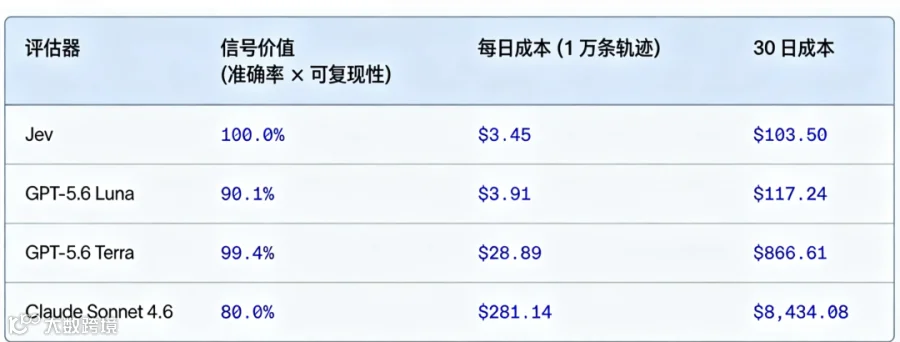
Q4:什么是 Signal value 信号价值?
A:信号价值 = 准确率 × 可重复性(repeatability),用来衡量 LLM-as-Judge 评判结果的可靠程度。数值越高,裁判打分越准、多次打分结果越稳定。
Q5:哪个模型信号价值最高?
A:Jev,100.0%。GPT-5.6 Terra 99.4% 紧随其后;GPT-5.6 Luna 90.1%;Claude Sonnet4.6 仅 80.0%。 👉 重点结论:Jev成本最低、速度最快,评判可靠性还最高。
Q6:10000 条 trace 样本场景下,每日成本差距有多大?
A:
-
Jev:$3.45 / 天 -
GPT-5.6 Luna:$3.91 / 天 -
GPT-5.6 Terra:$28.89 / 天 -
Claude Sonnet4.6:$281.14 / 天 Claude 每日成本是 Jev 的 80 倍以上。
Q7:30 天连续跑 10k trace,总成本对比?
A:
-
Jev:$103.59 -
GPT-5.6 Luna:$117.24 -
GPT-5.6 Terra:$866.61 -
Claude Sonnet4.6:$8434.08 Claude 30 天成本约是 Jev 的 81 倍。
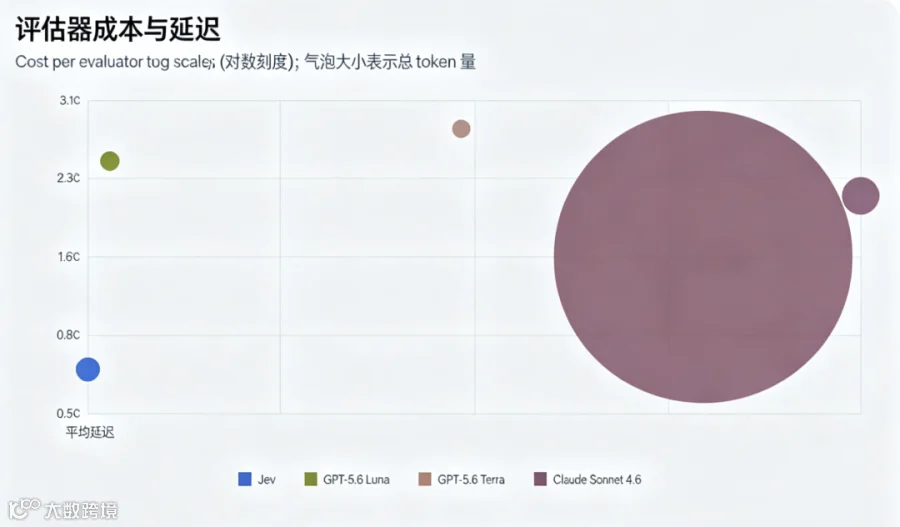
Q8:气泡图怎么解读?
A:横轴是单次调用成本(对数刻度,越往右越贵);纵轴是延迟(越往上越慢);气泡大小 = 单次调用总 token 数量。左下、气泡更小 = 又快又便宜。Jev 在最左下角,是最优平衡点;Claude 气泡最大,位置最靠右上,最贵、token 消耗最多。
Q9:GPT-5.6 Terra 信号价值接近 Jev,但为什么不推荐优先选用?
A:虽然 Terra 信号价值 99.4% 很高,但成本和延迟大幅劣于 Jev。单次调用成本是 Jev8 倍,延迟 2.83s;规模化后 30 天成本 $866,是 Jev 的 8 倍,性价比远低于 Jev。
Q10:这个评测对于 LLM 评估流水线的工程落地有什么启示?
A:LLM-as-Judge 选型不只要看评判准确度,成本、延迟、可重复性三者必须一起评估。Jev 案例证明专用轻量 Judge 模型,可以做到「更高评判可靠性 + 极低成本 + 极低延迟」,替代通用大模型做自动化评估,大幅降低评测流水线开销。
附录:ev 即评判器:智能体评估方案
作者:Daniel Shea、Seán Roche
核心要点
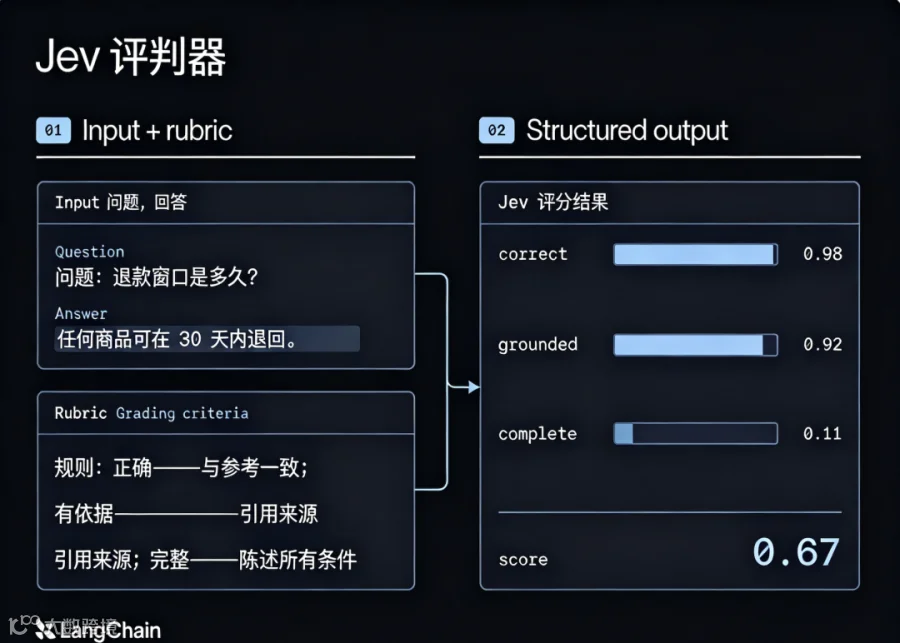
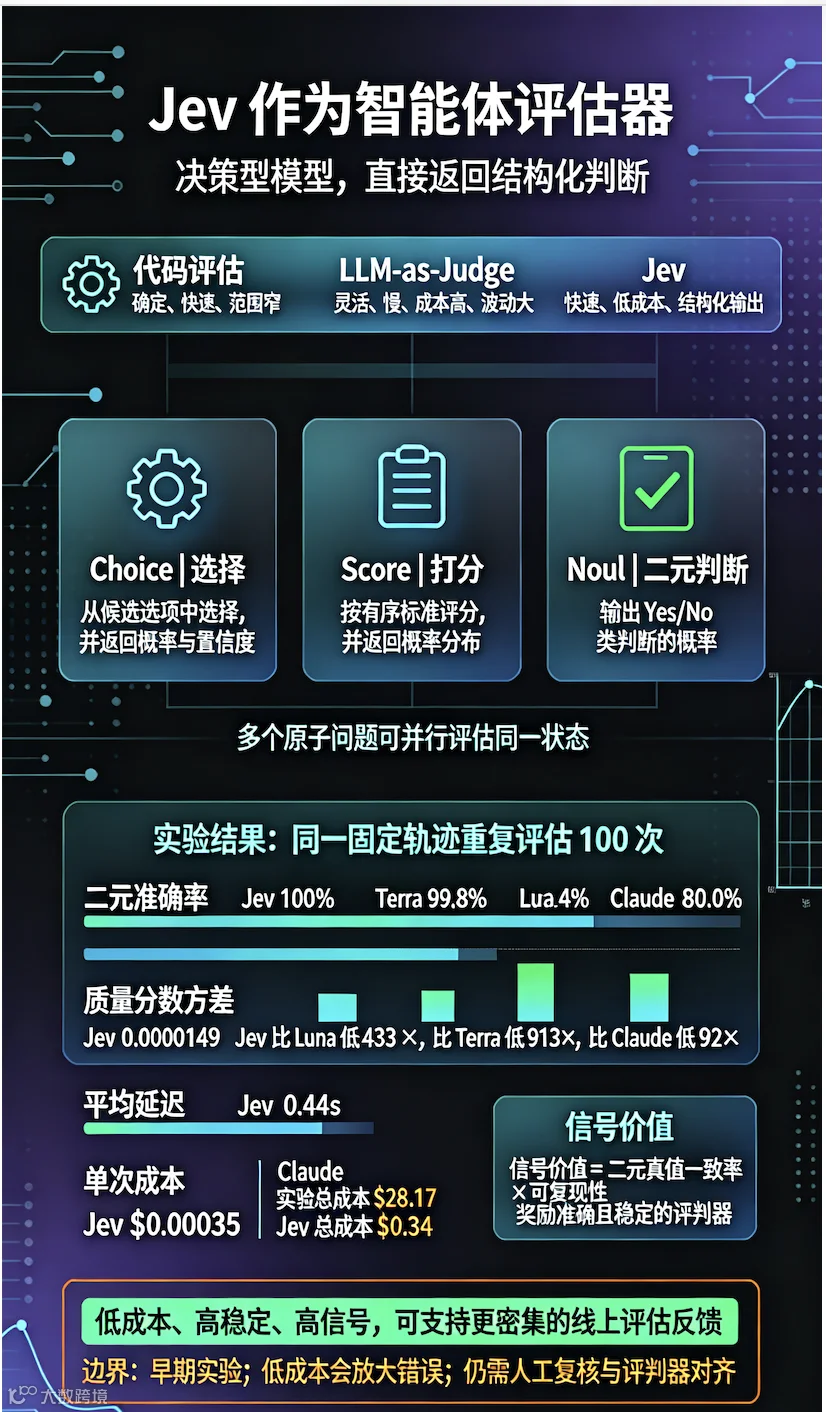
Jev 是一种本质上全新的评估器。它直接返回类型化结果,不像大模型评判器那样生成文本。 在连续打分任务中,Jev 稳定性大幅提升,质量分数方差比 GPT-5.6 Luna、Terra 以及 Claude Sonnet 4.6 低 92~913 倍。 同时 Jev 速度最快、成本最低:单次调用平均耗时 0.44 秒,费用 0.00035 美元;本次实验总花费 0.34 美元,而 Claude 达到 28.17 美元。 实验结果前景可观,但仍处于早期阶段。尽管本次测试范围有限,但 Jev 的表现,为智能体评估开辟了极具吸引力的新方向。
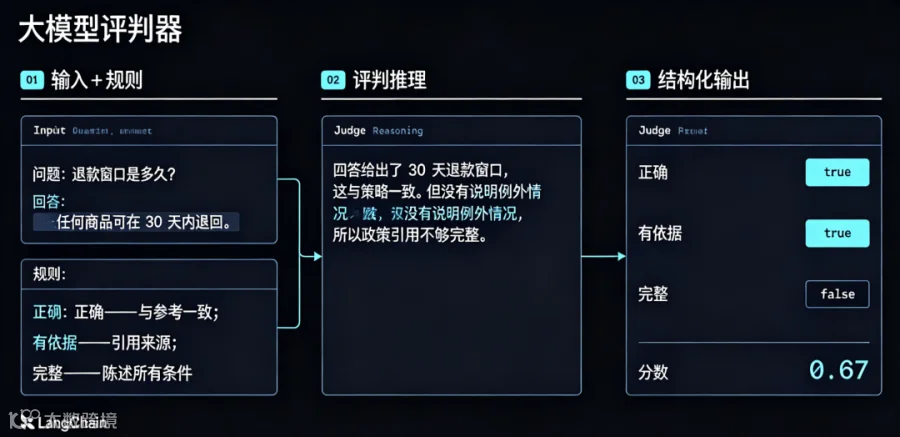
当前智能体评估主要分为两类:基于代码的评估与LLM-as-judge(大模型充当评判器),二者都存在局限。随着 TypeSafe AI 发布 System One 系列模型与 Jev,LangChain 团队希望验证这类 “系统一号模型” 能否成为第三种智能体评估方案,以及它对智能体工程的价值。
什么是 Jev?
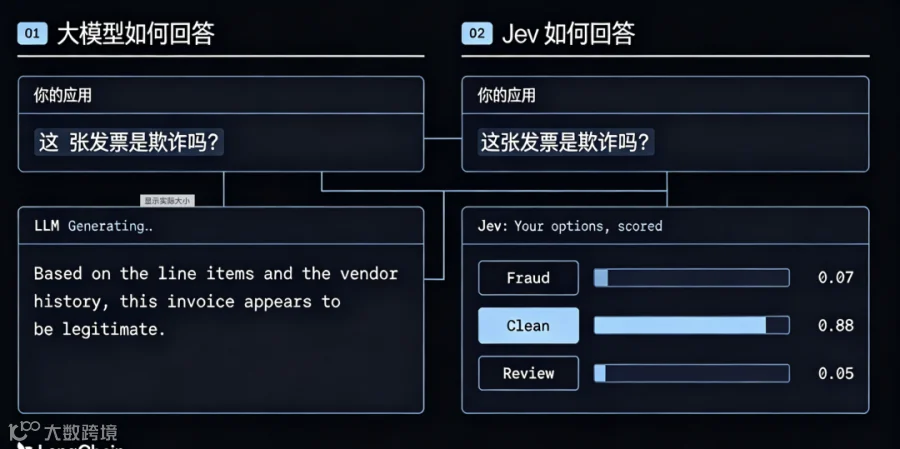
Jev 是 TypeSafe AI 推出的全新模型,它并非传统大模型,不生成文本,被团队称为System One(系统一号)模型。
System One 模型:一类专为快速结构化决策打造的 AI 模型,输出结果可直接被软件使用。它读取状态,返回带概率的类型化答案。
据 TypeSafe AI 介绍,分类任务上 Jev 推理速度最高可达同类大模型 200 倍,成本降低 400 倍。
Jev 为何适合作为智能体评估器?
现有两种评估方案各有利弊:
- 代码评估
成本低、速度快、结果稳定,但适用面极窄。它依赖固定确定输入,很难评估智能体随机、开放的行为。例如代码可以检测智能体是否调用工具,但难以判断智能体是否利用工具结果成功回答用户问题。开放任务存在多种有效解法,无法全部硬编码成判定逻辑。 - 大模型评判器
(LangSmith LLM-as-judge):可以接收非结构化的智能体运行轨迹,依靠提示词打分。但天生具有不确定性,不适合作为可靠测试底座;同时速度慢、成本高。
智能体评估本质是决策任务:基于智能体状态与行为给出打分反馈。Jev 原生适配该场景,针对结构化状态做类型化判定并附带概率;自回归大模型则逐 token 生成文本再转为打分。实验证明,这种 “先决策” 设计带来更低延迟、成本与方差。
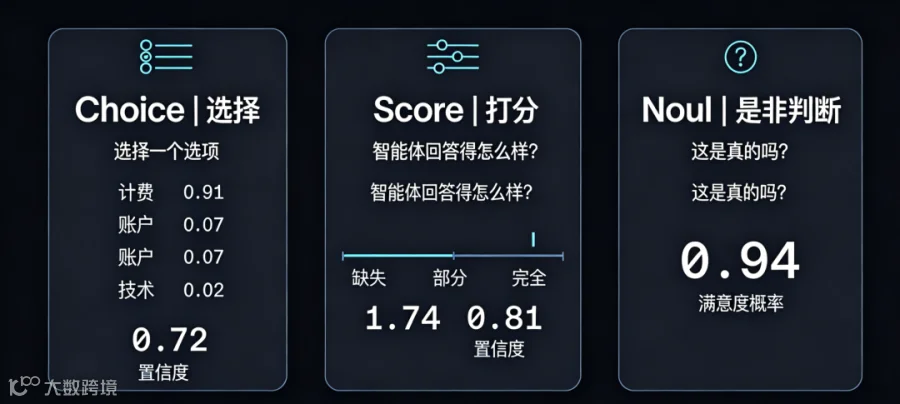
Jev 支持三类判定问题,可并行对同一状态执行多条原子评估:
- Choice(选择)
选出选项,返回概率与置信度。例:最终答案是否基于检索证据?输出 0~1 浮点数。 - Score(打分)
按分级量表评分,附带概率置信度。例:回答实用性如何?输出 1~5 分。 - Noul(是非判定)
返回布尔判断的概率。例:本次检索属于哪一类行为?输出枚举结果。
Jev 评估实验
评估智能体时,若每次运行的智能体行为、检索数据、轨迹上下文发生变化,评判器对比会失真。LangChain 的 Deep Agents 与 LangSmith 平台可以捕获单次智能体运行记录作为数据集,在不同模型上回放。
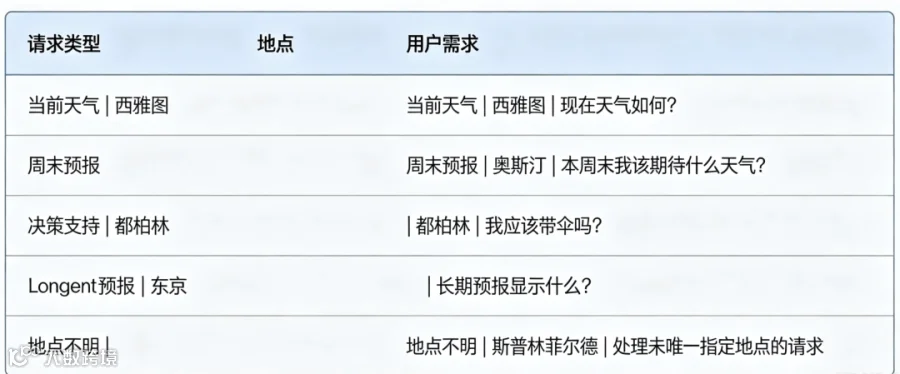
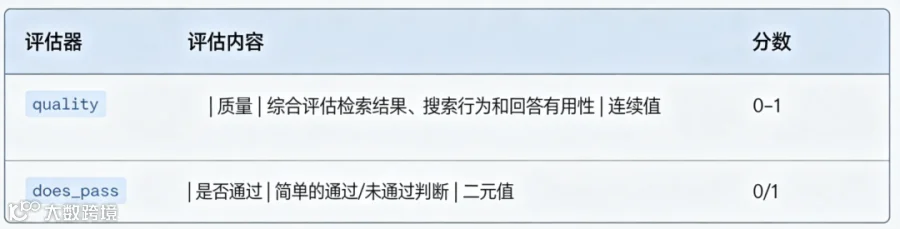
本次实验基于 Deep Agents 开源框架搭建目标智能体,在 LangSmith 数据集定义测试集,包含 5 条天气查询请求。将智能体应答轨迹固定保存,所有评判器评估这 5 组固定轨迹,输出两项指标:连续质量分、二元是否通过判定。 人工标注作为基准真值,区分准确度(与人工标注一致程度)和可复现性(相同轨迹多次打分是否稳定,用方差衡量)。方差低不等于准确度高,可能稳定地判错;但准确度高 + 低方差,才适合线上生产环境。 对照组:GPT-5.6 Luna、GPT-5.6 Terra、Claude Sonnet 4.6;每组重复 100 次评估。
评估结果
- 准确度(二元通过 / 失败判定,对标人工真值)
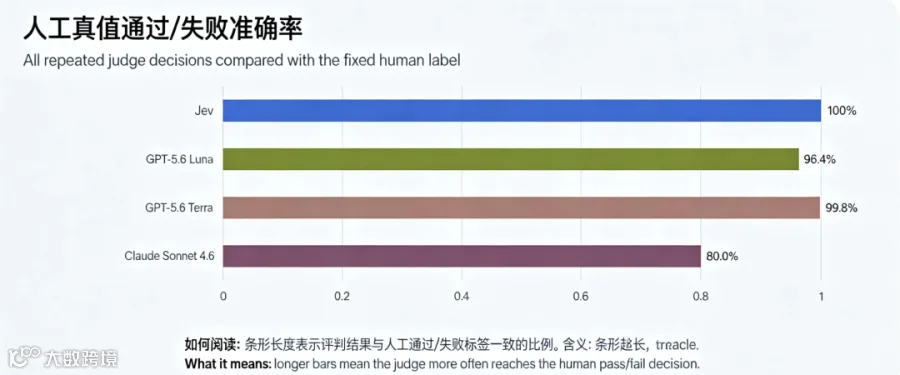
Jev 在全部 500 次重复判定中完全匹配人工标注;Terra 匹配 99.8%,Luna96.4%,Claude 仅 80%。 - 稳定性(分数方差)
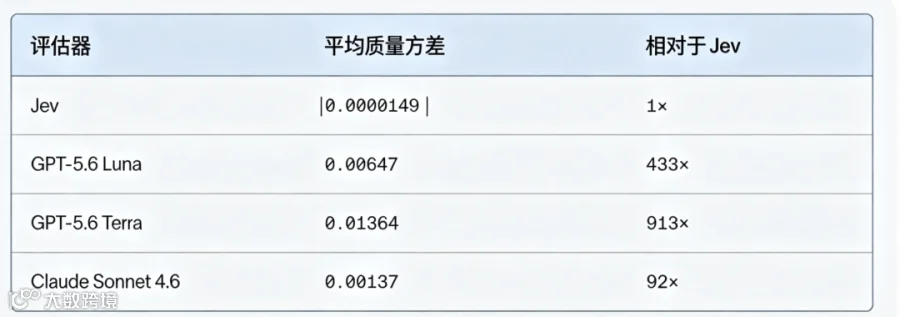
Jev 单案例平均方差仅 0.0000149。Luna 方差高出 433 倍,Terra 高出 913 倍,Claude 高出 92 倍。
注:本次观测无法证明方差低的底层原因。猜想:Jev 训练目标是输出校准概率与类型化结果;LLM 评判器要先生成文本,再解析成分数,天然引入波动。仅为观测结论,不能证明训练目标直接导致低方差。
- 延迟与成本
单次调用 0.00035 美元,让大规模智能体评估具备可行性。传统高成本评判器需要在评估覆盖率与预算之间取舍;低成本意味着可以增加重复校验、频繁回归测试。线上评估场景收益更大,可以对更多生产轨迹运行评判,得到更密集反馈。
生产场景举例:每日产生 1 万条智能体轨迹,单调用成本差异带来巨大运维差别。 定义信号价值= 二元真值一致率 × 可复现性(同轨迹两次独立调用得出相同结论的概率),奖励既准确又稳定的评判器,惩罚稳定但持续出错的评估器。
新型智能体评估范式
传统智能体评估存在取舍:评估样本越多、维度越多,测试成本越高,企业不得不缩减评估量。 Jev 单次调用成本极低,同时兼具高准确度、低方差,信号质量高。开发者可以针对每条智能体运行记录做多维度评估,每次模型改动都做测试,高置信场景重复校验。
高质量智能体依赖大量测试与监控,评估越频繁,开发反馈越有效。 局限:本次实验范围有限,不确定结论能否迁移到其他智能体与生产工作流;低成本也会放大错误 —— 一个持续判错的评估器,大规模使用会批量输出错误反馈。工程流程仍需要人工复核与评判器对齐。
System One 这类新模型,有望实现大规模高质量评估,缩短智能体完整开发周期:开发者把更多轨迹转化为反馈,尽早发现性能退化,加速智能体构建、测试、监控与上线闭环。它带来的价值不只是评估降价,更是构建可靠智能体的更紧密反馈环。
可复现信息
项目开源仓库:https://github.com/danielgshea/jev-as-a-judge LLM 评判器通过 LangSmith Gateway 调用:GPT-5.6 Luna、GPT-5.6 Terra、Claude Sonnet 4.6。Jev 使用 langchain-typesafe==0.0.1a2。 版本:Deep Agents 0.7.15、LangChain OpenAI 1.6.2、LangSmith 0.12.6、Tavily Python 0.8.3。LLM 评判器未设置温度、top-p、随机种子、最大 token,使用服务商默认参数。Jev 服务版本未记录在实验元数据。