

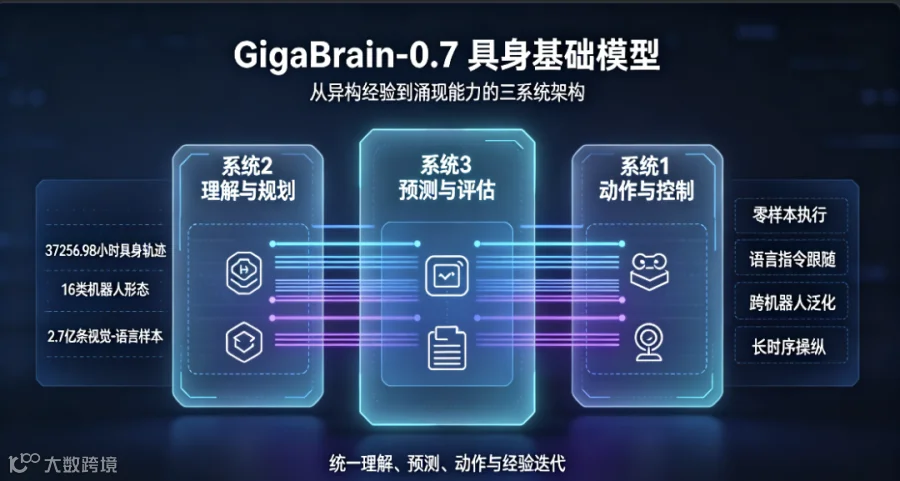
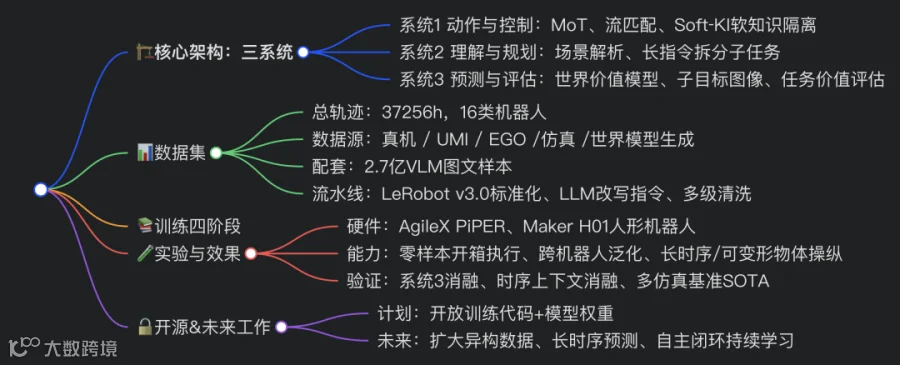
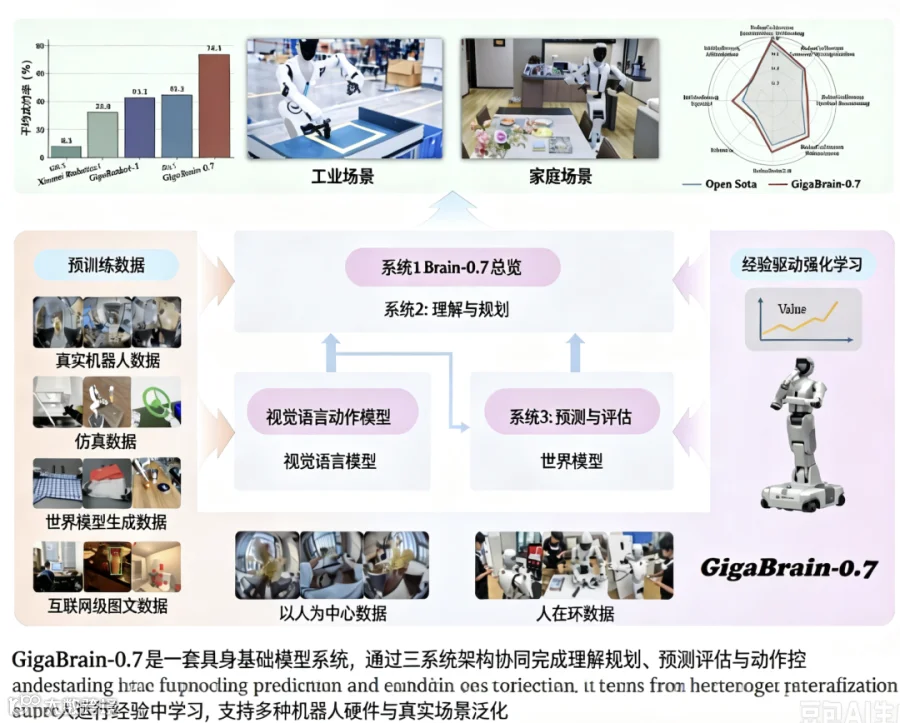
编者摘要:GigaBrain‑0.7 是 GigaAI 推出的具身基础模型,核心创新为三系统协同架构,旨在解决现有 VLA 模型规划弱、缺少预测评估、跨机器人泛化差的痛点。 三大子系统分工:系统 1 负责动作与控制,采用 MoT 混合 Transformer 架构、流匹配生成连续动作,引入 Soft‑KI 软知识隔离,平衡视觉语言能力与机器人控制;系统 2 完成理解与规划,解析场景,把长指令拆解为可执行子任务;系统 3 为预测与评估,基于世界价值模型预测未来视觉子目标图像、输出任务进度价值信号,为动作生成提供条件输入。
数据集规模达到37256 小时异构具身轨迹数据,覆盖 16 种机器人,包含真机、UMI、EGO 人类第一视角、仿真、世界模型生成数据,配套 2.7 亿条图文样本;开发统一 LeRobot v3.0 数据处理流水线,完成格式归一化、大模型指令改写、多阶段数据清洗。
训练采用单阶段 VLA 联合预训练,后续冻结系统 3 做任务后训练,再执行离线 + 在线人在回路强化学习,实现持续迭代优化。
在 AgileX PiPER、自研 Maker H01 人形机器人完成大量实物测试。消融实验证明系统 3 的子目标图像 + 价值评估可显著提升任务成功率、执行效率;时序上下文能够消除相似视觉状态带来的歧义。在多仿真基准 RoboTwin2.0、EBench、RoboColiseum 取得 SOTA;开箱零样本、后训练任务成功率全面超越前代 GigaBrain‑0 系列与 π₀.₅等主流基线。后续将开源全部代码与权重,未来方向为扩大数据规模、增强长时序预测、完全自主闭环学习。
10 个关键问答
当前主流 VLA(视觉‑语言‑动作)机器人模型普遍存在三大痛点:跨机器人硬件泛化弱、缺少未来状态预判能力、训练链路割裂,难以支撑长时序真实家庭、工业任务。GigaBrain‑0.7 创新性提出三系统协同架构,基于 37000 + 小时异构机器人数据,实现理解规划、预测评估、动作控制一体化,支持零样本泛化与经验驱动闭环迭代,全部训练代码与模型权重计划开源,兼容多款主流机械臂与自研 Maker H01 人形机器人。
论文标题:GigaBrain‑0.7: Scaling Embodied Foundation Models to Emergent Capabilities with a Three‑System Architecture
机构:GigaAI,arXiv:2608.15875,2026‑08‑16
项目主页:https://gigaai.cc/blog/gigabrain07;代码仓库:https://github.com/open‑gigaai/giga‑brain‑0
一、研究背景与动机
视觉‑语言‑动作(VLA)模型是通用具身智能体主流方案,可将图像观测、语言指令转化为机器人动作,在结构化环境下表现优秀。现有方案存在四大核心痛点:
- 跨机器人泛化难题
不同机器人硬件自由度、动作空间差异巨大;简单增加轨迹数据会引入噪声干扰,不一定带来知识迁移。 - 反应式范式局限
绝大多数 VLA 是 “观测直接输出动作” 的反应式模型,缺少对未来状态预测、任务执行进度评估的显式机制。 - 训练流水线碎片化
多阶段训练会造成优化割裂,规划、预测、动作执行、经验反馈无法完整协同。 - 缺少闭环持续学习能力
大多模型止步于监督模仿,难以利用机器人自身运行失败、人工修正反馈持续迭代。
针对以上问题,本文提出GigaBrain‑0.7 具身基础模型,核心创新为三系统协同架构;构建超 37000 小时大规模异构具身数据集;提出单阶段对齐联合训练,统一视觉语言理解与多机器人动作生成;实现从预训练、后训练到离线‑在线强化学习的完整闭环学习链路。 对比前代 GigaBrain‑0 系列与 π₀.₅等 SOTA 基线,在零样本开箱能力、语言指令跟随、后训练任务成功率获得显著提升;在自研 Maker H01 人形机器人与多款主流机械臂完成家庭、工业场景真机验证,训练代码与权重计划开源。
二、相关工作梳理
论文把现有具身 VLA 相关工作划分为三大板块:VLA 架构、VLA 训练范式、世界模型赋能 VLA。
2.1 VLA 架构三大技术路线
- 自回归 VLM‑as‑Actor
将连续动作编码为离散 Token,复用 VLM 自回归能力输出动作(RT‑2、OpenVLA、Galaxea G0.5)。缺点:控制频率、预测窗口增大时解码开销急剧上升。 - 串行级联 VLM + 动作专家
VLM 仅作为多模态编码器,外接独立参数的动作解码器,代表:GR00T N1、Gemini Robotics、Qwen‑RobotManip。缺点:性能高度依赖 VLM 与动作模块之间的特征接口质量。 - 并行 Transformer 混合 MoT 架构
VLM 主干与独立连续动作专家深度耦合,是当前主流高性能路线。π₀系列、GigaBrain‑0、Xiaomi‑Robotics 系列均属于该范式。
GigaBrain‑0.7 继承 MoT 双流架构,并额外独立拆分出规划模块、世界预测评估模块,形成三套系统。
2.2 VLA 训练范式
- 多阶段预训练
分开做表征学习、动作优化;先训练 VLM,再冻结或者微调接入动作头,代表 π₀.₅、Xiaomi‑Robotics‑0/1。缺点:存在优化碎片化。 - 单阶段联合预训练
同一个训练周期同时优化图文理解、子任务推理、离散 / 连续动作;GigaBrain‑0.7 采用该路线。 - 任务后训练 SFT
利用目标硬件少量演示数据,把通用预训练模型适配到特定机器人与任务。 - 强化学习闭环
从机器人自身 rollout 轨迹学习,分为在线 RL、离线 RL(AWR、RECAP、RAMP、FlowPRO),从单纯模仿走向 “运行‑失败‑修正‑更新” 闭环学习。
2.3 世界模型赋能 VLA 的四类应用
- 数据增强生成
世界模型作为数据引擎生成虚拟交互轨迹,弥补真机采集成本高的问题(GigaBrain‑0、DreamGen)。 - 统一世界‑动作模型
同一个生成模型同时预测未来视频 + 机器人动作(GR2、DreamZero、UWM、Cosmos Policy)。 - VLA 与世界模型闭环迭代
策略失败轨迹更新世界模型,更新后的世界模型再训练 VLA(World‑VLA‑Loop)。 - 作为策略条件与价值估计
输出预测子目标图像、任务进度价值,作为 VLA 策略输入条件(π₀.₇、GigaBrain‑0.5M* RAMP)。
GigaBrain‑0.7 专门独立出 System3 预测评估子系统,复用该思路,并且拓展更长预测窗口。
三、数据集构建与标准化处理流水线
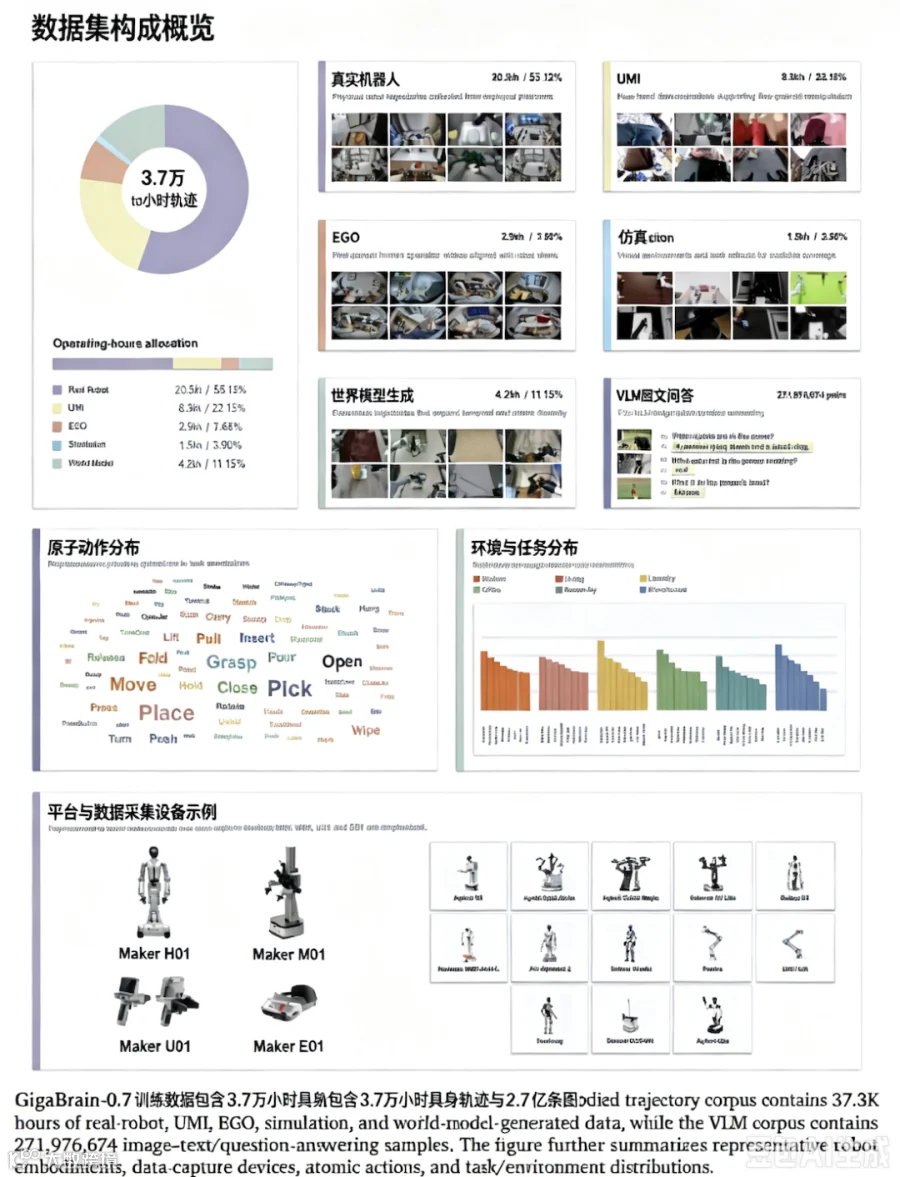
总数据集分为两大组成:具身轨迹数据集+ VLM 图文问答数据集。
3.1 数据集统计
具身轨迹总规模:37256.98 小时,覆盖16 种不同机器人硬件
-
数据类别 时长 (h) 占比 说明 真实机器人 20535.65 55.12% Maker H01/M01、Agibot‑G1、AgileX、Franka、UR5 等 16 款机器人,共 181 万 + Episode UMI 人类操纵演示 8251.83 22.15% 近手视角操纵数据,学习手眼协调 EGO 第一人称人类视频 2862.36 7.68% EgoDex、EgoVerse 等,补充人类交互先验 仿真数据 1453.92 3.90% 物理仿真,复现真机难实现的场景 世界模型生成 WM 4153.22 11.15% 基于真实样本生成,扩充视觉多样性 - VLM 图文问答数据集:271,976,674 条样本
,包含图像描述、VQA、空间推理、目标定位、可操作性预测、机器人任务理解,用于保留模型通用图文能力,避免只训练动作导致语义退化。
3.2 统一数据处理流水线(图 3)
异构原始数据格式、坐标系、标注质量差异巨大,开发整套标准化工具链:
- 格式转换
全部转为 LeRobot v3.0 格式,统一 episode、帧、观测、动作、指令元数据,支持按机器人型号、数据源过滤采样。 - 统一机器人表征
定义统一维度顺序(左臂‑右臂‑头部‑腰部‑底座),区分 “维度不存在” 和 “数值为 0”,用掩码占位,不用为每个机器人单独写格式;统一 TCP 工具中心点、基座坐标系。 - LLM 辅助指令改写与子任务标注
GLM‑5.1 规范化原始任务指令;多模态模型对视频时序切分,生成子任务标签,人工抽样复核。 - 多阶段清洗
-
Q01/Q99 极值过滤,去除动作异常离群点; -
过滤长时间静止无交互片段; -
末端姿态、运动学一致性修正; -
基于训练损失异常样本过滤:高损失轨迹回溯原始视频,剔除时序错位、标注错误样本。 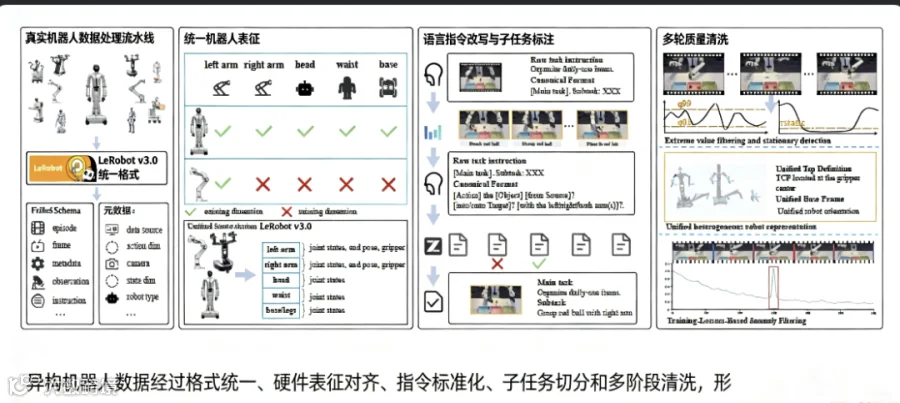
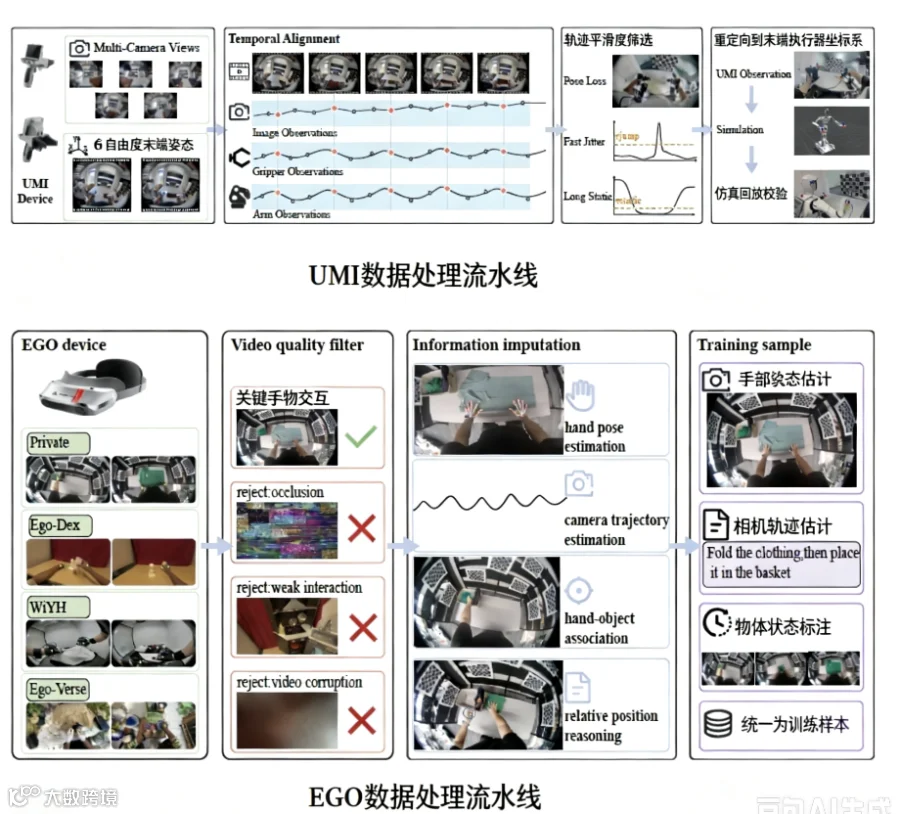
3.3 UMI / EGO 专项处理
- UMI
多相机时间戳对齐,轨迹平滑度筛选;映射到目标机器人 TCP 坐标系;逆运动学、仿真回放校验有效性。 - EGO 第一人称视频
过滤遮挡、模糊、无手物交互片段;补充手部关键点、相机轨迹估计;把人类手动作转化为和机器人轨迹格式一致训练样本,增强近场空间交互理解。
3.4 仿真 & 世界模型生成数据
-
物理仿真:可控复现真机难以安全采集的长尾、危险场景。 -
世界模型生成:基于真实交互样本做视频生成,保留交互逻辑,改变视觉外观,扩充训练分布。二者互补,降低实体机器人采集成本。
3.5 VLM 数据标注流水线
整合公开图文数据,同时从机器人轨迹中自动生成具身 VLM 标注:
-
可操作性预测:识别物体可抓取、可按压、可放置区域; -
空间理解:物体‑物体、物体‑观察者相对位置、遮挡关系; -
高层任务规划:标注任务阶段、当前子任务、下一步动作; 多层自动质控 + 人工抽样审核,输出统一多轮对话格式。
四、模型三系统整体架构(图 6)
整体划分为三层:世界仿真层、动作对齐层、经验增强层;由 System1/2/3 三大子系统协同。

主干配置:System2 (PaliGemma2‑3B VLM);System1:PaliGemma2‑3B 主干 + 0.5B Action Expert 动作专家;System3:GigaWorld‑1 (5B) 世界价值模型。
4.1 世界仿真层(System2 + System3)
System2:理解与规划(VLM)
输入:当前图像观测 + 顶层语言任务指令。 输出:思维链 CoT 推理(识别物体、空间布局)+ 原子子任务指令。 作用:把高层长任务拆解成短期可执行子任务,子任务同时传给 System1 动作模块、System3 世界模型,作为预测条件。
System3:预测与评估(独立世界价值模型 GigaWorld‑1,5B)
输入:当前观测、本体感知、System2 输出的子任务。输出两组关键信号:
- 子目标图像
生成一段对齐子任务时间窗口的短视频,取最后一帧作为短期任务完成后的预期视觉状态,作为视觉条件给到 System1; - 二元优势条件 Aₜ ∈ {0,1}
模型输出标量任务进度 Vₜ,判断当前动作片段是否推动任务前进,编码为提示词输入 System1。
System3 在 VLA 后训练阶段权重完全冻结,只做推理输出信号,不参与梯度更新。
4.2 动作对齐层 — System1:动作与控制(VLA 模型,MoT 双流架构)
输入:当前观测 + 短时视觉记忆、System2 子任务与 CoT 输出、本体感知 + Robot ID、System3 输出的子目标图像、优势条件。 输出:动作块,用于机器人闭环执行。
- MoT 双流机制
-
VLM 流:做因果自注意力,保留原有图文自回归能力; -
Action Expert 动作专家流:双向交叉注意力读取 VLM 流表征,专门负责连续动作生成; - 时空‑空间块 Temporal‑Spatial Blocks
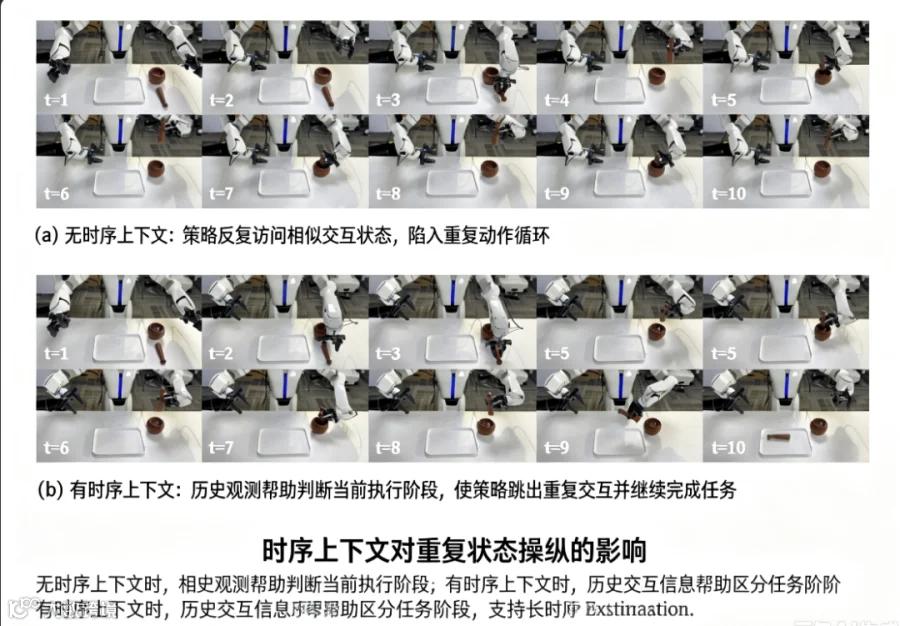
:实现短时视觉记忆。对历史帧做时序聚合,再做空间建模;不直接堆叠全部历史 token,只把时序融合后的当前帧送入主干,控制 token 开销,解决 “画面相似但任务阶段不同” 的状态歧义,防止机器人循环重复动作。 - 双动作输出通路
-
NTP 离散通路:自回归输出离散动作 token,训练阶段打通语言与动作符号; -
FM 流匹配连续通路:生成连续动作块,部署推理阶段实际使用。 - Soft‑KI 软知识隔离(Soft Knowledge Insulation)
改进之前 Knowledge Insulation 完全阻断梯度的方案:流匹配 FM 损失的梯度在流入 VLM 主干前乘以衰减系数 α_KI(0<α_KI<1)。既让 VLM 学习机器人具身特征,又最大保全原始视觉‑语言通用能力,避免动作训练破坏 VLM 语义能力。 - 硬件感知状态接口
本体状态 + Robot ID 输入;Action Expert 主体参数全部机器人共享;每个机器人拥有独立输入输出投影层适配不同自由度;旋转统一使用 6D 连续表示。
4.3 经验增强层
提供离线、在线强化学习接口,复用 System1 作为 Actor,不需要新增独立控制器。
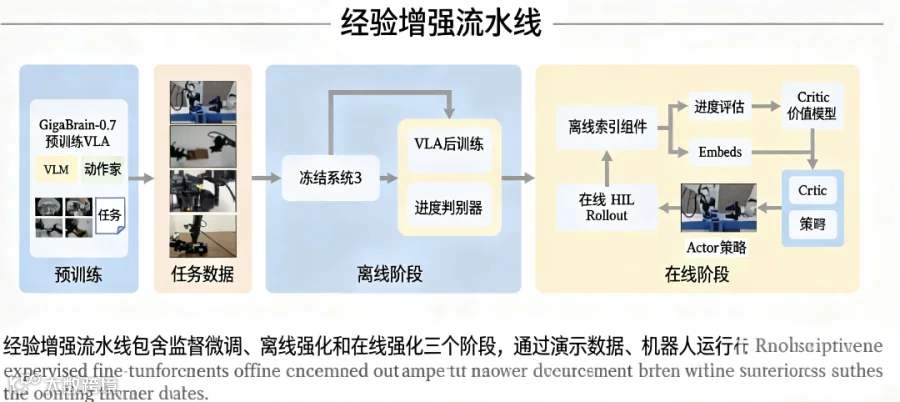
-
人在回路 HIL 数据用于离线训练,训练出进度判别器,获得具备一定错误恢复能力的策略; -
在线交互时,子任务成功标签 + 进度判别器构建稠密奖励;接入轻量 Actor‑Critic 循环; -
形成完整生命周期:预训练‑后训练‑离线 RL‑在线 RL‑部署迭代。
五、完整四阶段训练流程
阶段 1:VLA 联合预训练(System1+System2)
在全部异构语料上单阶段联合训练,同时优化两大损失:
-
NTP 自回归损失ℒ_NTP:预测语言描述、子任务、离散动作、VQA、定位等; -
流匹配损失ℒ_FM:训练连续动作专家; 总损失 ℒ_VLA = ℒ_NTP + ℒ_FM;启用 Soft‑KI 对 FM 梯度做衰减。
训练技巧:
-
时序上下文:训练随机丢弃历史帧,防止模型依赖固定历史长度; -
分层任务监督:混合两种样本:①同时给顶层指令 + 子任务;②只给顶层指令,要求 System2 自己推理子任务,训练高层规划; -
多机器人统一优化:利用掩码区分无效维度,EGO 人类动作转换到当前观测坐标系。
阶段 2:System3 世界价值模型预训练(GigaWorld‑1)
两步训练:
- 面向机器人的视频预训练
在机器人操纵数据上微调 GigaWorld‑1,学习机器人交互的视觉状态转移;输入条件为观测 + 子任务,生成未来短视频; - 价值头学习
扩展为世界价值模型,新增价值预测头,预测子任务完成进度标量 Vₜ; 完成之后 System3 权重永久冻结。
阶段 3:基于世界模型条件的 VLA 任务后训练
下游任务微调,System3 只做推理输出信号,只更新 System1、System2。
-
输入增加两组条件:System3 输出子目标图像 gₜ,由 Vₜ计算得到二元优势 Aₜ; \(A_{t}=\mathbb{1}\left[V_{t+\delta_{t}}-V_{t}>0\right] \in\{0,1\}\) - 条件随机 dropout
:子目标图像 50% 概率丢弃,价值条件 15% 概率丢弃;防止策略过度依赖 System3 输出;训练时模型会接触四种组合(都不用、只用图像、只用价值、两者全开)。 -
在增强上下文 c_t^post 下,继续使用流匹配损失优化连续动作。
阶段 4:经验驱动强化学习(离线→在线人在回路 RL)
演示数据覆盖状态有限,真机部署会遇到大量失败状态,直接在线 RL 样本效率极低,采用分阶段方案:
- 离线经验强化
部署后收集 rollout 轨迹(成功 + 失败);采用 AWR 优势加权回归,高优势样本权重更高,失败样本权重压低;不做新环境交互,利用已收集数据提升策略,给在线 RL 更好初始化。 - 带人工修正的在线强化学习
部署策略运行;机器人陷入困难状态时人类给出修正动作;使用 Actor‑Critic 框架;奖励融合块级进度差分 + 稀疏终止奖励;迭代:收集轨迹→更新模型;训练分布逐步贴近真实部署遇到的状态。 - 持续迭代闭环
只要有新 rollout 数据就可以重复执行 “运行‑修正‑更新” 循环。
六、实验部分
6.1 实验设置
真机硬件:①AgileX PiPER/PiPER‑X 双臂机械臂;②自研 Maker H01 人形机器人(头、腰、双臂)。两套硬件自由度、工作空间差异巨大,用于检验跨具身泛化。 对比基线:π₀.₅、GigaBrain‑0.1、Xiaomi‑Robotics‑1、Galaxea G0.5 等。 评测指标:任务成功率、任务得分、完成耗时;区分 ID(分布内)、OOD(分布外泛化,物体、布局、任务未在训练集见过)。
6.2 架构消融实验
- VLM 主干对比
PaliGemma2、Qwen3.5、Gemma4。Gemma4 结构化任务强,但在布料折叠这类复杂操纵任务失败;PaliGemma2‑3B 综合最优,作为后续实验主干。 - VLM 与动作专家耦合方式对比
双流 Dual‑Stream > 多层交叉注意力 > 最后一层交叉注意力。双流 MoT 架构在真实机器人任务综合性能最优,但推理开销更大。
6.3 数据规模缩放实验
-
随着训练数据规模增大,验证损失持续下降;真实机器人任务性能持续提升;复杂任务(衣物折叠)对数据规模高度敏感,简单任务(水果抓取)提升平滑,证明大规模异构预训练带来具身能力涌现。 -
数据源消融:单纯真机数据基础上增加 UMI、EGO 人类演示,性能进一步提升;三者混合效果最好。人类数据提供手眼、第一人称交互先验,和机器人轨迹形成互补。
6.4 时序上下文模块消融
没有时序记忆:遇到视觉高度相似但执行阶段不同的画面,机器人陷入循环重复动作; 开启时空块短时记忆:可以利用历史交互信息消解状态歧义,跳出循环,推进长时序任务。
6.5 System3 预测与评估模块消融
设置 4 组对照:Base(无 System3)、+SubImage(子目标图像)、+Value(价值条件)、+SubImage+Value 全部开启。测试任务:衣物折叠、礼品包装、方块分拣。
-
简单任务(衣物折叠)全部 100% 成功,但开启 System3 后任务得分提升,执行时间缩短;即使成功率饱和,依然提升鲁棒性与效率。 -
高难度礼品包装:Base 完全无法完成;只图像 20% 成功率;只价值 60%;两者组合 80% 成功率。 -
方块分拣:组合版本得分大幅提升。
结论:System3 不只是提升能不能完成任务,还优化中间状态下任务推进效率,增强策略鲁棒性。并且世界模型可以通过 “想象未来” 区分失败轨迹和可恢复轨迹。
6.6 预训练模型零样本评测(不做任务后微调)
分别在 AgileX PiPER、Maker H01 人形机器人评测 ID 与 OOD 任务:
- 语言指令跟随零样本
分布内 ID 任务物体拾取、整理、多步操纵表现良好;分布外 OOD(全新物体、全新空间布局)性能下降,但依然可以完成部分任务;证明大规模异构预训练带来组合泛化,但多重分布偏移下泛化仍是难点。 - 复杂操纵零样本
包括未见过布料的折叠等可变形物体任务。模型不需要记住固定物体形状,复用交互模式完成任务;OOD 复杂操纵仍然具备挑战。
6.7 任务后训练 SFT 评测
在 6 项语言条件操纵任务(颜色区分、目标选择、方向推理)、多项复杂操纵(揉橡皮泥、分拣、清扫、家居整理)上对比基线。
-
AgileX PiPER:GigaBrain‑0.7 平均成功率 91.5% 优于 π₀.₅(88.8%)、前代 GigaBrain‑0.1(76.1%)。 -
Maker H01 人形机器人:平均成功率 84.2%,显著优于基线。 模型可以响应颜色、物体身份、空间关系等细粒度语言指令。
6.8 仿真基准评测
- MiMo‑Embodied 具身 VLM 基准
空间理解、可操作性推理;GigaBrain‑0.7 取得最优总体得分。 - RoboTwin2.0
多任务联合训练,困难域随机化 Hard 集取得 SOTA;抗域迁移能力强。 - EBench(移动操纵、长时序)
总体成功率与任务得分高于 π₀、π₀.₅。 - RoboColiseum
指令跟随、空间推理、鲁棒性、通用操纵四个维度全部开源模型第一。
6.9 经验驱动强化学习实验
选取 4 个高难度真机任务:礼盒包装、轴承装配、连杆安装、扎带穿锁。对比 SFT 基线 → 离线 RL → 在线人在回路 RL 三阶段效果:
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
离线 RL 就可以带来明显提升;进入带人工修正的在线 RL 后四项任务全部达到 100% 成功率。验证 “演示监督 → 离线经验优化 → 在线人在回路修正” 整套闭环链路有效。
七、结论与未来工作
主要贡献总结
-
提出三系统协同架构 GigaBrain‑0.7,把理解规划 (System2)、预测评估 (System3)、动作控制 (System1) 解耦协同;引入 Soft‑KI 软知识隔离机制; -
构建37256 小时大规模多机器人异构具身数据集,开发完整统一数据标准化清洗流水线; -
采用单阶段 VLA 联合预训练;引入独立世界价值模型 System3,输出子目标图像、任务价值信号作为策略条件; -
建立完整四阶段训练链路:预训练‑世界模型预训练‑任务后训练‑离线 + 在线人在回路强化学习,实现持续闭环改进; -
在真机、多套仿真基准实验证明模型在零样本、后训练、闭环强化学习的效果,观察大规模异构数据带来的具身涌现能力。
未来方向
-
继续扩大异构具身数据规模,提升跨数据源对齐质量; -
进一步增强长时序预测、任务进度评估能力; -
推进更少人工干预,完全依靠机器人自主运行经验的闭环持续学习; -
开源全部训练代码与模型权重,推动具身基础模型社区发展。