

⭐ 设为星标 · 第一时间收到推送

这次到底更新了什么
Qwen-Image-2.1 把此前分散的能力装进了同一个模型:普通文生图、单图编辑、多图参考、局部修改、透明图生成和透明图编辑。视觉生成部分是 32 层 Single-Stream DiT、7B 参数,文本和参考图则由 Qwen3-VL 8B 编码。
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
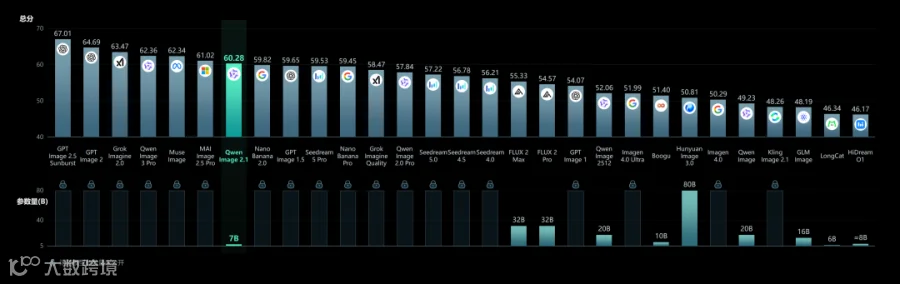
官方在自建的 Qwen-Image-Bench 上给出 60.28 分。这个成绩高于图中的 Nano Banana 2.0、GPT Image 1.5、Seedream 5 Pro 等模型,但低于 GPT Image 2.5、GPT Image 2、Grok Imagine 2.0 和 Qwen Image 3 Pro。它是官方自测,不该直接当成第三方结论。
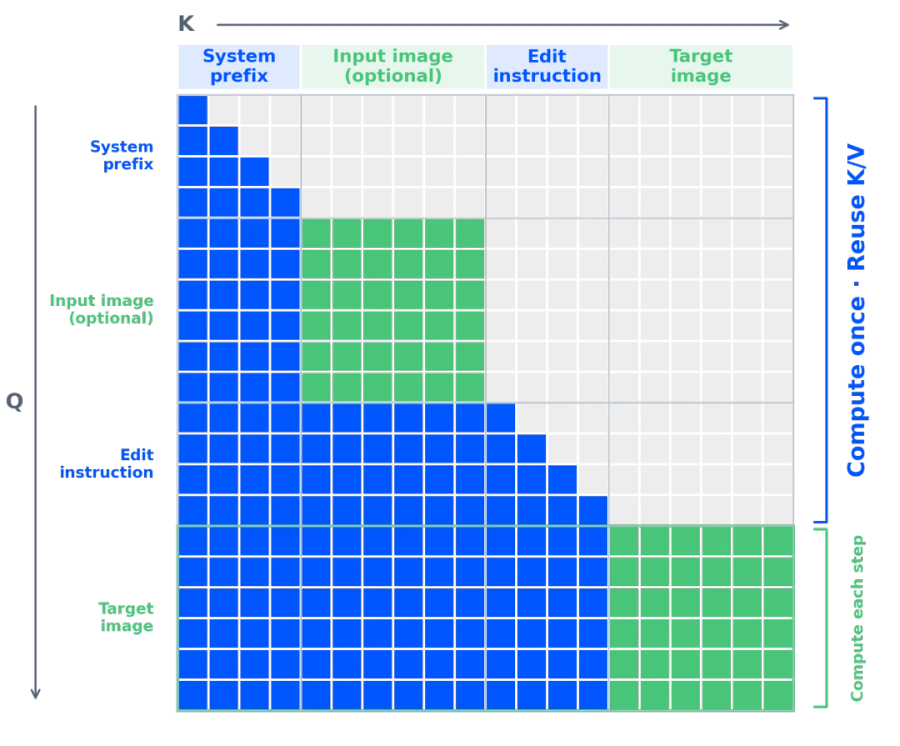
它在多图编辑上提速,靠的是混合粒度注意力和 Prefix KV Cache。文本按 token 做因果遮罩,图片按块处理;参考图和编辑指令在第一步算完后缓存,后续去噪步骤可以复用。
透明图不再需要先生成、再抠图
这次最实用的变化是 原生 RGBA。模型可以直接输出带 Alpha 通道的 PNG,也能继续编辑透明图。做贴纸、商品素材、Logo 元素、视频包装和网页插画时,工作流里少了一次抠图。
官方先给了三组单主体透明素材:玻璃质感、复杂轮廓和插画元素都能直接落在透明背景上。
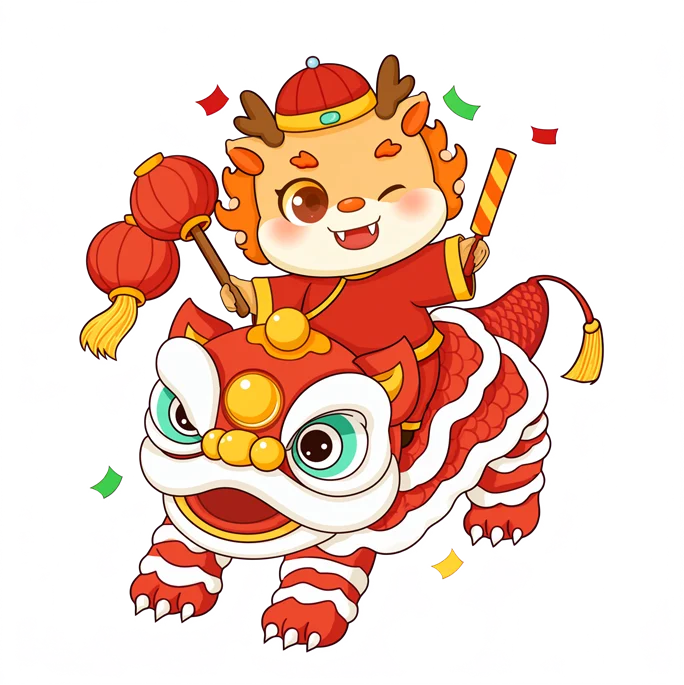
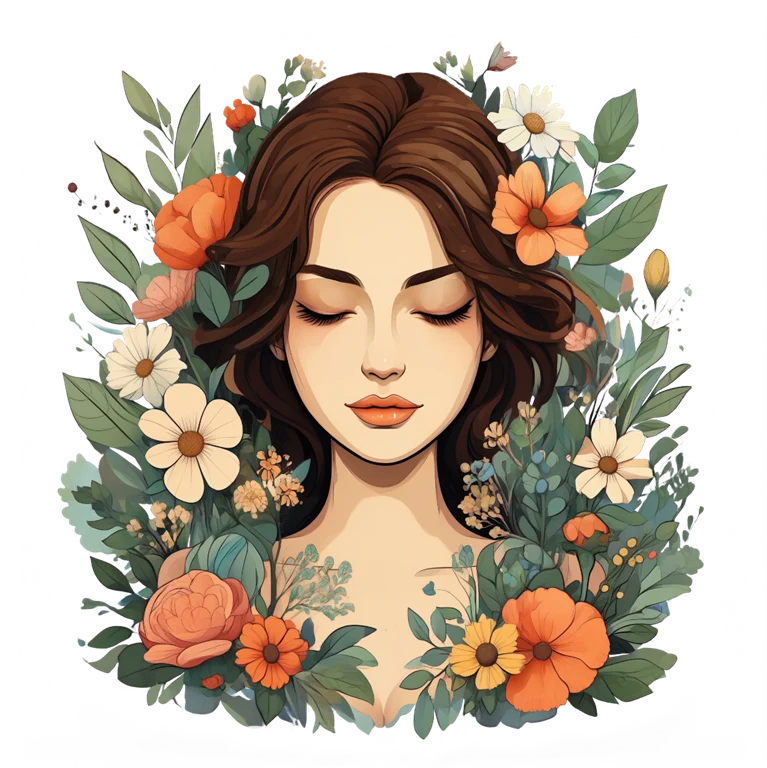
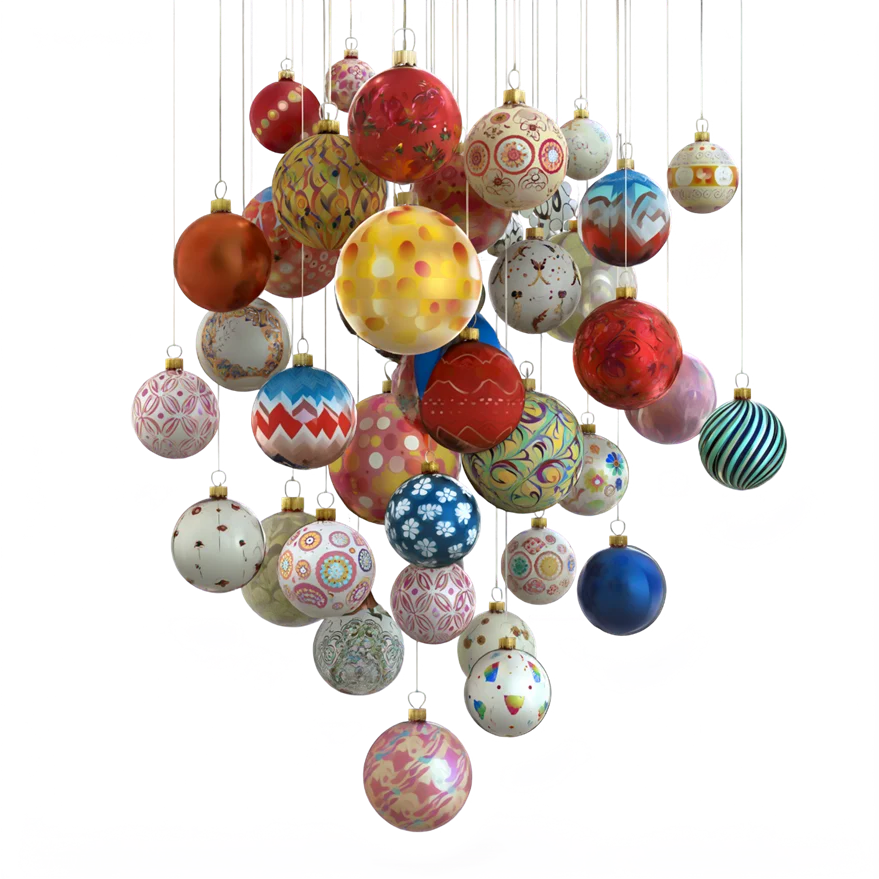
透明图也不只限于孤立物体。下面两组包含多个元素,更接近海报装饰、活动物料和电商组合素材。

生成后还能继续改。下面第一组只改变透明人物的表情,第二组把透明文字层里的 BLOOM 换成 Qwen-Image,背景仍保持透明。
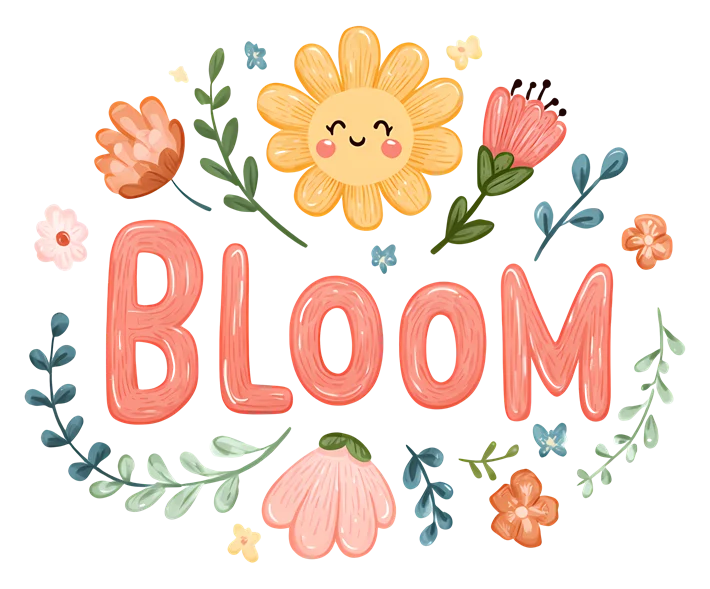
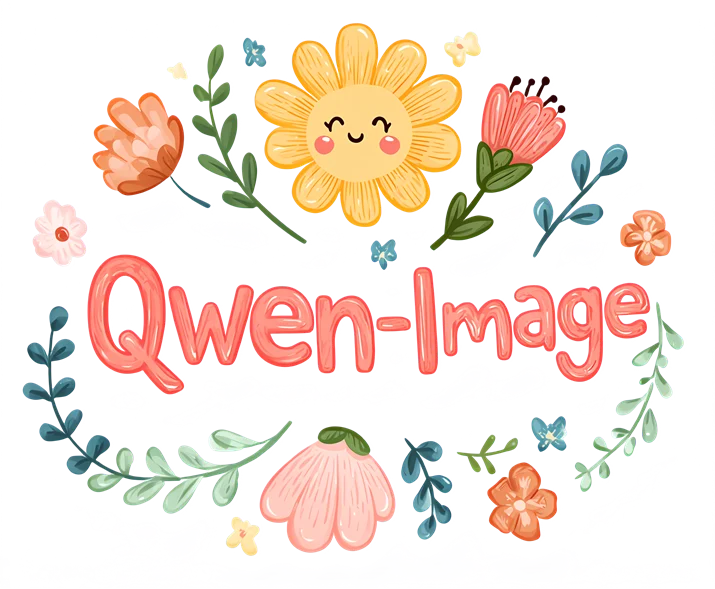
它还能从普通 RGB 照片里抽出主体,直接变成可复用的 RGBA 图层。
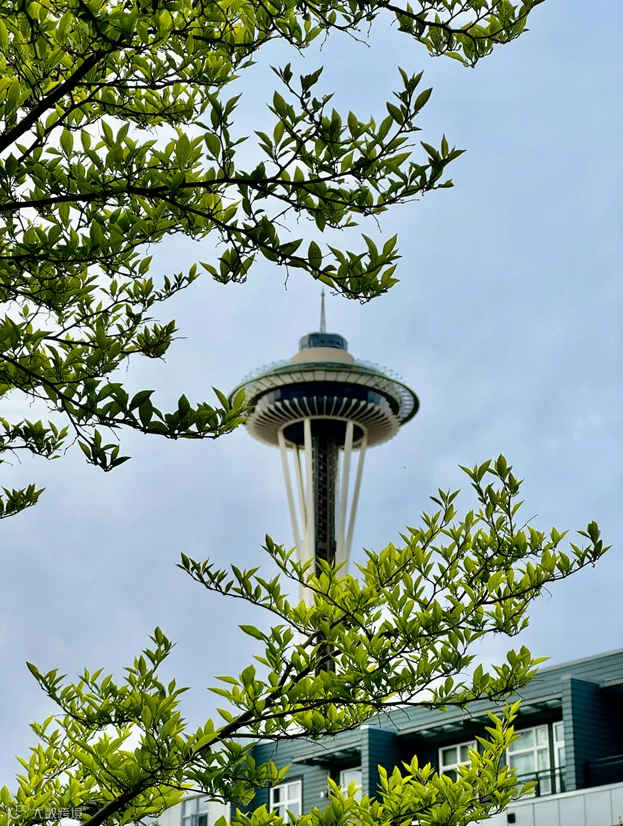
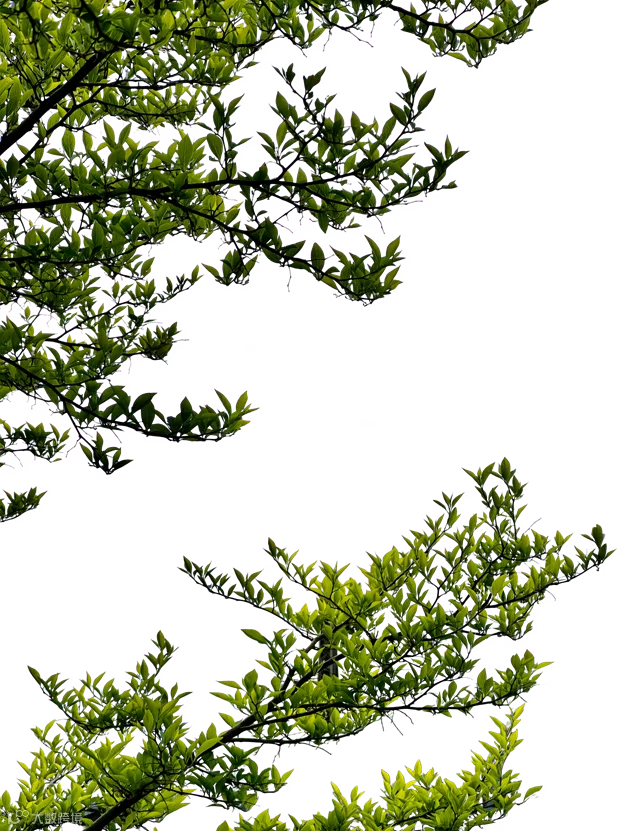
官方推荐的透明图提示词很直接:
💡 PROMPT
Prompt:
This is an RGBA image with transparency. A cute cartoon dragon sticker. The image has alpha channel and the background is transparent.
透明通道的真实难点在发丝、玻璃、塑料袋、毛发和运动模糊边缘。现在公开案例很好看,但生产里还要把同一张结果分别放到黑底和白底上检查,不能只看棋盘格预览。
最多 10 张参考图,人物和商品可以一起锁住
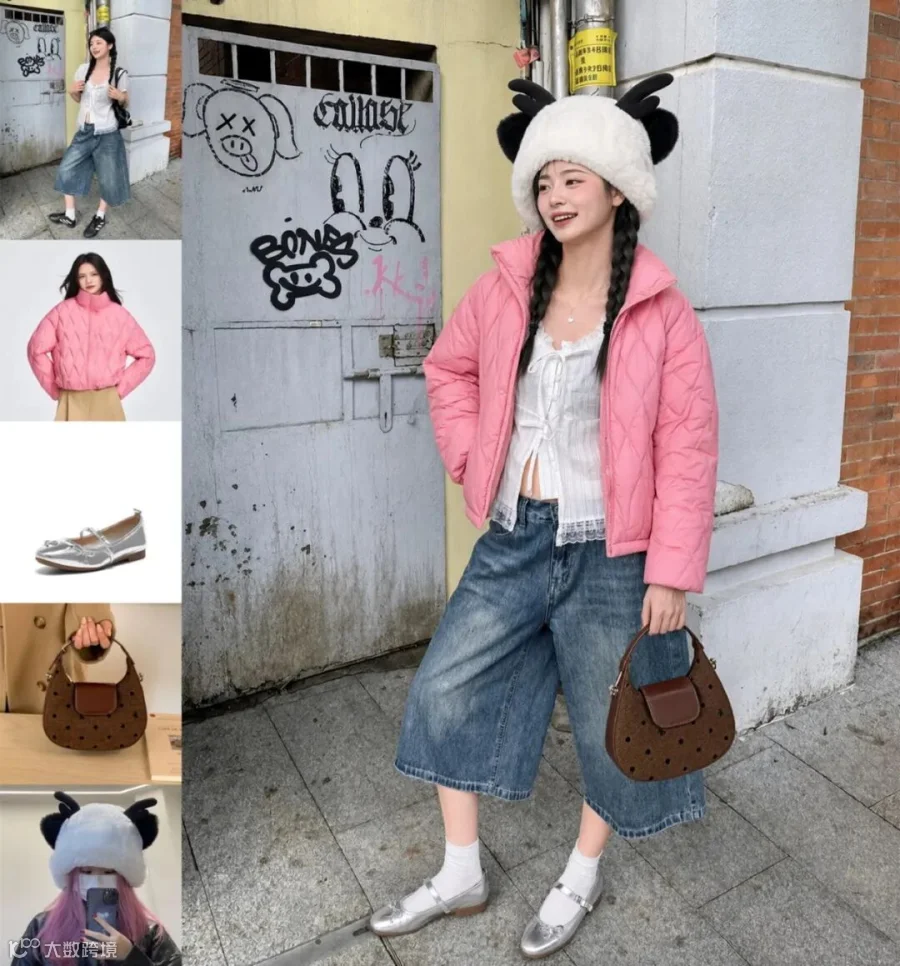
多图参考不是简单拼图。模型要识别人、衣服、鞋、包、帽子和家具各自是什么,再把它们放进同一个场景。
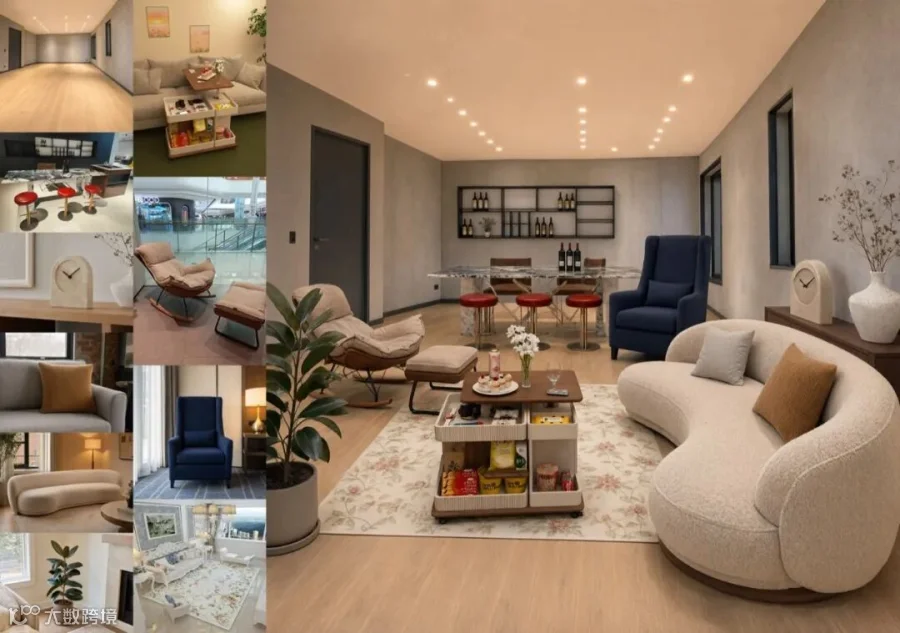
第一组用了 6 张单人照片,合成一张合影;第二组把模特、衣服、鞋、包和帽子 5 个输入组合成完整穿搭;第三组一次参考 10 件家具,生成完整室内空间。
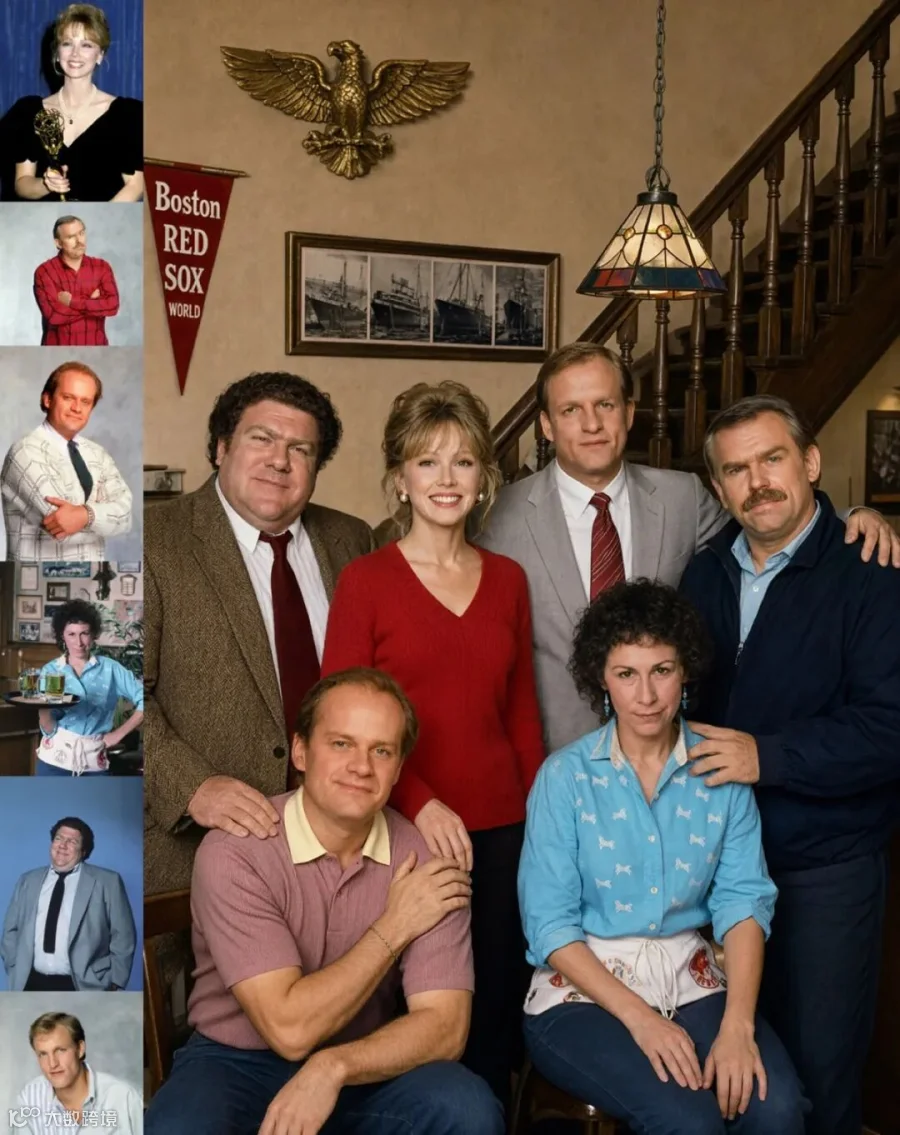
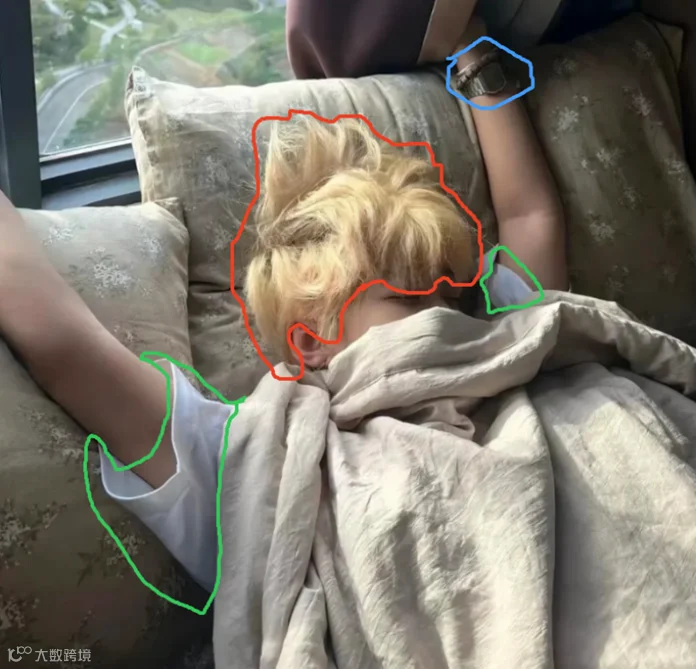
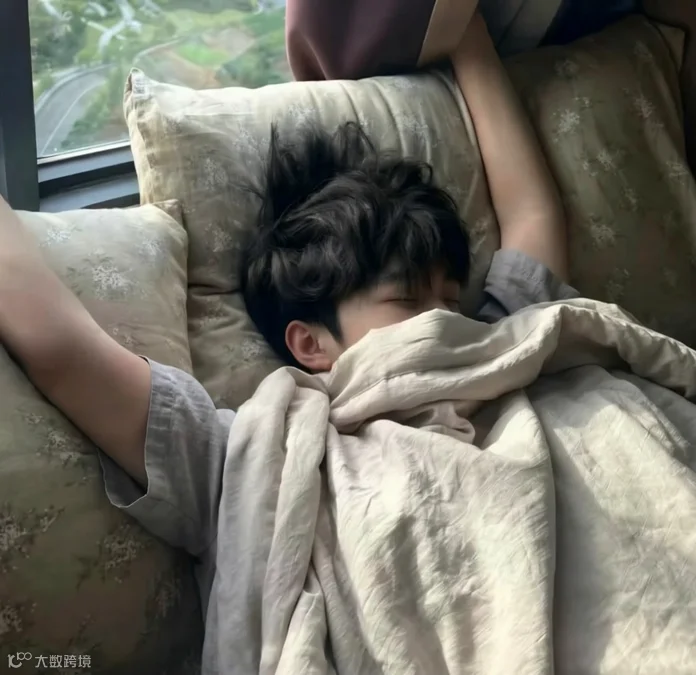
局部编辑支持三种常见标记方式。最直观的是在图上画圈:蓝圈删手表,红圈改黑发,绿圈换成灰色亚麻短袖,一次完成三个区域的修改。
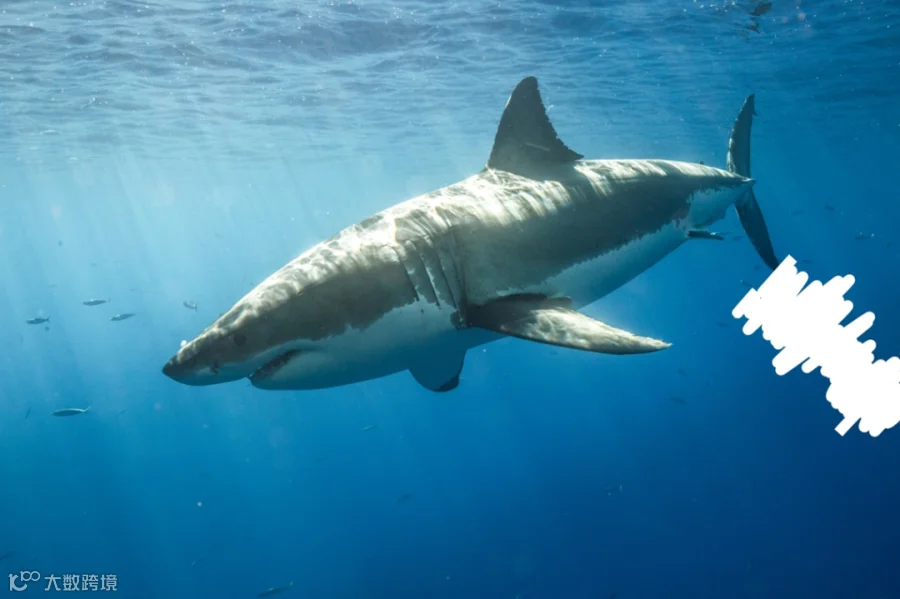
也可以直接涂白要修改的位置。下面这组把潜水员放进指定区域,其余画面尽量不动。

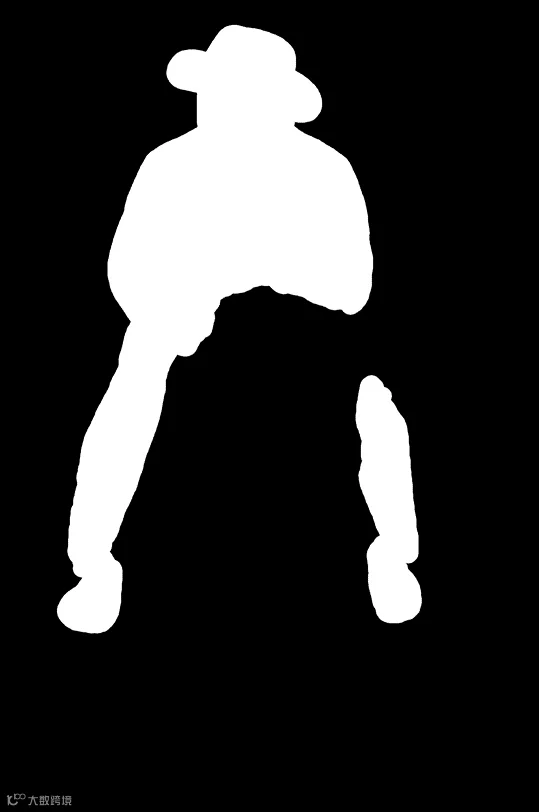
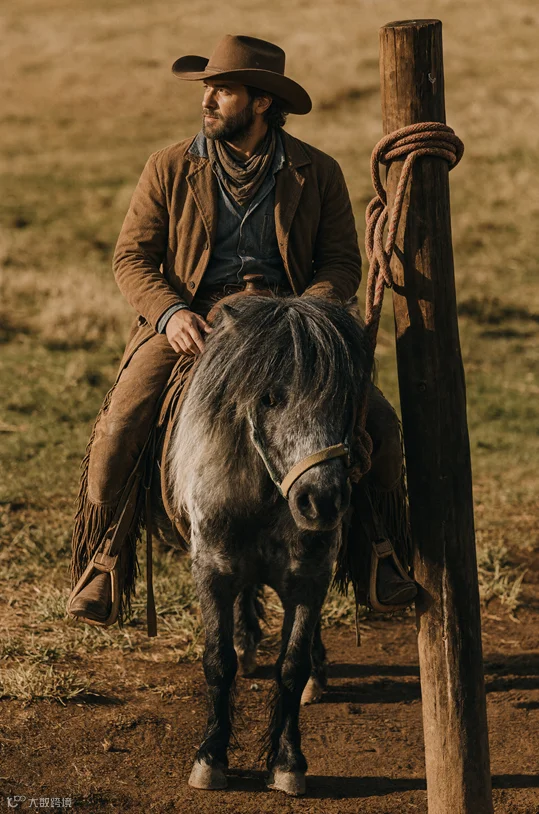
如果不想让标记遮住原图,可以把原图和 Mask 分开输入。模型只改 Mask 覆盖的区域,下面的结果是在草地上补出一名骑马的牛仔。

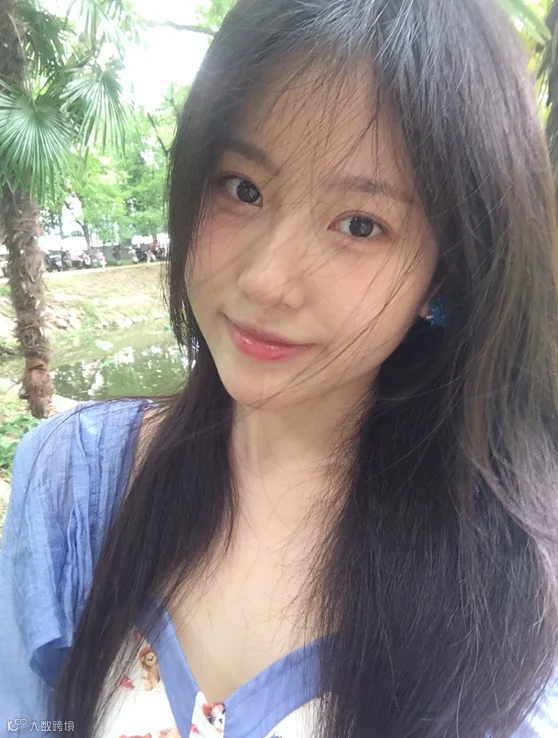
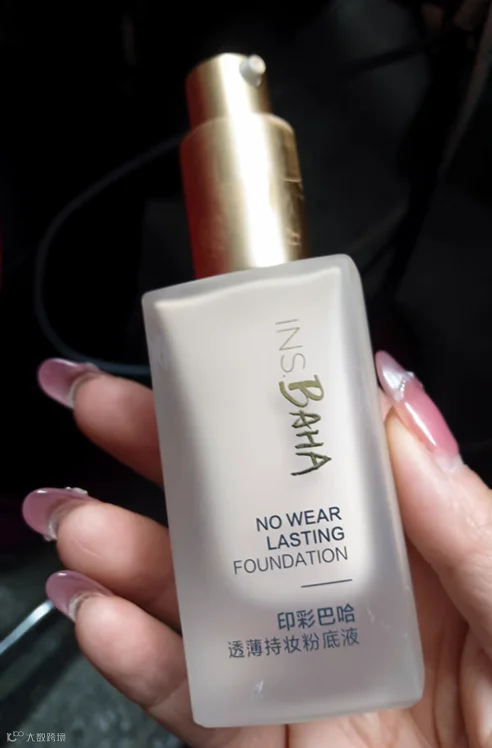
人像和商品编辑最怕主体换了个人,或者包装上的字走样。官方案例里,人脸身份、首饰和服装在换场景后仍较稳定;商品案例则重点保留包装文字、材质和形状。

全景、信息图、分镜和排版,也都塞进来了
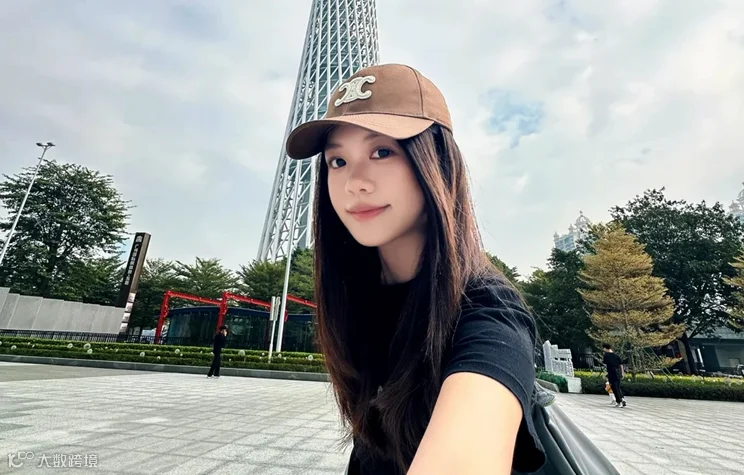
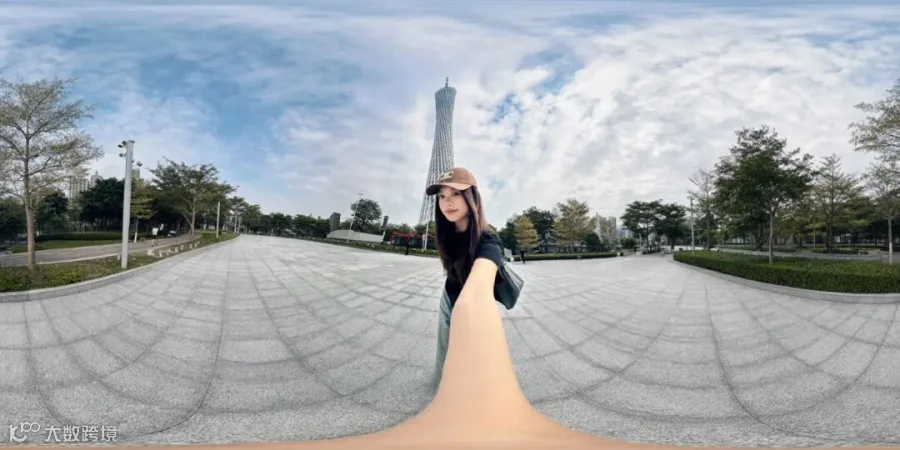
Qwen-Image-2.1 的任务范围比普通文生图更宽。它能从一张自拍推断并生成 360 度全景,下面是输入和展开后的环境。
它也能把一张模特照扩成信息图。版式、中文标签、色卡和局部放大都比较完整,适合做服装、人物或商品说明页。
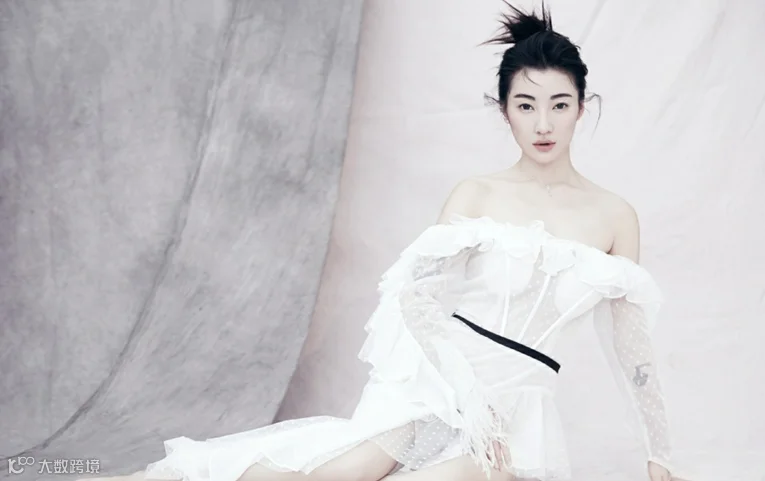
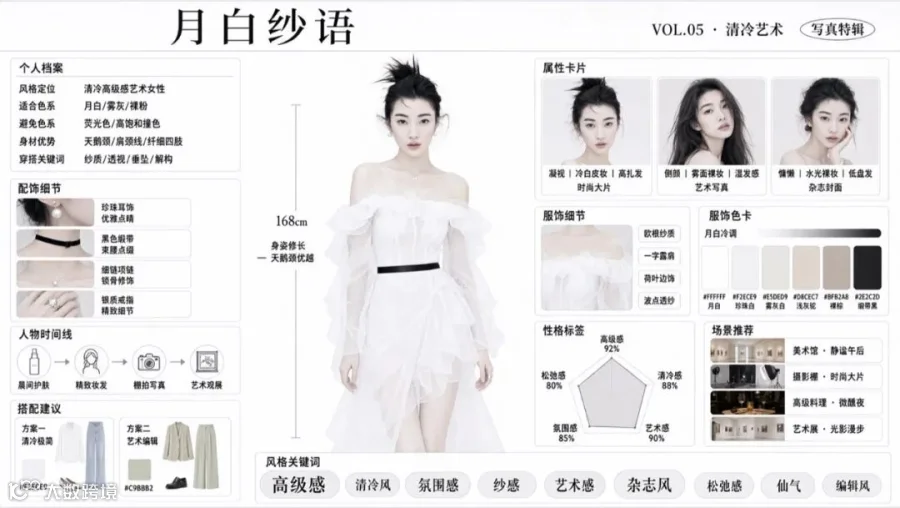
三视图还能继续生成完整分镜。角色服装、发型和配色能在多格画面里延续,这对漫画、动画预演和广告分镜很实用。


文字和版式是它的强项。官方案例覆盖论文示意图、海报、杂志排版和复杂信息图,英文小字的完整度明显高于多数开源图像模型。
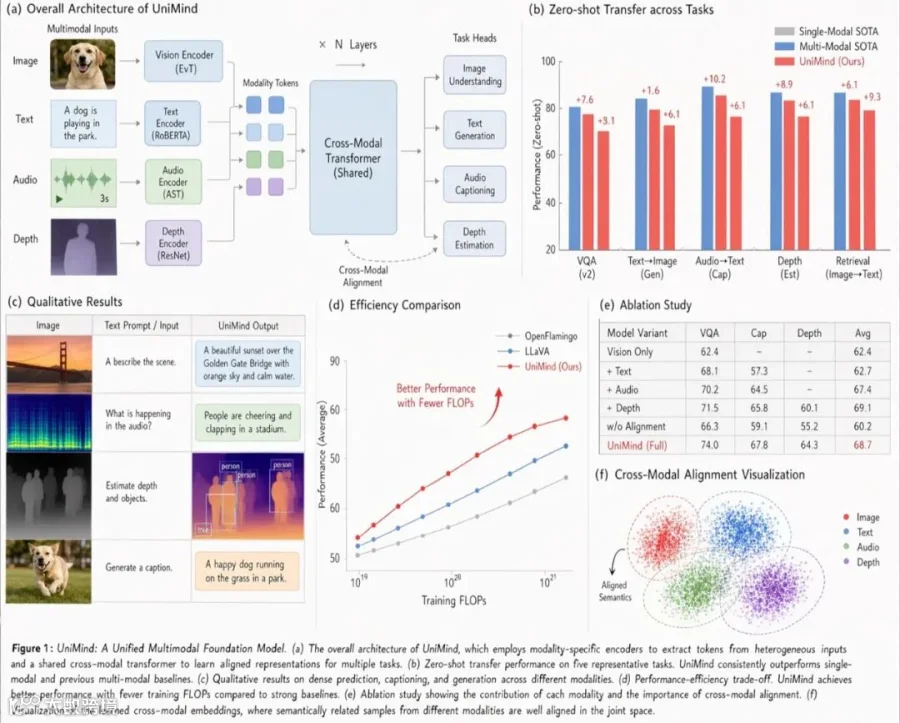
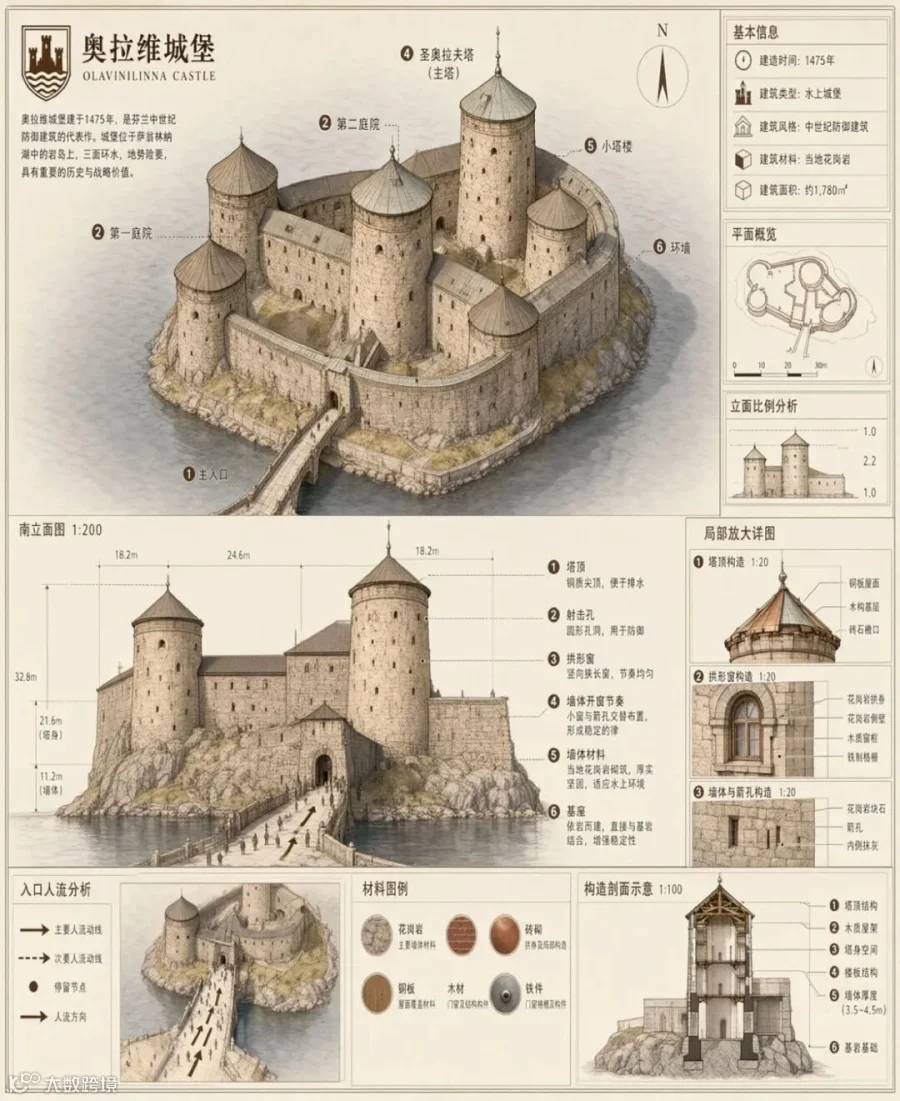
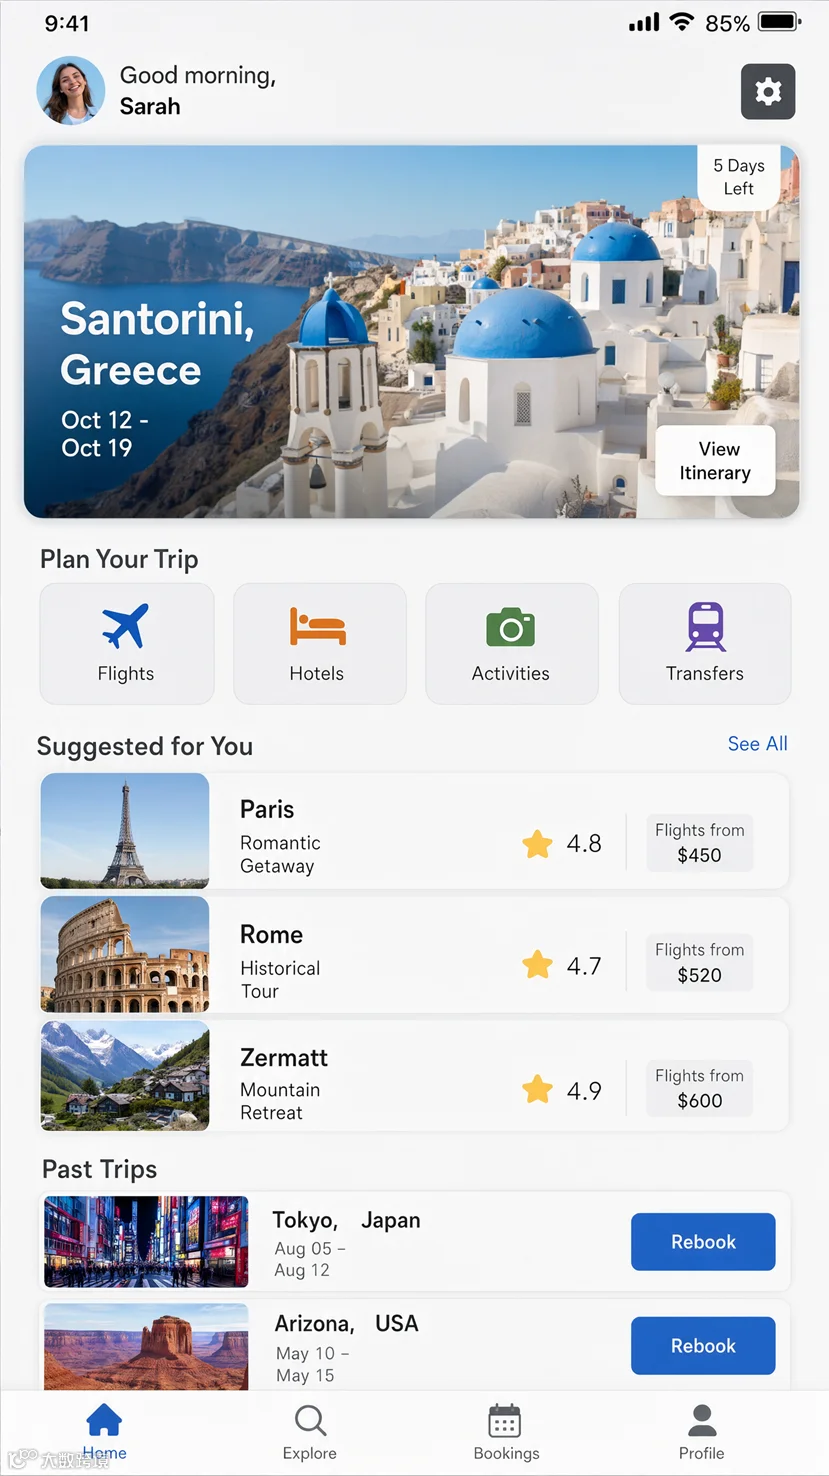
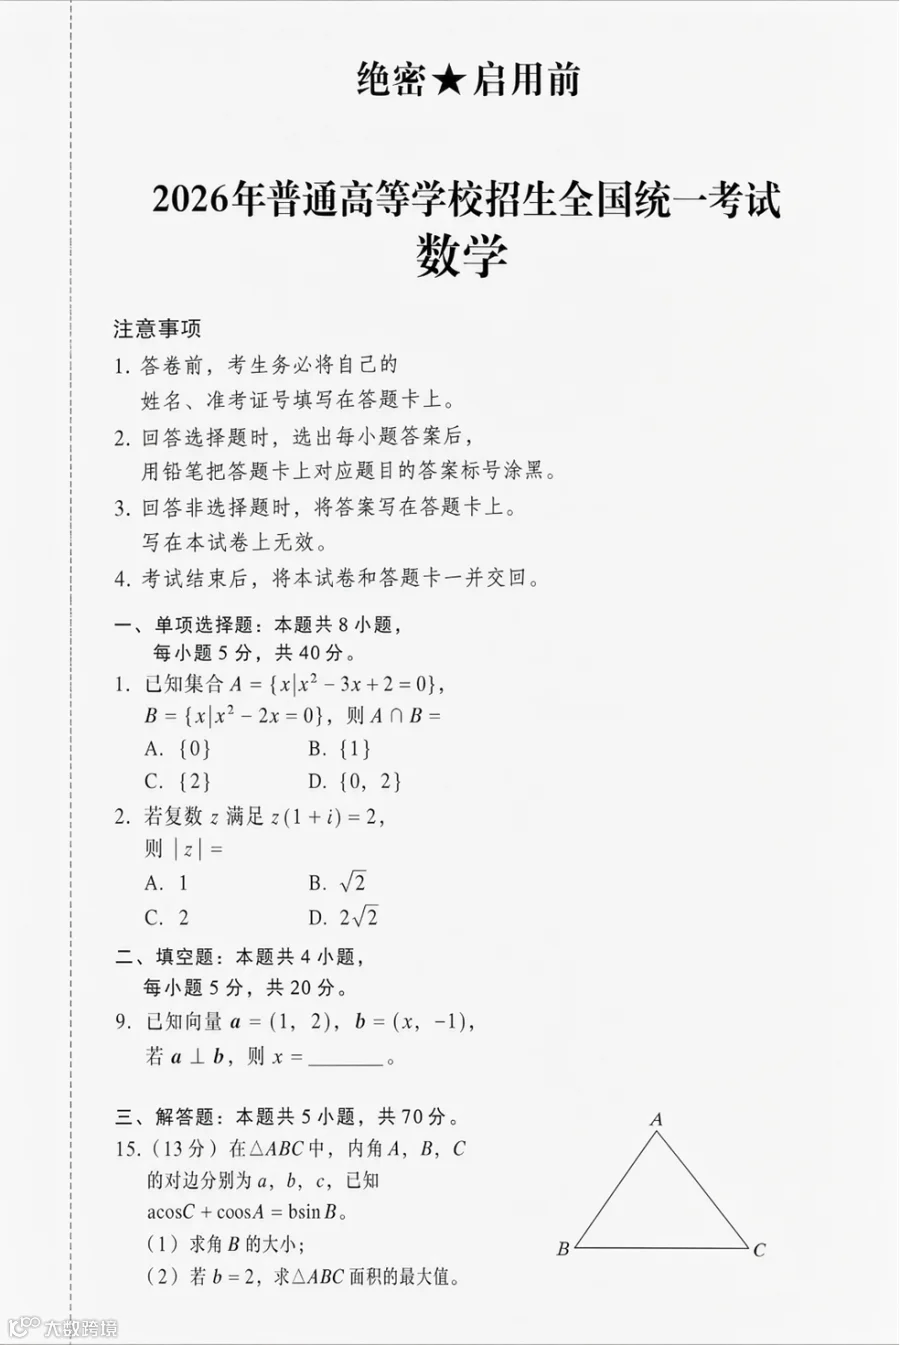
但字看起来像真的,不等于内容是真的。比如论文图里的模型名、指标和结论都必须重新核对。它适合先出视觉草稿,不适合直接生成要公开引用的数据图。
人像质感也做了增强,尤其是光线、皮肤和细节。不过这类官方精选图只能证明上限,不能代表每个提示词都能稳定复现。
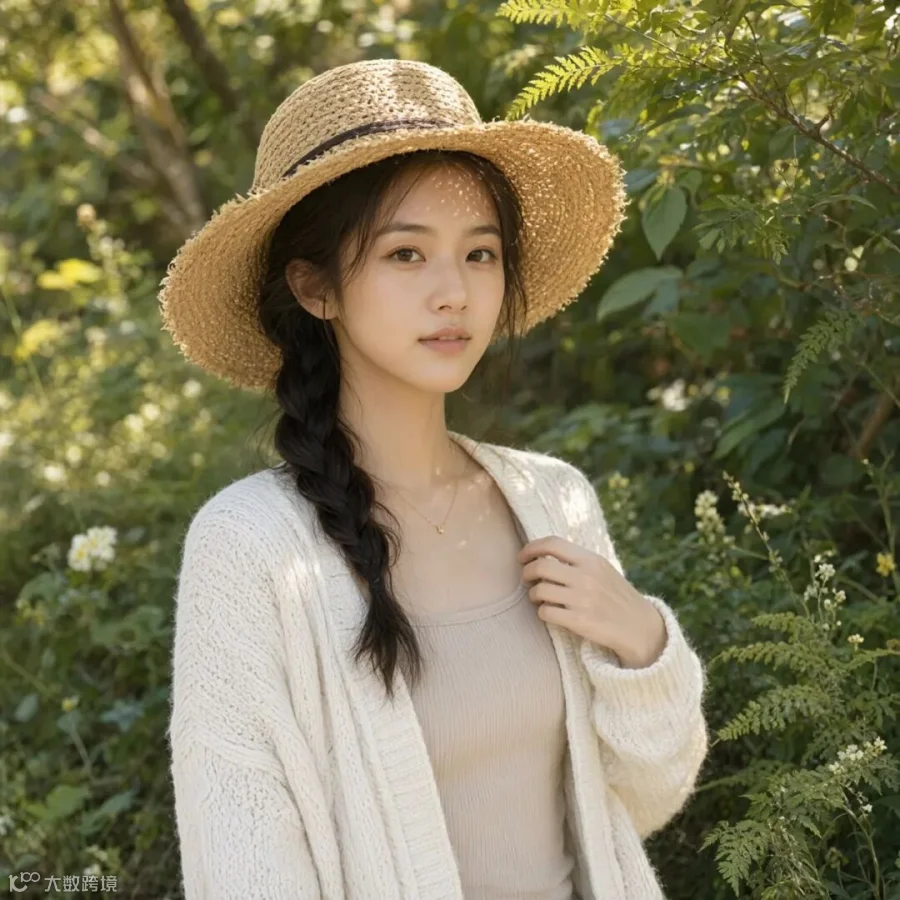
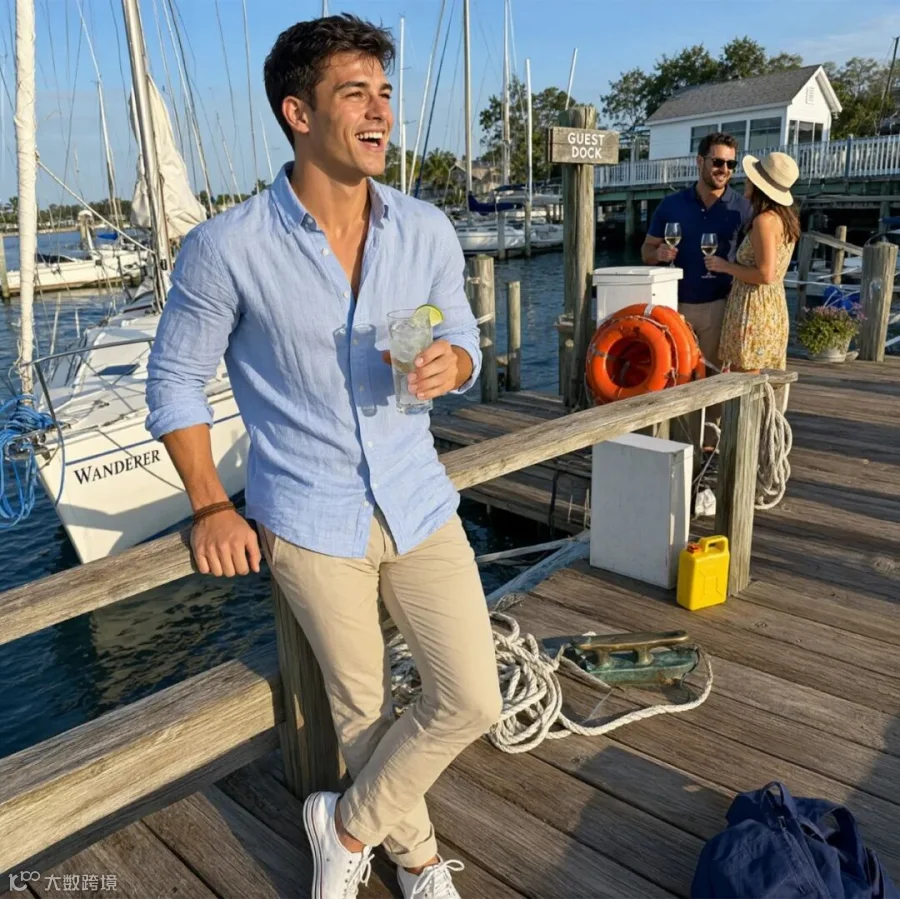
本地能跑,但 7B 不等于只占 7B
官方已经给出 Diffusers 和 ComfyUI 工作流,vLLM-Omni、SGLang、LightX2V 也在发布当天适配。原生推荐尺寸从 2048×2048 的 1:1,到 2752×1536 的 16:9、1536×2752 的 9:16,默认 40 步。
7B 只指视觉生成 Transformer。 Hugging Face 上的 BF16 文件还包括约 17.5GB 的文本编码器和约 1.35GB 的 VAE,整套权重约 33.1GB。显存不够时可以用 CPU offload、量化或多卡并行,但速度、文字质量和细节都会受配置影响。
一位开发者在 RTX 5070 Ti 上做了 4 组编辑测试,单张约 33.6 到 36.9 秒,显存约 12.4GiB;换文字、换水果和改颜色都成功。不过他没有在同一条帖子里完整公开量化与分辨率设置,这组数字更适合当早期参考。
负面反馈也很具体。另一位重度测试者认为,文字渲染是开源模型里最强的一档,但人物、风景和艺术图容易出现十字纹理;复杂姿势下,手臂、腿、手指和脚趾仍会出错。透明图的发丝、玻璃和半透明边缘,也需要更多独立测试。
还有一个容易被开源二字盖住的限制:仓库使用 Qwen Research License。权重可以用于非商业研究和评估,商业使用要向 Qwen 单独申请授权。公司项目、收费服务和客户交付,不能把能下载直接理解成可商用。
如果你的工作是设计素材、电商图、角色设定、信息图或本地图片编辑,Qwen-Image-2.1 已经很值得试,尤其是透明图、多参考图和文字排版。要做商业上线或高精度人物成片,先解决许可证,再用自己的素材测试透明边缘、人体结构和量化后的文字质量。