各位宽客(Quant)朋友们,大家好。
大语言模型(LLM)与多智能体(Multi-Agent)正在拓展量化研究的边界。从生成因子到分析回测,越来越多的工作可以由 Agent 协作完成。但让几个智能体自由对话、修改报错,并不意味着已经建立了一套可靠的研究流程。未来数据泄露、反馈链路不清、评估标准受到污染,都可能让漂亮的回测结果在样本外失去说服力。
对于量化研究,结果要经得起检验,产生结果的过程同样需要有据可查。
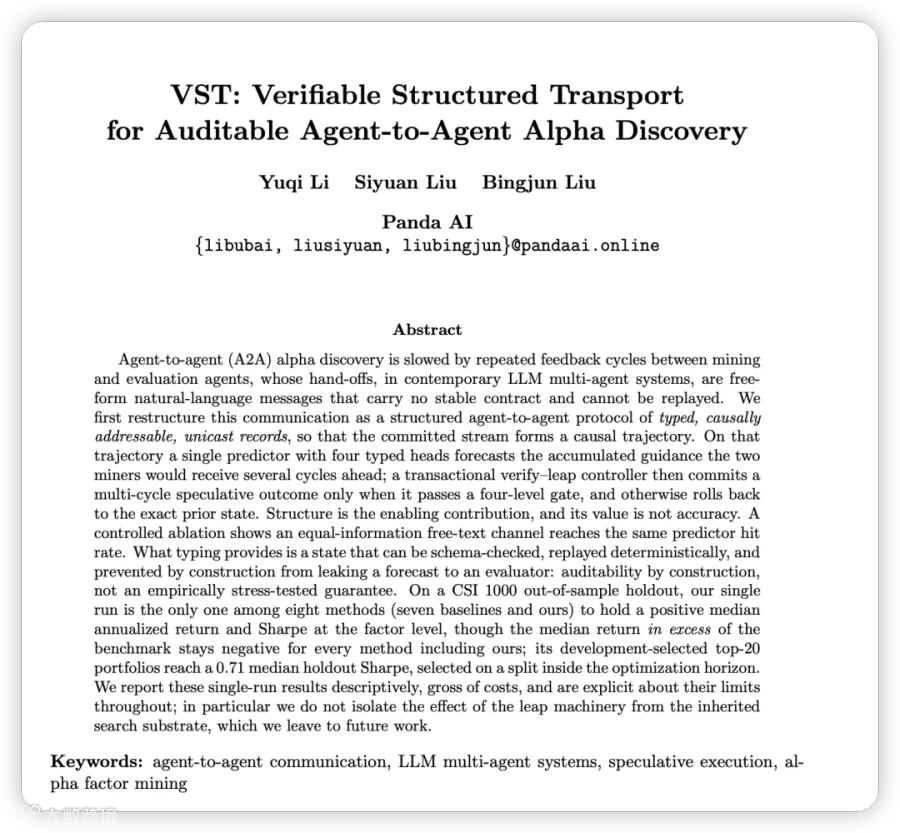
PandaAI 团队提出的可验证结构化传输框架 VST(Verifiable Structured Transport),正是从多智能体的通信层入手,引入结构化协议、推测性执行与事务回滚(Rollback),探索如何让 AI 因子研究具备更清晰的交互记录、更独立的评估机制和可验证的推进过程。
下面,我们从研究动机、核心方法、样本外表现和实践启发四个方面,解读这项工作。
💡 一句话导读
给多智能体量化研究装上“可验证的通信总线”:PandaAI VST 以结构化交互和提交/回滚机制改造研究流程,在中证1000实验中,经开发数据筛选的 Top-20 组合取得样本外夏普中位数 0.71、费前年化收益中位数 13.3%。
Title: VST: Verifiable Structured Transport for Auditable Agent-to-Agent Alpha Discovery
Authors: Yuqi Li、Siyuan Liu、Bingjun Liu(Panda AI)
Source: https://arxiv.org/abs/2609.07065v1
研究主题:多智能体通信、推测性执行、可审计因子发现
核心亮点(Key Takeaways)
多智能体因子研究的一种典型架构是“双循环演化”:因子挖掘侧提出候选公式,评估优化侧探索指标与组合配置,再通过报告反馈推动下一轮迭代。VST 在这一已有架构上,进一步改造智能体之间的通信机制。
这类研究流水线面临两个关键问题:
为此,VST 将智能体交互封装为带版本、路由及事务归属的结构化数据包,并限制预测信息进入评估端,为后续验证和追溯建立基础。
VST 将数据库事务(Transaction)的提交/回滚思想引入多智能体研究,并通过推测性执行尝试减少反复往返的反馈周期。
底层回测范围: 中证1000(CSI 1000)。
核心架构 1:VST 三层通信协议
每次 Agent 交互都被封装为三层结构: 信封层(Envelope): 记录消息身份、接收方、路由与因果关系。 负载层(Body): 承载因子公式、参数、指导或分析报告等业务内容。溯源层(Provenance): 标记事务归属,以及消息处于推测还是已提交状态。 这使系统能够明确每条消息的来路、去向和状态,为研究轨迹的回放与审计提供依据。
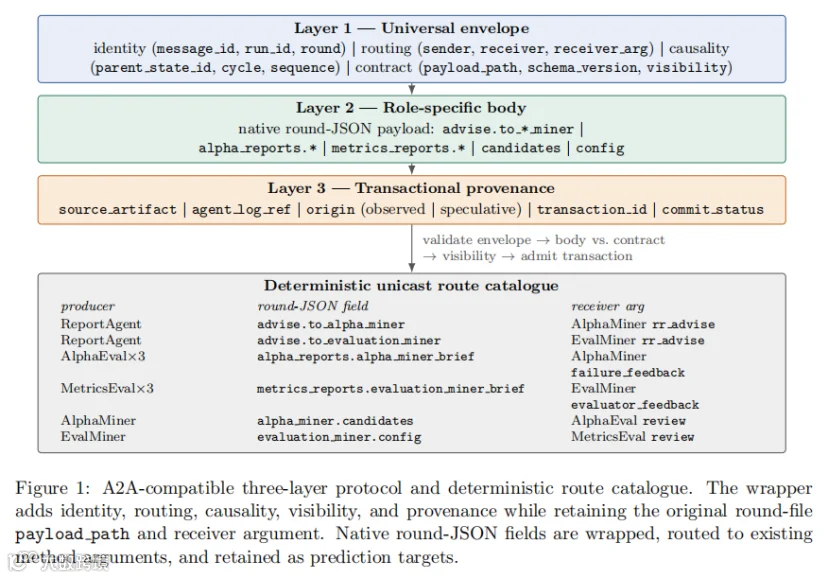
Figure 1 · 三层通信协议与确定性路由
核心架构 2:四层验证门(Four-Level Validation Gate)
系统根据已确认的交互轨迹,预测未来几轮挖掘智能体可能收到的累积指导,再进行推测性执行。执行结果必须通过四层验证:
L1|数据包合法性: 检查格式与契约是否符合要求。
L2|跨循环一致性: 检查因子挖掘与评估优化两侧的状态是否一致。
L3|盲态评估风险: 由不接收预测信息的评估器分析真实执行结果。
L4|开发集实证质量: 检查结果是否满足实证质量要求。 四层全部通过,才提交整个事务;任何一层未通过,就回滚到此前确认的状态。预测因此成为一次待验证的研究尝试,系统仍以真实执行与检验结果决定是否前进。
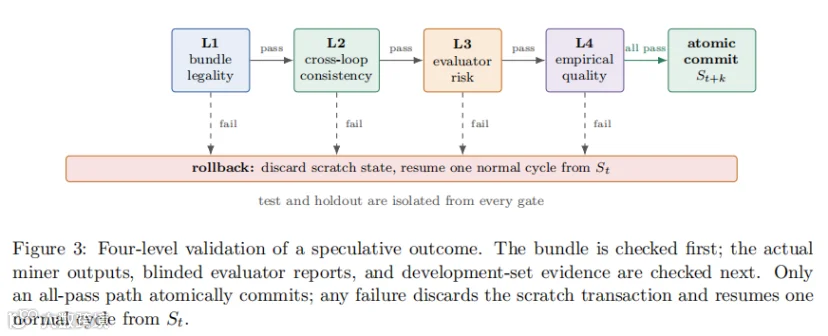
Figure 3 · 四层验证与提交/回滚
核心架构 3:技能库解耦(Skill Separation)
预测器与评估器使用分离的技能演化机制:预测器从提交和回滚结果中学习,评估器基于真实执行结果更新评价规则。 配合通信层的可见性约束,这项设计旨在避免预测器“教会”评估器迎合自己的预测,在持续进化中保持评估独立性。
论文将 VST 系统与 Alpha101、遗传规划(GP)、DSO、AlphaGen 等七种基线进行比较。因子层面对比采用统一回测口径,按挖掘顺序累计有效因子,共同预算上限为500个。
1. Holdout:因子层面保持正收益
在这一比较口径下,VST 系统在独立 Holdout 区间的表现为: 年化收益中位数:+5.9%。 夏普比率中位数:+0.346。 其余七种基线的对应中位数均为负。VST 系统在本次实验中展现了更好的样本外抗衰减能力,这是研究结果中值得关注的亮点。
原表关键列 · Holdout 中位数
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
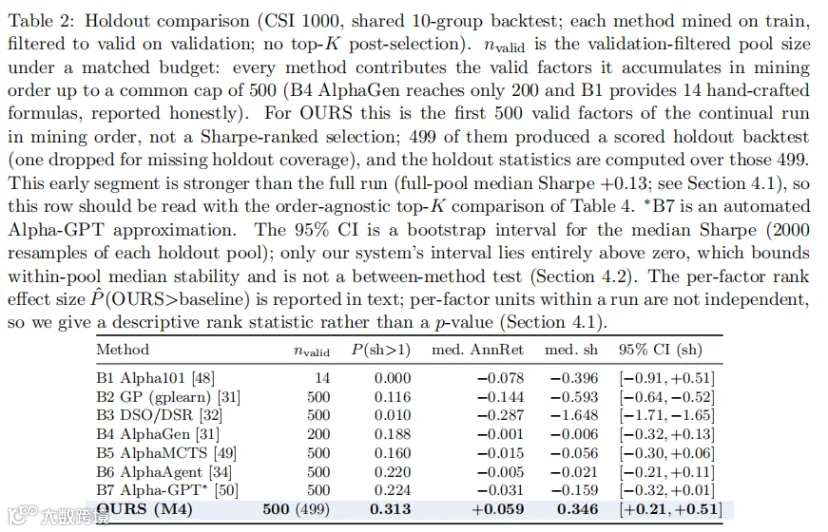
Table 2 · 同预算 Holdout 比较(原表)
2. 头部组合表现(Portfolio-Level)
研究在开发数据上对组合排序,选取 Top-20,再观察它们在未参与筛选的 Holdout 区间中的表现: 夏普比率中位数:+0.71;年化收益中位数:+13.3%;正收益组合占比:80%。 这一结果展示了系统结合开发数据筛选、形成有效组合的潜力。上述数据来自论文单次运行,收益均为费前口径。
原表关键列 · Holdout 中位数
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
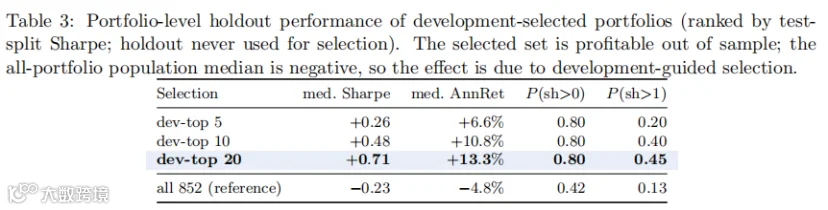
Table 3 · 开发集筛选组合的 Holdout 表现(原表)
3. IC 与 Sharpe 的非对称性
一个值得注意的现象是:VST 系统的 Holdout IC(信息系数)中位数为 +0.028,低于部分基线,但夏普、年化收益和 IR(信息比率)在比较中表现更好。 这一观察提示,评价因子的研究价值,需要同时考虑预测相关性、样本外收益与风险调整后的表现。单一 IC 指标不能完整反映因子进入组合后的效果,样本外表现的保留程度同样重要。
🔥 落地价值:将研究流程治理纳入系统设计
13.3%的费前年化收益提供了直观的成果展示,VST 的研究流程治理(Research Pipeline Governance)思路则具有更广泛的借鉴意义。 通过提交/回滚(Commit/Rollback)与因果追踪机制,量化团队可以逐步追查:一个因子为何被保留,一次推测为何被拒绝,哪些反馈进入了后续研究。这让自动化研究在不断产生结果的同时,积累可供复盘和审计的过程记录。
⚠️ 局限与实践判断
对于正在用大模型或多智能体构建因子研究流程的团队,VST 提供了具体的架构参考:让通信有契约,让推测有验证,让失败可回滚,让评估保持独立。 欢迎阅读论文原文,了解三层通信协议、四层验证机制与完整实验结果。 本文基于 PandaAI 团队论文及作者解读整理。实验数据为研究回测结果,不代表实盘表现,不构成投资建议。
前往官网 · 查看论文 ↗www.pandaaiquant.com/blog