今年 7 月,OpenAI 发布 GPT-Live,将 AI 交互从“回合制”推向真正的实时全双工对话。模型不仅具备拟真音色,更支持随时打断与静默倾听,复杂任务可异步交由后台处理。数据显示,每周已有超 1.5 亿人通过语音功能与 ChatGPT 互动。
这一变革显著提升了人机互动的时长与频率。当交互形式从语音(Voice)进阶至视频(Video),AI 不仅要“听”,更要持续“看”。用户的表情、手势乃至视线转移等非语言信息,正成为人机交流的关键组成部分。
9 月 18 日,成立不足四个月的形界智能(Frame-X)正式发布 Genesis-1.0,并开放 24 小时 AI 直播体验。该产品定位为面向 AI 社交、陪伴及互动娱乐的视频双工模型。
相较于 7 月在 WAIC 亮相的初代版本,Genesis-1.0 展现了更强的产品化能力:支持连续生成超 24 小时,画面行为响应平均仅 1.5 秒(最快 1.2 秒),支持全身动作,调用成本低至每秒 0.003 美元。在当前实时 Avatar 市场中,这一参数极具竞争力,远超 Runway Characters 及 HeyGen LiveAvatar 等产品的会话时长限制。
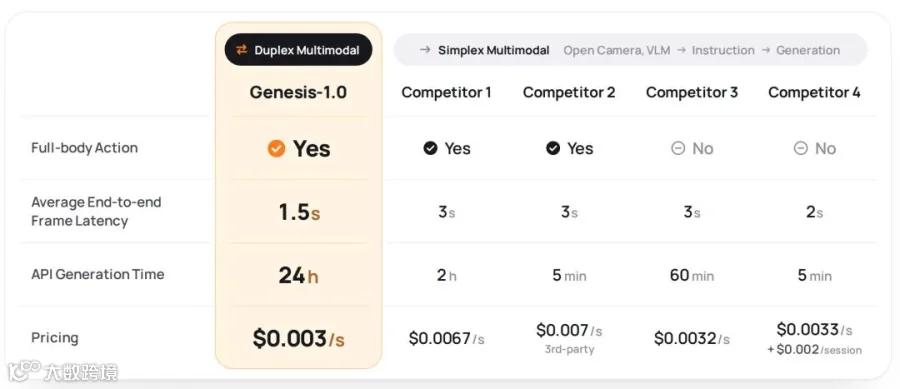
图片来源:Frame-X
然而,24 小时与 1.5 秒并非 Genesis-1.0 的核心叙事。形界智能认为,社交型 AI 角色需具备两大基本能力:一是“一直在”,即长期维持稳定的角色与世界状态;二是“看得到”,即持续读取用户的表情、动作及沉默等非语言信号。唯有如此,视频才能从单纯的输出通道,转变为类人感行为交互的双向载体。
长时一致性大考:24 小时不宕机背后的“世界维持”能力
传统 AI 视频多为有终点的离散内容,而实时交互视频 akin to 无剧本直播,需根据用户实时输入持续演算。这带来了严峻的“误差累积”挑战:在自回归(Auto-Regressive)生成模式下,微小偏差若未及时纠正,将导致人物五官变形、衣物漂移甚至空间结构失真。
因此,长时生成的关键在于画面一致性——模型必须在长时间运行后,仍能准确认知世界的确切状态。Genesis-1.0 针对此进行了专项优化,将业界普遍的五分钟级互动时长,提升至稳定的 24 小时。

图片来源:Frame-X
24 小时实测本质上是一次压力测试,旨在验证模型在成千上万轮生成后,能否正确继承角色身份、场景结构及历史状态。这与大语言模型的长上下文能力逻辑相似:关键不在于“读得更长”,而在于历经大量历史信息后,仍能精准提取与当前相关的状态。
解决该问题目前主要有两种技术路线:一是 3D/Spatial 路线,通过显式结构化系统维护世界状态,视频模型仅作渲染;二是形界智能押注的路线——让视频模型自身学习并维护世界状态。
形界智能主张将人物身份、空间关系及历史变化直接沉淀于模型的视频表征中。基于更彻底的 Scaling 假设,随着模型与数据规模扩大,模型能在同一表征中吸收更复杂的世界知识,避免外部状态系统随复杂度无限膨胀。尽管 3D 路线在特定场景仍有优势,但 Genesis-1.0 标志着互动视频已从“不断生成下一段内容”迈向“持续维护运行状态”的新阶段。
告别“套皮数字人”,端到端行为推理创造真正的“类人感”
长时稳定仅是地基。若角色虽能存在 24 小时却对用户举动毫无察觉,便只是一张动态壁纸。过往数字人虽在外观上日益逼真,但在交流中常因无法理解未说出口的动作或时机而显露割裂感。
真实的人际交流是持续的反馈回路。Genesis-1.0 强调的“类人交互”,要求模型不仅能感知视觉信息,还需结合交互历史进行“端到端行为推理”。这意味着模型从“被动执行指令”转向“根据场景主动选择行为”。
视频来源:Frame-X
例如,当用户用手势比出数字并提问时,模型需同时处理视觉识别与语义理解,而非单纯跟随动作。这种能力类似 GPT-Live 在语音交互中的突破:通过停顿、简短回应等行为细节,营造真实的对话感。而在视频模态下,眼神、表情及肢体姿态构成了更高维度的非语言互动。
8 月,形界智能联合中国科学技术大学等机构提出 SemComp-Bench,引入 Outcome Achievement 和 Generation Reliability 指标,不再单纯关注画质,而是评价模型是否理解语义并做出正确行为。Genesis-1.0 旨在构建一个能完成“倾听、思考、反馈、表达”完整闭环的智能体,而非仅是一个逼真的 Avatar。
1.5 秒背后,AI 的“反应”和“思考”开始被拆开
类人感的另一前提是速度。真实社交的自然感很大程度上取决于 Timing(时机)。Genesis-1.0 延续了形界此前 Rise 模型的低延迟思路,将画面行为平均响应时间压缩至 1.5 秒。
其核心架构创新在于将“反应”与“思考”拆解至不同时间尺度:模型主体负责低延迟的感知与动作生成,维持即时在场感;而 Genesis-1.0-Brain 则异步处理问答内容、语言风格及 MCP 工具调用等高层规划。这种分层设计与 GPT-Live 异曲同工,解决了“人要求即时反馈”与“智能需要计算时间”的矛盾。
图片来源:Frame-X
在实时交互时代,即使 AI 正在进行复杂推理,也不能在关系层面“消失”。对于视频而言,这意味着在思考间隙,仍需通过眼神、微表情保持“在场”状态。这种设计比单纯压低延迟更具实际意义。
从文件到软件,视频会成为下一代人与 AI 的交互界面
传统视频模型交付的是静态内容,而 Genesis-1.0 的野心在于构建长期在线、动态更新的虚拟角色。形界智能试图将“持续在场、敏锐感知、即时回应”沉淀为可复用的底层基础设施,应用场景涵盖社交陪伴、直播、游戏 NPC 及互动娱乐等领域。
当模型能直接根据交互决定下一刻行为时,开发者获得的不再是简单的视频生成 API,而是一套“模型即产品”的全新内容生产方式。商业落地的关键在于验证长时在线的稳定性、响应速度以及经济可行性。
社交场景因对感知与反馈要求最为完整,成为检验该技术的首选战场。Genesis-1.0 通过同时解决时长、行为、响应和成本四大指标,展示了务实的产品化路径。
更深层次看,Genesis-1.0 押注的是一种新的交互范式:视频不再是 AI 生成的一次性结果,而是人与 AI 之间持续发生的交互本身。未来的竞争力或许不在于生成的终点,而在于“不再轻易结束”——无论用户何时接入,AI 都在那里。