

AI 必须会聊天?
不聊天,也能干活
Jev 来了
TypeSafe AI · System One Model · 早期访问
产品深度评测
📦 5 Parts + Conclusion
👉 滑动
PART 01
它到底是个什么
System One 概念
PART 02
一个端点
Choice / Score / Noul
PART 03
置信度
Confidence 才是卖点
PART 04
价格速度玩家
Vercel / Browser Use
PART 05
冷静看缺点
没开源 / 自评基准
PART ///
写在最后
要不要试水
先说结论
9 月 19 号,TypeSafe AI 发了个不聊天的模型 Jev
它不跟你聊天。你发一段「状态」加几个「结构化问题」,它直接给你带概率的答案,代码可以直接拿来用。
它不是 AGI 时刻,但可能是AI Agent 时代的拼图。
01
PART
它到底是个什么东西
WHAT · SYSTEM ONE MODEL
TypeSafe 把 Jev 叫做System One Model。这词借自 Kahneman 的双系统理论:System 1 是快思考,System 2 是慢思考。
传统的大模型走的是 System 2:先用 RLHF 调教出人类的偏好,输出能聊天的文本。但聊天模型有两个老毛病,过度自信和mode dropping(忽略掉一些合理但小众的选项)。TypeSafe 的观点是,这两个毛病让 AI 离不开人类的兜底。
Jev 的解法干脆:别让 AI 聊天了。你问「这张工单该派给哪个团队」,它不解释、不寒暄,直接给你{"billing": 0.84, "technical": 0.15, "sales": 0.01},外加一个 confidence 值。
底层还是 transformer,但 TypeSafe没披露架构细节,也没公开权重。现在只能通过托管 API 用。
训练方法也换了一套,叫RLCD(Reinforcement Learning for Calibrated Decisions),专门优化「决策的概率是否校准得对」,不是优化「人类看着爽不爽」。
02
PART
一个端点,三种问题
HOW · THE API
Jev 的 API 简单到有点过分。
一个端点搞定一切:POST https://api.typesafe.ai/v1/systemone。请求体里塞三样东西:
state · 当前要决策的状态
model · 模型名(默认 jev-latest)
questions · 问题字典
问题有三种类型,全跑在同一个 state 上,互不干扰:
|
|
|
|
|---|---|---|
| Choice |
|
choice + probabilities + confidence |
| Score |
|
score + 等级概率 + confidence |
| Noul |
|
0 到 1 之间的概率 |
每个问题并行独立运行,TypeSafe 说加问题基本不影响响应时间。一次塞 10 个问题跟问 1 个问题,差不多快。
来看个实际例子。一个客服工单分流:
返回结果长这样(简化版):
JavaScript 那边也配套了@typesafe-ai/sdk,要求 Node.js 20+。Netlify 已经第一时间把 Jev 接进了 AI Gateway,配 SDK 直接用,免去配 API key 的麻烦。
03
PART
置信度才是核心卖点
WHY · CONFIDENCE
注意每个 Choice 和 Score 都带了confidence 值(0 到 1),这个值不是「最可能选项的概率」。
比如 billing 赢了 0.84,但 confidence 只有 0.596。为什么?因为 technical 还有 0.15,分布其实没拉开。
TypeSafe 在文档里给了三条路:
高 confidence → 直接执行
中 confidence → 进队列等人工复查
低 confidence → 直接派给人工
阈值得按决策失误的成本来定。删个评论跟审批一笔百万订单,阈值肯定不一样。
把 AI 的「不确定感」显式化,让代码能基于这个不确定性做路由。
这其实才是 Jev 真正想做的东西。
04
PART
价格、速度和早期玩家
PRICE · SPEED · EARLY USERS
价格上,Jev 输入是$42 / 十亿 token(也就是 $0.042 / 百万 token),输出免费。TypeSafe 拿同行定价对比了一下:$0.20 到 $10 / 百万 token,Jev 大概便宜 4 到 17 倍。
延迟在70ms 到 500ms之间。TypeSafe 自己跑了次 demo:Jev 0.114s 跑完一轮决策,花了 $0.000081;GPT-5.6 Terra 跑了 8.566s,$0.013880。差了75 倍速度、171 倍价格。
但这两个数字都得打折看:
评测是 TypeSafe 自己写的;「基准答案」是 GPT-6 Astra 和 Fable 5.1 的均值;「零幻觉」指的是 schema 匹配,不等于答案正确。TypeSafe 自己都承认,没法证明这价格没被补贴。
不过开发者社区的反应是真实的:
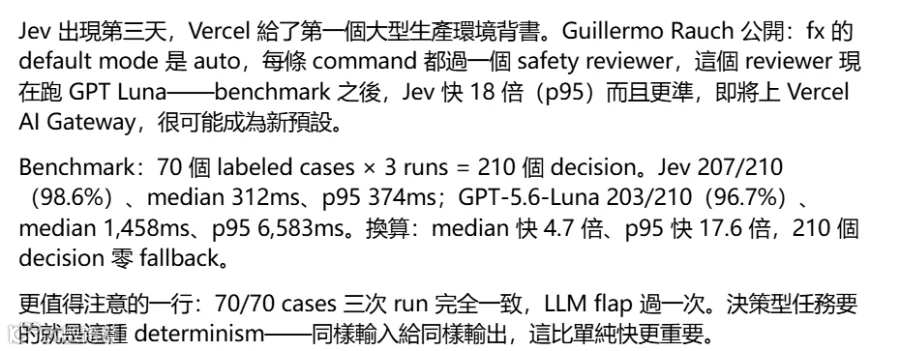
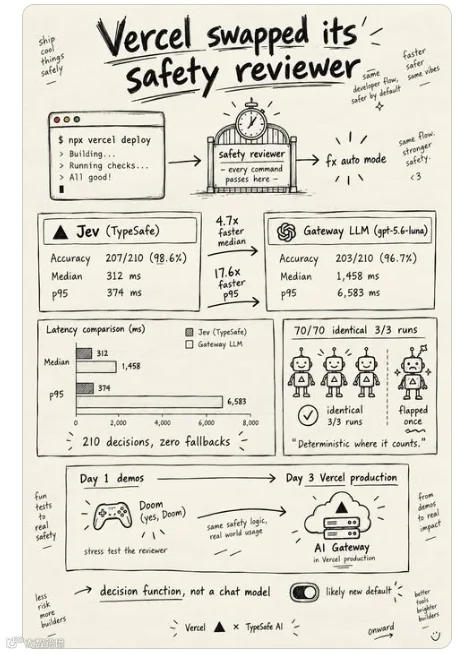
Vercel CEO · 命令安全审查
GUILLERMO RAUCH · 18x FASTER
Guillermo Rauch 跑了个命令安全审查,Jev 在 p95 上比 GPT Luna 快 18 倍,还更准。
Bryo AI · 邮件分流
NIKHIL MUDHOLKAR · 10-20x CHEAPER
Bryo AI 的 CTO 拿 Jev 做邮件分流,跟 Gemini 比 Gemini 准一点但 Jev便宜 10 到 20 倍。
Browser Use · 浏览器代理
JEV-ULTRAFAST · 7.1s
Droidrun · 手机代理
MOBILE-JEV · 21s · 9 ACTIONS
Droidrun 的mobile-jev在真 Android 上驱动 Uber,21 秒内完成 9 个动作。
社区玩具
JEV-GUARD · PG-JEV
还有jev-guard(工具调用守卫)、pg-jev(Postgres 自然语言过滤)这些社区玩具。
05
PART
冷静说说缺点
CAVEATS · 5 个槽点
几个新东西我比较担心的地方
没开源。架构、参数量、权重全没披露。本地跑不了,只能走 TypeSafe 托管。如果公司挂了或者政策变,集成 Jev 的产品会有迁移成本。
早期访问 + 候补名单。虽然托管 API 已开放,但还得排队才能拿到生产级配额。
基准由官方自评。所有「比 GPT 快 N 倍」的数据都来自 TypeSafe 自己写的 workflow。第三方独立测评还没出来。
「零幻觉」的边界。零幻觉只意味着输出永远符合 schema,答案本身可能依然错。置信度高不等于答案对。
RLCD 的细节也不公开。这个训练方法的具体奖励信号、采样策略,文档里没写。如果它和 RLHF 一样存在隐藏的 mode collapse 问题,得等用户量大起来才能发现。
∞
LAST
写在最后
FINAL · 综合判断
Jev 不是要取代聊天模型,它做的是聊天模型不擅长的事:在请求路径上做又快又便宜的结构化决策。
如果你的产品里有任何「分类、路由、评分、提取、guardrail」的环节,Jev 是个值得拿小流量试水的选项,前提是你接受托管 API 的依赖。
现在已经有 Vercel、Browser Use、Droidrun、pg-jev 这些实战案例了,TypeSafe 不再是 PPT 公司。下一步就看它的独立基准和长期稳定性能不能扛住。
既然看到这里了,如果觉得有用,随手点个赞、在看、转发三连吧。
THANKS FOR READING