

小米再次展现其在科技领域的激进策略。继发布搭载英伟达 Thor 芯片与激光雷达、售价 26.99 万元的七座大 SUV 后,其 AI 团队近日公开了大模型训练的实时过程。
此次直播展示了 MiMo-V2.6 系列模型的强化学习(RL)训练细节,包括实时算力消耗、故障记录及数据调度。作为商业公司,将高度机密的 RL 阶段训练全流程公开,尚属行业首例。
直播地址:https://mimo.xiaomi.com/rl/
一、小米公开了什么?
本次公开的直播页面主要涵盖 MiMo-V2.6-Pro 和 MiMo-V2.6-Flash 两个模型的训练实况,核心数据分为四个维度。
1. 实时训练成本账单
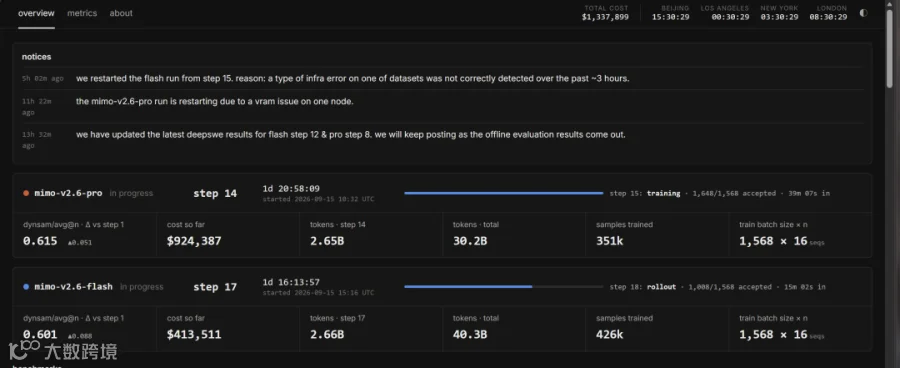
页面实时显示两条训练线的累计花费。截至观测时点,Pro 版本已消耗 92.4 万美元(第 14 步),Flash 版本消耗 41.4 万美元(第 17 步),合计烧掉约 134 万美元(折合人民币近 950 万)。
2. 动态采样与调度系统
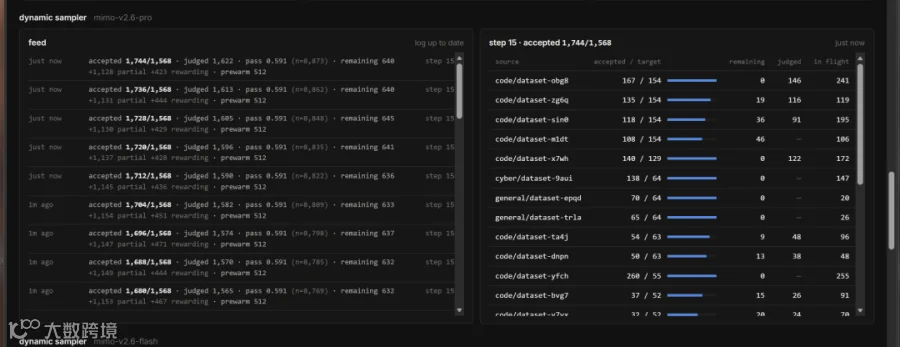
该系统负责模型的“发题”与“收卷”。模型每步需完成 1568 道题,每题重复 16 次。若某题 16 次结果全对或全错,则该数据无效,需重新计算。
日志流显示,系统需收集 1568 份合格答卷。例如在code/dataset-yfch题库中,配额仅需 55 份,但系统已派发 260 份任务,仍有 255 条轨迹在运行(in flight)。这表明该题库难度极大,需投入近十倍算力才能获取有效数据,是主要的成本消耗点。
3. 题目配比与多环境训练
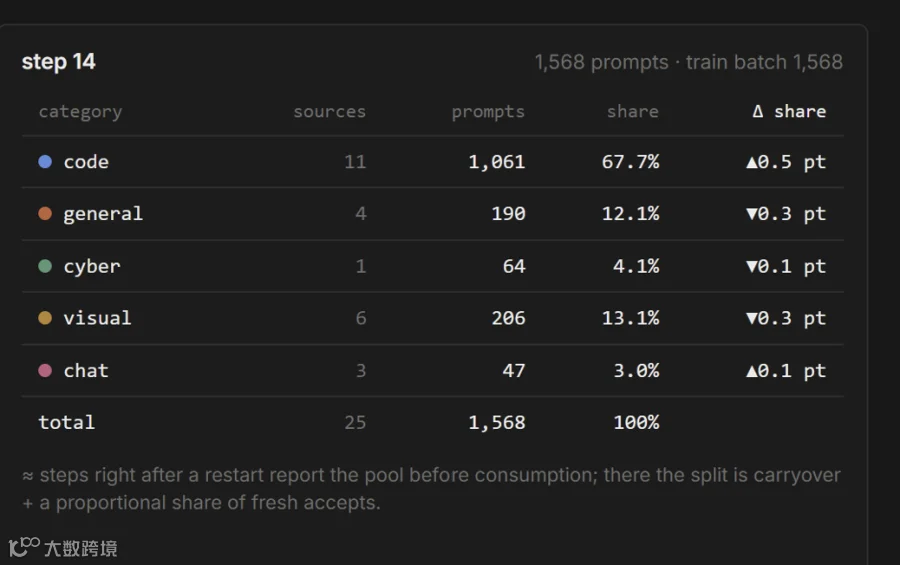
页面通过堆叠柱状图展示 25 个数据集(分五大类)的实时配比。该配比并非固定,而是根据模型当前的薄弱项动态调整。
此外,训练引入了多种"Harness"(考场环境配置)。同样的代码题,可能在终端环境执行,也可能在浏览器环境中操作。这种多任务 Agent 强化学习策略,旨在同一循环中混合训练多种能力。
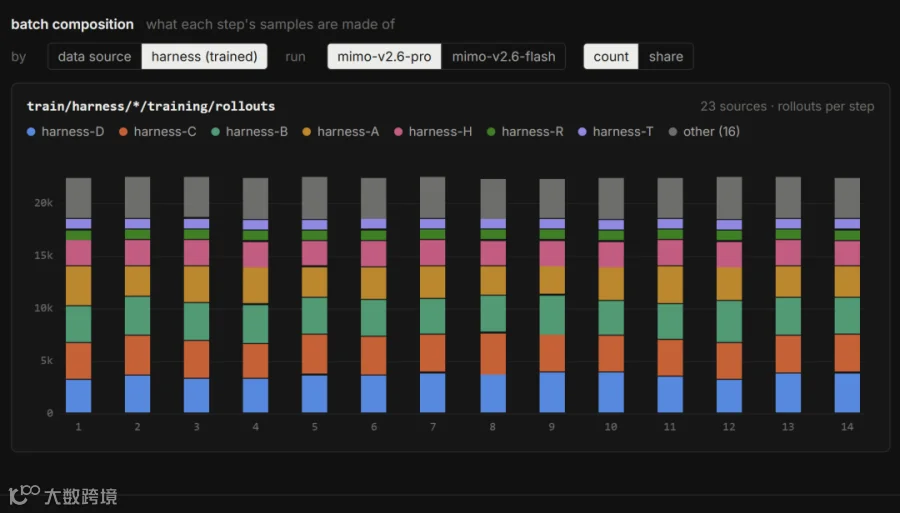
4. 训练指标仪表盘与故障监控
仪表盘重点监控三个核心指标:
- 模型成长性:通过
dynsam/avg@n(训练通过率)判断,曲线上升代表能力提升。 - 训练稳定性:通过
actor/grad_norm(梯度范数)观察,曲线平缓代表更新稳定,尖峰则意味着波动。 - 探索意愿:通过
entropy_loss(熵)评估,数值过低说明模型陷入局部最优,停止探索新解法。


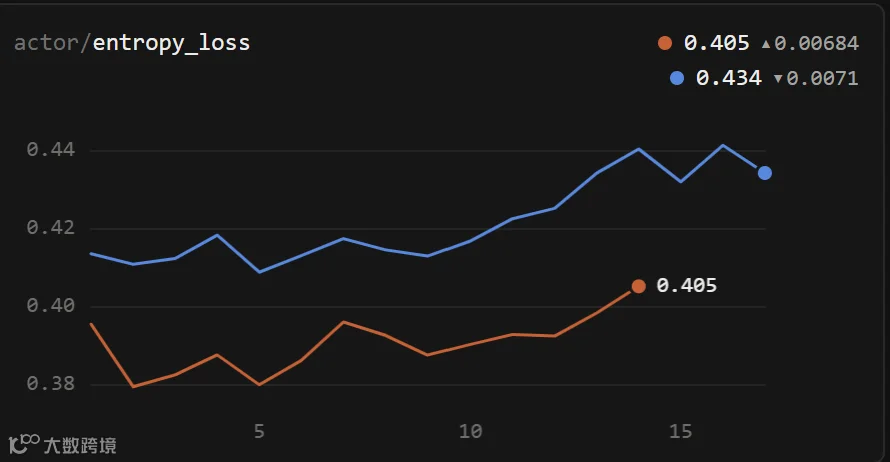
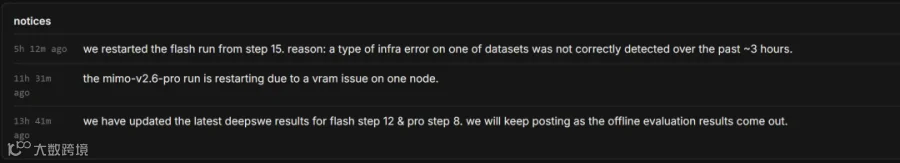
顶部通知栏还会滚动播报实时故障,如节点显存溢出导致重启等,实现了真正的“透明化”训练。
二、算力成本分析
根据页面数据推算,Pro 版本每小时消耗约 2.06 万美元,Flash 版本约 1.03 万美元,合计每秒烧钱约 8.5 美元。
单次尝试成本方面,Pro 模型约为 2.76 美元/题,Flash 为 0.83 美元/题。Pro 版本每提升 1 个百分点的通过率,需耗费约 15.5 万美元,是 Flash 版本的四倍有余。
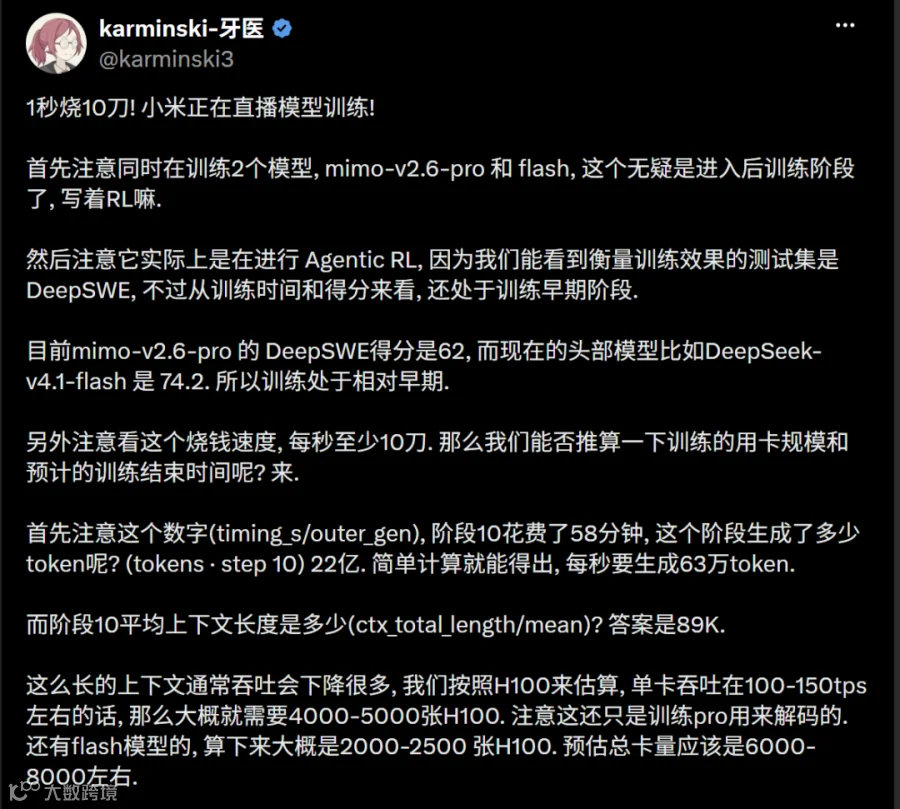
在算力规模上,推测 Pro 版本解码阶段需 4000–5000 张 H100 显卡,加上 Flash 版本,总算力规模可能在 6000–8000 张 H100 左右。
除了 GPU,大量成本还消耗在沙箱环境上。页面显示 Pro 维持着 23,180 个活跃沙箱,Flash 维持着 37,786 个,意味着超过 6 万个 Linux 容器在并发执行真实 Agent 任务。

值得注意的是,此次 RL 训练每百万 token 的成本高达 33.4 美元,是 MiMo-V2.5-Pro API 输出价格(0.609 美元)的 55 倍,显示出当前 API 收入远无法覆盖高昂的训练开销。
三、为何选择完全透明?
小米 AI 负责人罗福莉表示,团队过去半年聚焦于一个问题:“强化学习到底还能扩多远?”
随着预训练数据红利见顶,行业重心转向后训练(Post-training)阶段的强化学习。虽然 DeepSeek-R1 证明了 RL 的潜力,但其收益边界仍是未知数。小米选择以完全透明的方式公开训练全过程,旨在验证持续加大 RL 投入是否能带来模型能力的线性增长。
四、总结
回顾小米大模型的发展节奏:从 4 月开源万亿参数 MiMo-V2.5 系列并宣布三年投入 600 亿,到 6 月推出 UltraSpeed 版本,再到此次公开 V2.6 的训练现场,其策略一脉相承:先闷头研发,成果亮相时直接摊开底牌。
正如页面底部所言:"Open is what we value."尽管日均 500 万的训练成本高昂,但这种明明白白的投入方式,为行业提供了宝贵的参考坐标。
