

模型能否像人类一样真正“看见”并形成持久“记忆”,是近两年 AI 领域的核心命题。2024 年,当大语言模型在文本推理上屡破天花板时,前 Meta 现实实验室研究员沈俊潇(Shawn Shen)与周恩民(Ben Zhou)嗅到了视觉记忆的空白,于硅谷创立 Memories.ai。
2025 年 7 月,公司走出隐身模式,发布全球首个大型视觉记忆模型(LVMM)并完成种子轮融资。一年多后,Memories.ai 发展显著加速:融资额追加至 1600 万美元,与高通、英伟达达成战略合作,并在 2026 年 CES 上推出 LUCI 开发者硬件平台。近日,DeepTech 再次对话沈俊潇,探讨其关于视觉记忆、物理 AI 自我进化及商业模式的最新思考。
精简团队与高能动性人才策略
Memories.ai 始终维持精简的团队规模。创始人沈俊潇将主要精力置于把握公司战略方向与招募关键人才上。他曾通过内部实验发现,在特定任务中,单名高能动性员工的效率往往高于五人小组。因此,公司在招聘时极度看重候选人的高能动性及其与公司愿景的对齐度(vision aligned)。
目前,公司的聚焦方向已从基础的“记忆存储”升级为利用视觉记忆驱动 AI 的“自我进化”。
重塑"AI 记忆”:从个性化服务到物理世界自我进化
2024 至 2026 年间,"AI 记忆”概念迅速膨胀,涵盖了从用户偏好记住到长上下文检索等多个层面。沈俊潇将"AI 记忆”划分为两类:一是服务于个性化体验,让 AI 更懂用户;二是服务于自我进化,让 AI 任务执行更高效。
他认为,随着基础模型能力的增强,个性化记忆的护城河正在消失,其本质仅是配置文件加智能体框架。真正的价值在于第二类——构建关于“世界的记忆”。其目标是让机器人和物理智能系统在部署新场景时,能凭借积累的视觉经验进行自我修正与提升,最终实现“物理世界的递归自我进化”(Physical RSI)。
视频记忆的基础设施挑战
这一判断基于一个关键技术前提:文字是大模型的原生模态,而视频并非如此。视频数据密度大、非结构化且受时间轴锁定,无法像文本那样由大模型自主管理。构建能够索引视频、生成结构化数据并高效存储的“脚手架”,是一项巨大的基础设施工程。
Memories.ai 的核心工作正是搭建这套脚手架:在编解码器层面进行压缩编码,自主训练模型将视频转化为向量及描述文本,并最终汇入自建的视频数据湖。据投资方三星 Next 披露,公司在发布 LVMM 时已索引超 100 万小时视频,其视频记忆容量是同类方案的 100 倍。
该策略已获得行业巨头认可。2025 年 11 月,公司与高通合作,推动 LVMM 2.0 在高通处理器上原生运行,实现端侧编码与索引,以降低延迟并保护隐私。2026 年 GTC 大会上,其技术正式接入英伟达 Cosmos-Reason 2 和 Metropolis 平台。
模型自进化:每轮迭代提升 1% 至 2%
沈俊潇对物理 AI 的自进化路径有清晰预期:模型在新场景部署初期的准确率约为 70%,通过持续的自我进化,可提升至接近 90%。每次迭代约提升 1% 至 2%,同时将对外部标注数据的依赖降至最低。
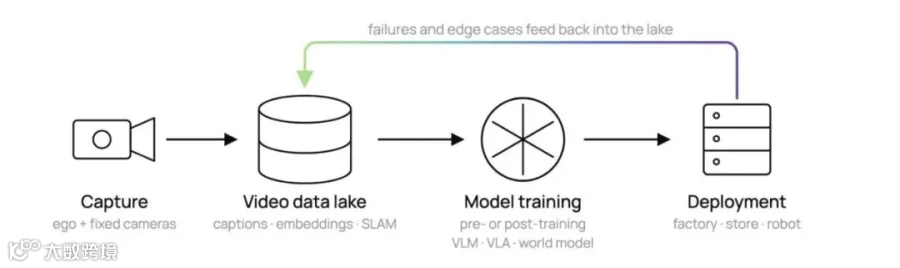
具体流程为:模型部署后,视频数据湖持续记录原始视觉数据。一旦系统检测到识别错误或决策失误等“失败模式”,会自动定位相关片段并反馈至训练环节,进行针对性的后训练(Post-training)。
以机器人在不同店铺的场景为例,边缘情况(Edge Case)千差万别。理想状态下,无需人工定义每个异常,机器人应通过记录全过程并从中自主学习,不断优化表现。
(来源:Memories.ai)
这一方向直击当前物理 AI 的痛点。Voxel51 发布的《2026 视觉与物理 AI 现状报告》显示,尽管 78% 的团队已从项目中获益,但模型表现不达标仍是普遍问题,瓶颈主要在于数据质量、样本覆盖度及标注工作流,而非模型架构本身。
沈俊潇强调,加速进化的关键不在于算法创新,而在于数据利用率:“我们的目标是在出现 100 个失败样本后,能将其全部转化为训练养分,从而提升模型能力。”
商业模式:构建“数据飞轮”
随着场景明确,Memories.ai 的商业模式日益清晰,客户主要分为两类:
第一类是企业客户,包括工厂、连锁快餐店及商超。公司为其提供视觉模型的后训练与部署服务,用于 SOP 检查、库存监控等,并将产生的真实视频数据留存于自有数据湖。
第二类是前沿机器人实验室,主攻视觉 - 语言 - 动作(VLA)模型或世界模型。Memories.ai 将积累的企业场景视频数据分享给这些实验室,助其训练更强大的机器人模型,而这些模型未来又可反哺至企业场景中。
从场景数据采集到实验室模型训练,再到机器人实地部署,一个闭环的“数据飞轮”由此形成,赋予了公司自我造血的能力。
坚持规模化与真实世界数据
在“架构优先”还是“数据规模优先”的争论中,沈俊潇坚定选择后者。他认为 Scaling(规模化)依然是 AI 发展的核心动力。在数据来源上,他更偏好真实世界数据,因为仿真环境无法完全替代真实部署的复杂性,而世界模型更适合作为基础结合真实数据进行后训练。
与此同时,团队在数据效率上也取得了多项突破:MARC 技术通过强化学习将视觉令牌负载降低 95%;O-MARC 提升了多模态推理速度与内存效率;OmniRetriever 在统一检索空间中表现出色;SpatialMem 则实现了基于第一人称视频的 3D 索引构建。
面对激烈的市场竞争,沈俊潇强调了公司的两大差异化优势:一是视频数据湖与视觉模型的深度绑定,数据随客户部署自然沉淀;二是明确的生态位定位——专注于数据评估与模型后训练,既不涉足机器人制造,也不与 VLA 模型公司争利。
展望:内核增长仍是主旋律
访谈最后,沈俊潇重申了对"AI 记忆”定位的判断。他认为,作为独立品类的“记忆”市场空间有限,记忆不应是终极目的,而是辅助模型用更少提示完成更长程任务的手段。
从宏观视角看,他将 AI 系统分为“内核”(模型能力)与“外核”(交互体验)。在当前阶段,模型内核仍处于指数级增长期,行业焦点必然集中于内核能力的突破。只有当内核增长放缓时,外核的差异化竞争才会成为主流。
注:封面/首图由 AI 辅助生成