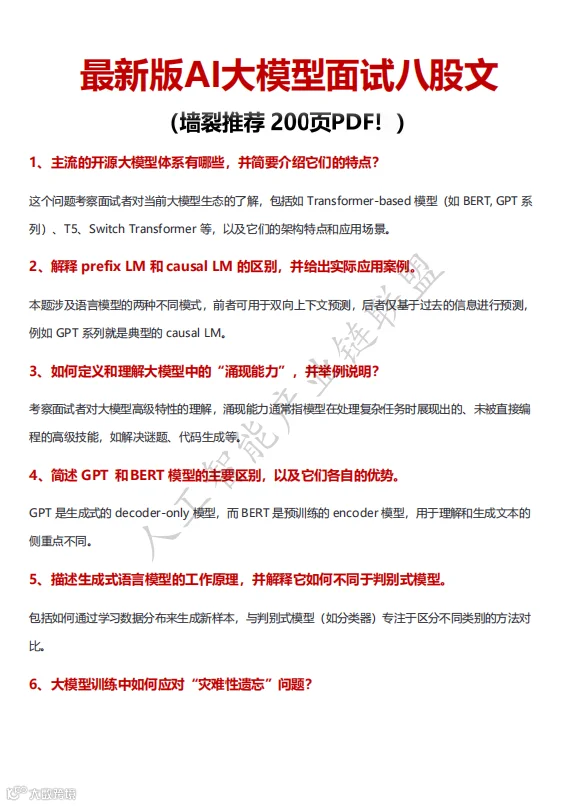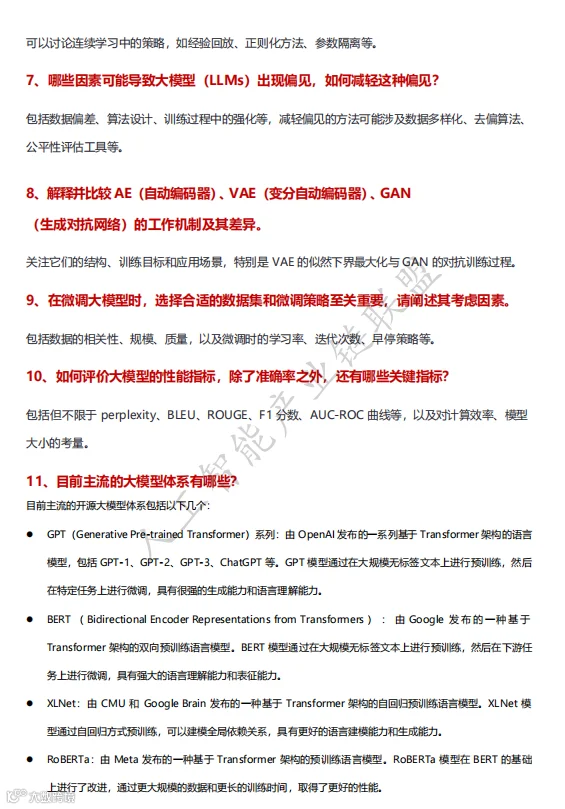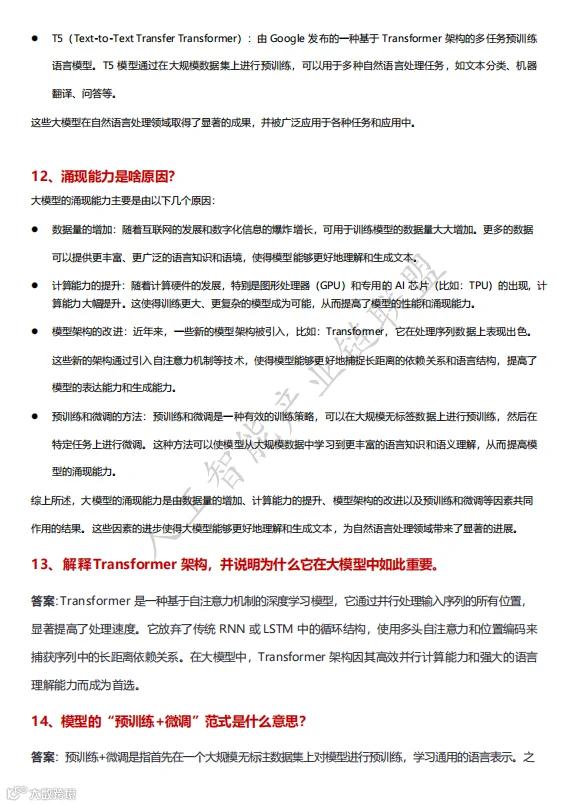
近期,一份涵盖 Transformer、GPT/BERT、微调策略、RLHF、LoRA、LangChain、RAG 及模型评估部署的《AI 大模型面试题 (102)》在技术圈广为流传。面对庞杂的知识点,如何精准把握核心?本文对该文档进行深度提炼与专业解读,梳理大模型面试的核心脉络,助您高效备考。
一、大模型生态图谱:主流模型解析
面试常从主流大模型的基本认知切入,以下是核心模型的特征总结:
- GPT 系列:OpenAI 出品,采用 Decoder-only 架构,擅长文本生成,代表作为 GPT-3、ChatGPT。
- BERT:Google 出品,采用 Encoder-only 架构,擅长语义理解,广泛应用于文本分类、NER 及语义相似度计算。
- XLNet:基于自回归预训练,有效建模全局依赖关系。
- RoBERTa:Meta 优化的 BERT 版本,通过增加数据量和训练时长提升性能。
- T5:Google 提出的 Text-to-Text 模型,采用 Encoder-Decoder 架构,将所有任务统一为“文本到文本”形式。
- ChatGLM:清华系研发,采用 Prefix Decoder 架构,支持中英双语,专注于对话场景。
- LLaMA:Meta 开源模型,采用 Decoder-only 架构,以英文为主,拥有庞大的开源生态。
核心区别简述:GPT 是“生成专家”,BERT 是“理解专家”,T5 是“通用转换器”,ChatGLM 精通中文对话,LLaMA 则是开源基座的代表。
二、Transformer:面试核心考点
Transformer 架构是大模型面试的重中之重,主要考察以下六个维度:
1. 自注意力机制(Self-Attention)
公式:
\[ \text{Attention}(Q,K,V)=\text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V \]
原理解析:Q(Query)代表“搜索目标”,K(Key)代表“特征索引”,V(Value)代表“具体内容”。注意力机制使模型能动态判断当前词应关注哪些上下文信息。
2. 缩放因子 \( \sqrt{d_k} \) 的作用
Q 与 K 点积后,数值随维度增大而膨胀,导致 Softmax 进入饱和区,梯度趋近于零。除以 \( \sqrt{d_k} \) 可将数值拉回稳定范围,确保训练收敛性。
3. 多头注意力(Multi-Head Attention)的优势
单头注意力仅能从单一视角捕捉信息,而多头机制允许模型同时关注语法、语义、指代及位置等多维特征,类似多专家协同处理不同任务。
4. Encoder 与 Decoder 的交互机制
Encoder 将输入编码为上下文表示;Decoder 在生成过程中,通过 Encoder-Decoder Attention 机制查询 Encoder 的输出。在翻译任务中,表现为 Decoder 生成目标语言时实时回溯源语言的关键信息。
5. Mask 机制的应用
- Padding Mask:屏蔽填充的无效 Token,避免干扰计算。
- Causal Mask:防止 Decoder 泄露未来信息,确保自回归生成的因果性。
6. Transformer 优于 RNN 的原因
- 并行计算:基于矩阵运算,充分利用 GPU 算力。
- 长距离依赖:任意两个位置可直接建立连接,无路径衰减。
- 可扩展性:支持深层与宽层堆叠,参数规模扩大后易涌现新能力。
三、GPT 与 BERT 的深度对比
| 对比维度 | GPT | BERT |
| 架构 | Decoder-only | Encoder-only |
| 处理方向 | 单向自回归 | 双向完形填空 |
| 核心任务 | 文本生成 | 语义理解 |
| 典型应用 | ChatGPT | 文本分类、NER |
| 训练目标 | 预测下一个词 | MLM + NSP |
专业解读:GPT 如同“作家”,依据前文续写后文;BERT 如同“编辑”,结合上下文理解句意。当前大模型趋势转向 Decoder-only 架构,旨在通过生成式范式统一各类任务。
四、涌现能力:模型规模与智能的关系
大模型的涌现能力主要源于四大要素:
- 数据量爆发:互联网文本数据的指数级增长。
- 算力提升:GPU/TPU 大规模集群的支持。
- 架构演进:Transformer 自注意力机制的突破。
- 训练范式:“预训练 + 微调”策略的成熟。
通俗理解:当模型规模跨越临界点,coding、数学推理等能力并非刻意训练所得,而是自然“涌现”。这也是大模型最具魅力与不确定性的特征。
五、训练优化:遗忘、过拟合与显存挑战
灾难性遗忘(Catastrophic Forgetting)
现象:学习新领域知识时丢失旧知识。
解决方案:混合通用数据训练、经验回放、正则化、参数隔离及控制学习率。
过拟合与欠拟合
- 过拟合:训练集表现优异但测试集失效。解法包括正则化、Dropout、早停及数据增强。
- 欠拟合:训练集学习效果不佳。解法包括增加参数量、扩充数据及改进架构。
显存与成本优化
常用策略包括:梯度累积、混合精度训练、模型/数据并行、FSDP、量化、剪枝、蒸馏及分布式训练。大模型训练本质上是一场“显存保卫战”。
六、微调与对齐:LoRA、RLHF 实战
1. 预训练与微调范式
预训练:利用海量无标注数据学习通用语言能力。
SFT(有监督微调):利用特定任务数据教授模型遵循指令。
2. LoRA(低秩适配)
在不改变原模型权重的前提下,旁路添加低秩矩阵 A 和 B。如同为模型挂载轻量级插件,显著降低训练参数与显存占用,适合垂直领域快速适配。
3. Prompt Tuning vs Prefix Tuning
- Prompt Tuning:优化输入端的可学习提示向量(偏提示工程)。
- Prefix Tuning:优化模型内部的前缀参数(偏参数微调)。
4. RLHF(人类反馈强化学习)
三步流程:模型生成答案 -> 人类/奖励模型打分 -> 利用 PPO 算法优化模型以符合人类偏好。
对比 DPO:DPO(直接偏好优化)省去了奖励模型训练环节,流程更简洁高效。
七、评估体系:超越准确率的多维指标
- PPL(困惑度):衡量语言模型概率分布的核心指标。
- BLEU / ROUGE:适用于机器翻译与文本摘要任务。
- F1 / 准确率 / 召回率:分类任务的标准指标。
- AUC-ROC:评估排序能力。
- BERTScore:基于语义相似度的评估。
- 人类评估与 A/B 测试:关注主观质量与真实业务效果。
专家建议:生成式任务无标准答案,单纯依赖 BLEU 存在局限,应更重视“人类偏好”与“任务成功率”。
八、工程落地:LangChain、RAG 与 Agent
LangChain Agent
赋予大模型工具调用能力(如查天气、搜库、调 API)。Agent 架构 = 大脑(模型)+ 工具 + 记忆 + 规划。
RAG(检索增强生成)
企业知识库标配方案。流程:文档切块 → 向量化 → 存入向量库 → 检索相关片段 → 大模型生成答案。
核心价值: akin to“开卷考试”,通过外部知识检索减少模型幻觉。
关键议题
- 多模态:文本、图像、语音的联合理解。
- 隐私安全:去标识化、差分隐私、联邦学习。
- 公平性与可解释性:数据去偏、注意力可视化、LIME/SHAP 分析。
九、高频手写代码与推导题
面试中常见的手写与推导要求包括:
- 手写 Scaled Dot-Product Attention 代码。
- 详解 Q、K、V 的物理含义。
- 阐述多头注意力的必要性。
- 解析 LayerNorm 优于 BatchNorm 的原因。
- 推导位置编码公式。
- 分析 Self-Attention 复杂度 \( O(n^2d) \) 及优化方案(稀疏注意力、FlashAttention、MQA/GQA 等)。
备考建议:务必掌握 Attention 手写代码,清晰阐述 Encoder/Decoder 交互流程,并能绘制 Transformer 结构图。
十、思维升华:AI 时代的职业定位
在 AI 浪潮下,技术人的发展路径可类比马斯洛需求层次:先保障基础技能与安全(饭碗),再追求成长与成就。持续学习、善用工具、构建不可替代的专业壁垒,是实现自我价值的关键。
结语:大模型面试备考指南
- 夯实基础:精通 Transformer、Attention 机制及 GPT/BERT 差异。
- 掌握训练:熟悉预训练、SFT、RLHF、LoRA 及灾难性遗忘对策。
- 工程实践:了解 RAG、LangChain、向量库及模型部署量化。
- 评估体系:掌握 PPL、BLEU、ROUGE 及人类评估方法。
- 项目复盘:准备一个完整的大模型应用案例,清晰阐述架构、数据、指标及难点攻克。
死记硬背不可取,真正的高手是将 Transformer 视为常识,将微调视为工具,将业务落地视为终极目标。