


企业知识库的构建难度远超预期。在筹备 AI Maker Summit 上海站期间,团队面临文档繁杂的挑战:现场流程、预决算表、讲师大纲、PPT、SOP 及复盘文档等信息分散各处。
基于过往百余场大会的视频与内部资料沉淀,构建一个兼顾内外权限的知识库成为刚需。起初认为这仅是典型的 RAG(检索增强生成)场景:文档切块、Embedding 向量化、语义匹配即可。然而,耗费大量 Token 搭建的雏形在实际测试中表现不佳。
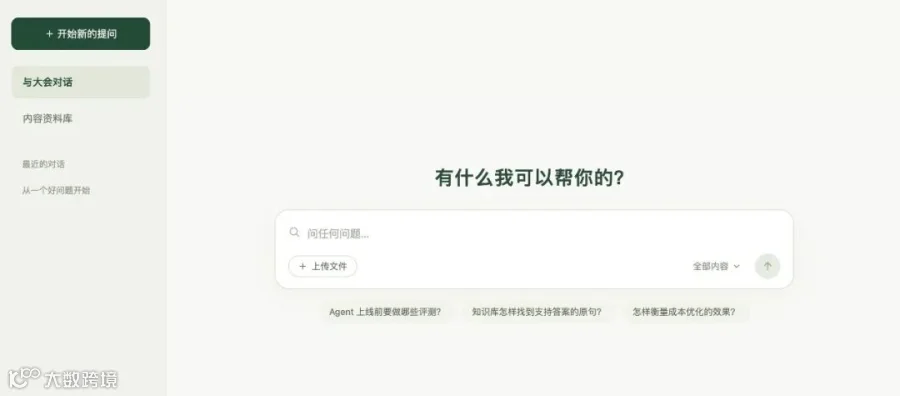
RAG 方案的局限性:检索质量决定上限
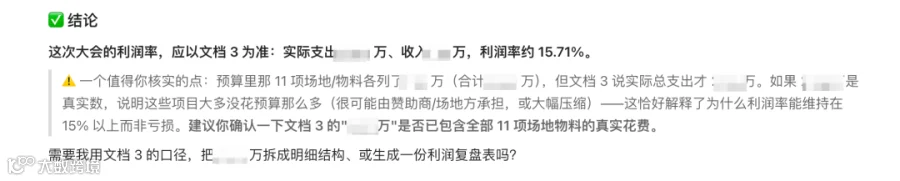
在查询“本次大会利润率”时,系统错误地返回了去年北京站的数据。究其原因,传统 RAG 仅基于语义相似度匹配,无法识别时间维度的差异,更不具备利用现有成本与收入数据进行逻辑计算的能力。
深入复盘发现,企业数据并非孤立存在。预算表关联特定届次的大会,支出对应具体供应商,讲师大纲则链接至 PPT、视频及复盘报告。这种复杂的实体关系网络,是单纯语义检索难以处理的痛点。

解决方案:腾讯乐享的企业级实践
针对成熟知识库、Agent 原生能力、第三方调用(如 Codex)、权限控制及文档治理等核心需求,腾讯乐享提供了完整的解决方案。
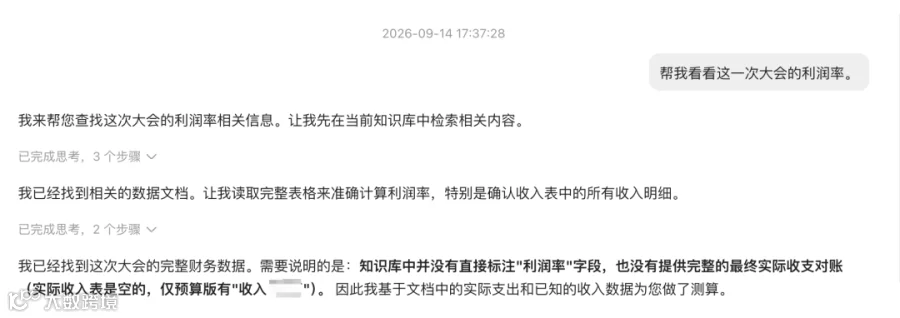
通过快速搭建团队并分类上传文件,系统展现了强大的处理能力。再次询问“本次大会利润率”,系统不仅识别出多份涉及支出的文档,还能自动核对版本差异,推理出准确的决算数据。

核心优势一:知识图谱与冲突检测
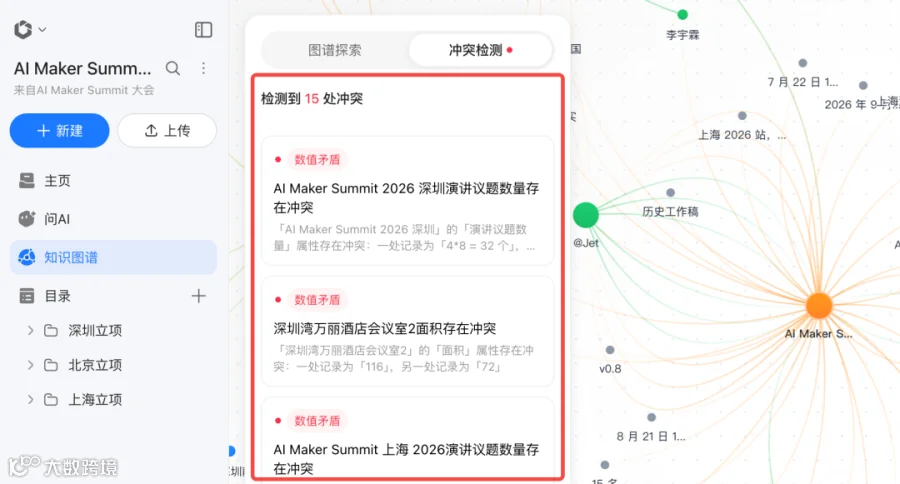
腾讯乐享的高准确率源于检索前的深度知识加工——构建知识图谱。系统将散落在不同文档中的同一实体(如项目、预算、人员)进行关联,清晰呈现版本演变与信息冲突。
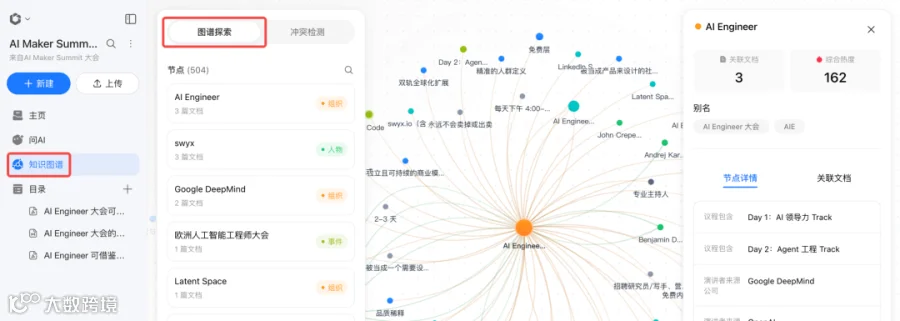
相比传统 RAG 容易混淆多版本文档,知识图谱能精准判断资料的时效性与有效性。其内置的冲突检测机制,能在 Retrieval 环节前自动识别并标记不同部门或阶段产生的数据矛盾,确保输入模型的信息可信。
核心优势二:LLM Wiki 与 Agent 生态打通
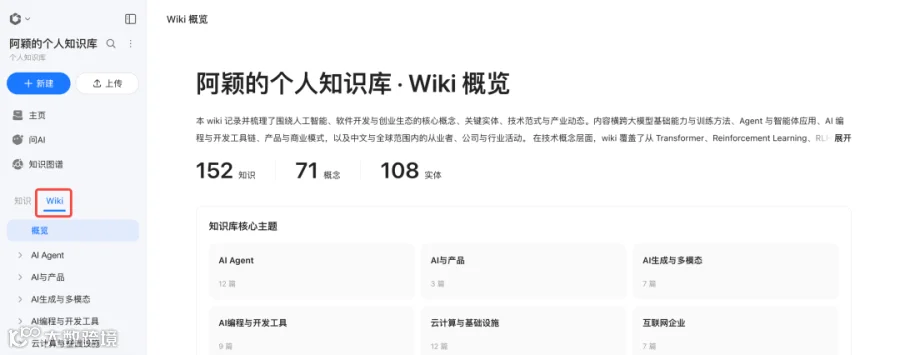
平台提供的 LLM Wiki 功能,将非结构化的 PDF、Word 等原始资料转化为适合 Agent 理解和调用的结构化知识,解决了格式混乱与上下文缺失问题。
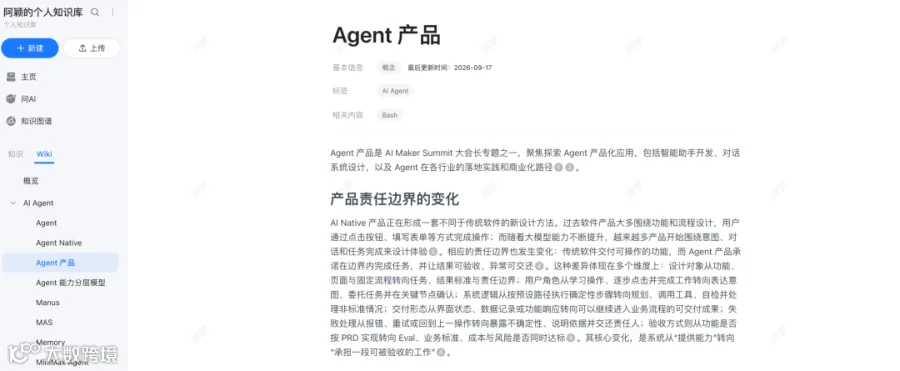
目前,腾讯乐享已打通 WorkBuddy、豆包工作等主流 Agent 连接器。用户可直接调用知识库生成复盘幻灯片,或让参会者通过自然语言查询大会详情。
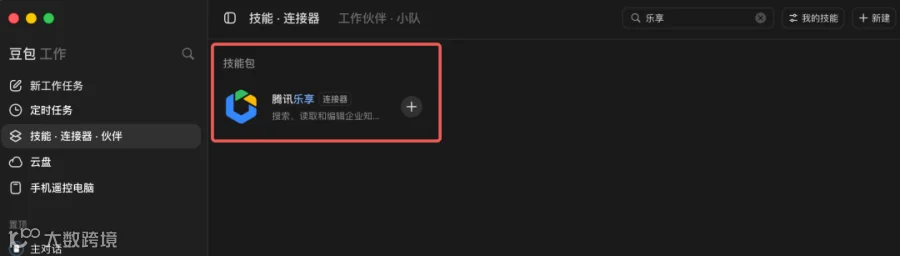
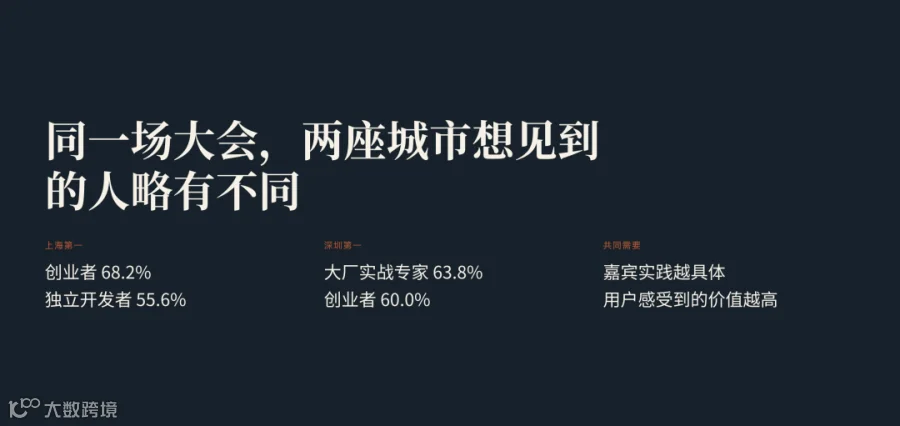
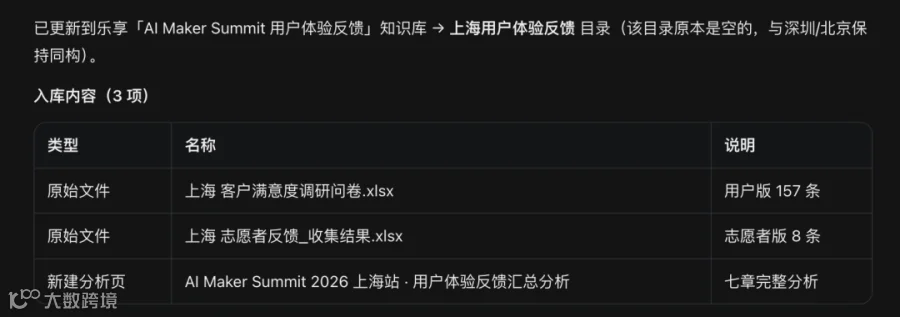
此外,支持在 Agent 界面直接更新知识库内容,系统随即完成同步分析与文件归档,实现了知识与业务的实时闭环。
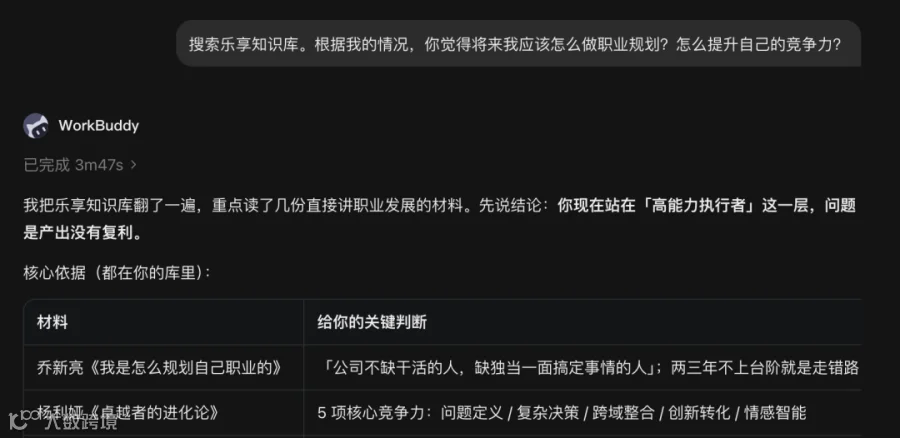


结语:为 Agent 提供可信 Context
从搭建到落地仅耗时数小时,这一过程重塑了对企业知识库的认知。它不仅是信息查询的入口,更是 Agent 运行时依赖的核心上下文(Context)。在未来企业 AI 落地的进程中,构建能够为 Agent 提供可信、结构化知识的底座,将成为最关键的基础设施。