

导读在模型落地部署中,“格式”与“量化”常被混为一谈。SafeTensors、ONNX、GGUF 和 Engine 到底有何本质区别?FP16、BF16 与 FP32 到底有何物理差异?为什么有了定点 INT8/INT4 还要力推 FP8 与 FP4?线性量化的 Scale 与 Zero-Point 究竟在算什么?非对称量化虽然拟合更好,为什么会在矩阵乘法中带来额外的计算开销?本文作为 4 篇全景系列的第 1 篇,从计算机浮点底层结构与线性量化数学公式推导出发,剖析浮点演进与对称/非对称映射的物理本质,为全栈部署建立扎实的数学底座。
本文 3875 字,阅读约 10 分钟|格式辨析 → 浮点基石(FP32/FP16/BF16) → 低比特浮点(FP8/FP4) → 线性量化公式 → 对称 vs 非对称推导
格式是容器,量化是计算:别再把它们搅在一起
很多工程师在刚接触模型部署时,经常被一堆名词绕晕:
“我导出了一个 ONNX 模型,它算量化了吗?”
“GGUF 到底是一种模型文件格式,还是一种 INT4 量化方法?”
“SafeTensors 里面存的到底能是浮点数还是整数?”

要彻底理顺部署链路,第一步必须建立一个清晰的认知:格式是“数据的容器与组织方式”,而量化是“数值精度的压缩与计算规则”。

一个 SafeTensors 文件里,既可以存储原始的 16 位浮点数(FP16/BF16),也可以存储经过 AWQ 算法量化打包后的 4 位整数(INT4);同理,一个 ONNX 文件既可以是纯浮点模型,也可以插入 QDQ(Quantize/Dequantize)量化算子。
格式决定了模型“在哪里以什么结构存”,量化决定了权重和激活“用多少比特、按什么公式算”。
浮点基石:FP32、FP16 与 BF16 的物理差异
在讨论定点量化(INT8 / INT4)之前,我们必须先看清高精度浮点家族本身的结构划分。
在 IEEE 754 标准中,浮点数由三部分组成:1 位符号位(Sign)、指数位(Exponent,决定动态范围)与 尾数位(Mantissa,决定精度)。
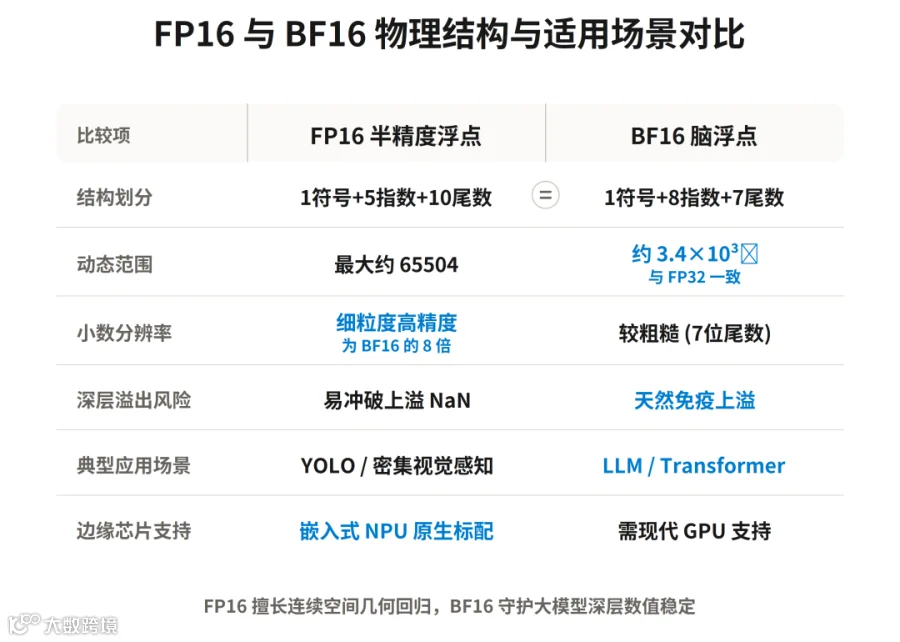
为什么 YOLO(传统深度学习代表)倾向于使用 FP16,而 LLM 必须使用 BF16?
💡 工程视角注记:YOLO 与传统深度学习的关系
很多开发者习惯将模型划分为“生成式大模型”与“传统深度学习(CNN / 判别式视觉)”。本文以 YOLO 全系列 作为传统视觉感知的标杆案例,因为它是工业界落地规模最广、硬件适配最极致的工程代表。文中所推导的 FP16 尾数精度、连续空间回归与量化数学逻辑,对 ResNet、MobileNet、ConvNeXt、U-Net、PP-OCR、RT-DETR 等所有经典深度学习模型完全通用。
很多开发者会疑惑:既然 BF16 范围大且不易溢出,为什么以 YOLO 为代表的传统深度学习很少默认用 BF16,而是广泛采用 FP16? 这背后是由两者的任务本质、网络深度与硬件生态共同决定的:
1. 连续坐标回归 vs 离散概率预测(精度诉求不同):YOLO 及传统视觉关注高精度空间回归,目标检测需要精确预测 BBox 边界框坐标($x, y, w, h$ 的像素级连续实数偏移量)。FP16 拥有 10 位尾数(有效数字 3~4 位),其细粒度小数分辨率是 BF16 的 8 倍,能有效防止细小边框在回归时因舍入误差产生抖动;而 LLM 关注离散词表概率分类,大模型预测的是下一个 Token 的相对概率大小(Softmax Logits),神经网络天生对尾数低位噪声高度钝感,但对数值溢出零容忍。
2. 网络深度与数值累加(溢出风险不同):传统 CNN / YOLO 网络较浅,通常只有几十层卷积,特征图数值范围容易控制在 FP16 的 $[-65504, 65504]$ 内,配合简单的 Loss Scaling 就能非常稳定地训练;而 LLM 网络极深且参数巨大,上百层 Transformer 在残差连接(Residual Connection)和多头注意力中不断累加,数值极易冲破 65504 导致上溢(Overflow 变成 NaN 崩塌),或梯度过小导致下溢(Underflow 归零)。BF16 的 8 位指数(与 FP32 完全相同的 $\pm 3.4 \times 10^{38}$ 动态范围)是保障千亿大模型稳定训练的绝对基石。
3. 硬件部署生态(边缘芯片兼容性不同):传统视觉模型扎根边缘端,YOLO 及经典 CNN 的主力部署设备是各类嵌入式工控盒子、移动芯片与边缘 NPU(如瑞芯微 RK3588、树莓派、老款 Jetson 及 Pascal/Turing 架构 GPU)。这些硬件底层普遍原生支持 FP16 / INT8,但很多不支持 BF16(BF16 需要 NVIDIA Ampere 架构如 A100/RTX 30 及以上才支持硬件加速)。为了跨硬件平台开箱即用,经典视觉体系始终以 FP16 为基准;而 LLM 扎根数据中心,大模型训练与部署高度集中在 A100、H100、B200 等现代数据中心加速卡上,这些芯片物理层具备专为 BF16 深度优化的 Tensor Core 算力。
4. 唯一保留 FP32 的局部角落:在 LayerNorm / RMSNorm 计算方差累加($\sum x^2$)以及 Softmax 计算指数累加($\sum e^x$)时,底层算子会在寄存器内部临时向上转换(Upcast)到 FP32 累加,防止小数值被截断下溢,算完再向下转换(Downcast)回 BF16。在 PyTorch AMP 自动混合精度中,这种类型转换(Type Cast)是底层最基础的操作。
低比特浮点演进:为什么有了 INT8/INT4 还要搞 FP8 与 FP4?
很多人会有疑问:“我们已经有了定点整数 INT8 和 INT4,为什么 NVIDIA Hopper(H100)和 Blackwell(B200)还要力推 FP8 和 FP4 浮点量化?”
1. 均匀定点 vs 非均匀浮点的物理本质
定点整数(INT8 / INT4)的局限:它是均匀网格(Uniform Grid),所有量化阶梯的步长完全一致。然而,深度学习中权重和特征图绝大部分数值都聚集在 $0$ 附近(呈正态分布或长尾分布)。用均匀网格量化,会导致 $0$ 附近大量密集的信息分辨率不足,而在两端稀疏区域又白白浪费了大量表示阶梯。
低比特浮点(FP8 / FP4)的优势:浮点数自带指数位(Exponent),因此它的数值分布是非均匀的(Non-Uniform)——数值越接近 $0$ 采样点越密集,数值越大采样点越稀疏。这种特性天然与神经网络的钟形权重分布完美契合,在极低位宽下能保留更强的非线性表达能力。
2. FP8 的两大孪生标准:E4M3 vs E5M2
NVIDIA、ARM 与 Intel 联合定义的 FP8 格式分为两种互补形态,已成为 H100/H800 与 RTX 4090 的硬件原生格式:
3. FP4 与 Microscaling(微缩放)技术:B200 算力翻倍的核心秘密
到了 4 位浮点(FP4),每个数值仅用 4 个 bit 表示(仅有 16 个离散状态):
E2M1 格式:1 位符号 + 2 位指数 + 1 位尾数,构成了最紧凑的非线性浮点网格;
Microscaling(微缩放 / OCP MX-FP4 标准):由于 4-bit 动态范围极为有限,工业界普遍采用“分块微缩放”策略——每 16 或 32 个 FP4 元素作为一个 Block,共享一个高精度的 8 位 Scale 缩放因子;
算力收益:NVIDIA Blackwell(B200)架构的 FP4 Tensor Core 峰值算力直接比 FP8 翻倍、比 FP16 翻 4 倍(单卡算力达到 20 PFLOPS),使千亿参数大模型得以在单卡消费级或单机边缘设备上超高速推理。
4. 深度辨析:FP8 与 FP4,以 YOLO 为代表的视觉感知模型能用到吗?
很多工程师会好奇:“既然 FP8/FP4 在大模型上算力翻倍,那我们在做 YOLO 或视觉目标检测时,能不能直接转 FP8 或 FP4?”
答案是:必须分场景严谨看待——FP8 是云端利器,而 FP4 是绝对禁区。

FP8:云端多路视频分析的高效解法。FP8 E4M3 具备 3 位尾数精度与 $\pm 448$ 动态范围。YOLO 的特征图数值非常收敛,在 TensorRT 10.x 下转为 FP8 E4M3 后,目标检测 mAP 损失通常小于 0.1%,几乎完全无损;适用场景为云端高性能 GPU(RTX 4090 / L40S / H100 / Blackwell)。单卡并发处理 64~128 路 1080P 视频流时,FP8 可以让推理吞吐与 FPS 相比 FP16 直接翻倍。需要注意各类嵌入式 NPU 底层没有 FP8 硬件单元,无法在端侧加速。
FP4:YOLO 与几何空间回归的“绝对禁区”。FP4 E2M1 仅有 16 个数值状态,当数值稍微离开 0 以后,量化步长会呈指数级急剧扩大($0.5 \to 1.0 \to 2.0 \to 6.0$)。YOLO 预测的是物理空间连续的 BBox 边界框坐标偏移($[x, y, w, h]$)。这种粗糙的离散度会导致检测框发生剧烈的阶梯状量化抖动(Quantization Jitter),小目标特征极易因下溢归零而完全漏检,mAP 会发生 40% ~ 80% 的断崖式暴跌。LLM 能用而 YOLO 不能用的本质在于:LLM 预测的是词表分类相对概率(只需比大小,容错度极高);而 YOLO 预测的是物理空间高精度几何坐标(对局部线性平滑度要求极高)。
线性量化核心映射公式
定点量化的本质,是用离散、低位宽的定点整数(如 8 位 INT8 或 4 位 INT4)来近似表示浮点数:
$$q = \text{clip}\left(\left\lfloor \frac{x}{S} \right\rceil + Z, , q_{\min}, , q_{\max}\right)$$
反向恢复近似浮点数的反量化公式为:
$$\hat{x} = S \cdot (q - Z)$$
关键参数与符号的物理意义如下:
$x$:原始高精度浮点输入(如 FP32 / FP16 / BF16 待量化张量);
$q$:量化后的低比特整数输出(如 INT8 / INT4 定点量化值);
$\hat{x}$:反量化恢复后的近似浮点数(由于存在舍入误差,$\hat{x} \approx x$);
$S$(Scale,缩放因子):浮点物理步长,$S = \frac{x_{\max} - x_{\min}}{q_{\max} - q_{\min}}$;
$Z$(Zero-Point,零点偏移量):真实浮点数 $0.0$ 对应的定点整数索引,$Z = \text{round}\left(- \frac{x_{\min}}{S}\right) + q_{\min}$;
$\text{clip}(\cdot)$:饱和截断函数,保证数值不溢出 $[q_{\min}, q_{\max}]$。
对称量化 vs 非对称量化:数学与硬件开销的权衡
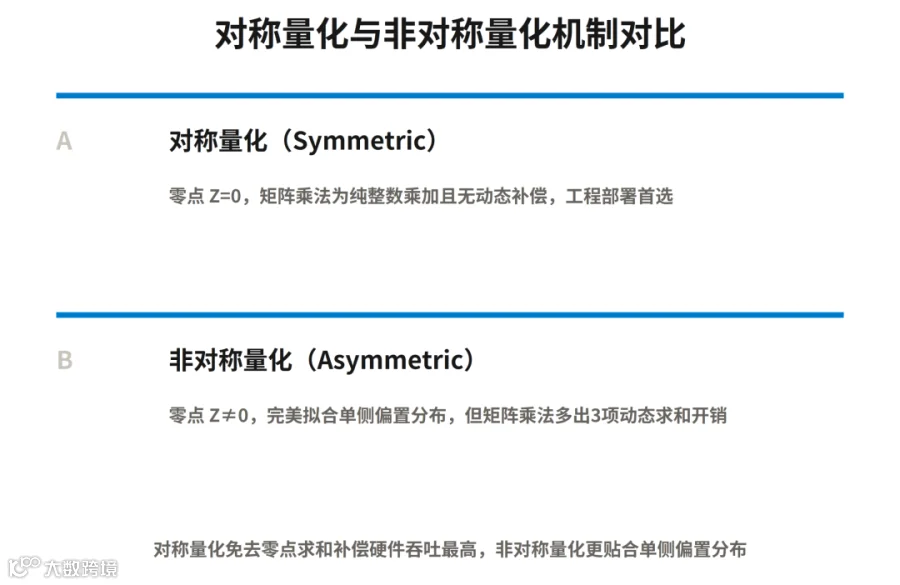
根据零点 $Z$ 是否强制为 0,量化算法被划分为两大核心流派:
1. 对称量化(Symmetric Quantization)
数学定义:强制 $Z = 0$。浮点数的对称区间 $[-\alpha, \alpha]$ 直接映射到定点整数区间 $[-127, 127]$(其中 $\alpha = \max(|x_{\min}|, |x_{\max}|)$)。
量化与反量化:$S = \frac{\alpha}{127}$,$q = \text{clip}\left(\left\lfloor \frac{x}{S} \right\rceil, -128, 127\right)$,$\hat{x} = S \cdot q$。
2. 非对称量化(Asymmetric Quantization)
数学定义:$Z \neq 0$。浮点数的实际区间 $[x_{\min}, x_{\max}]$ 完整映射到定点整数区间 $[q_{\min}, q_{\max}]$(例如 UINT8 的 $[0, 255]$)。
3. 为什么对称量化在工程部署中是绝对首选?
假设我们要计算两个量化张量的点积 $Y = X \cdot W$:
对称量化: $$\hat{Y} = (S_X q_X) \cdot (S_W q_W) = (S_X S_W) \cdot (q_X \cdot q_W)$$ 硬件只需执行极速的纯整数乘加指令($q_X \cdot q_W$),最后在外层乘上浮点常数 $(S_X S_W)$。
非对称量化: $$\hat{Y} = S_X (q_X - Z_X) \cdot S_W (q_W - Z_W) = S_X S_W \left( q_X q_W - Z_X q_W - Z_W q_X + Z_X Z_W \right)$$
非对称量化在硬件层必须额外计算并处理 3 项补偿:
1. $- Z_X \sum q_W$:权重 $W$ 静态已知,可离线预计算并折叠进 Bias 中;
2. $+ Z_X Z_W \cdot K$:完全由静态常数构成,可离线预计算;
3. $- Z_W \sum q_X$:致命动态开销。激活值 $q_X$ 随输入动态变化,硬件必须在运行时对输入特征图沿通道进行实时求和求减。
工程选型法则:
权重(Weights):几乎统一采用对称量化(均值通常在 0 附近,免除动态零点补偿);
激活值(Activations):后接 GELU、SiLU、LayerNorm 等中心对称算子时选对称量化;仅当网络充斥大量单向非负 ReLU 且硬件支持专门补偿指令时,才选用非对称量化。
总结与下篇预告
回顾本文,我们在底层确立了三个核心支柱:
1. 容器与计算解耦:SafeTensors、GGUF 与 ONNX 是存储和组织张量的容器,量化才是压缩数值与硬件加速的计算规则。
2. 浮点格式的物理分野:BF16 以超大动态范围守护 Transformer 的训练稳定,FP16 以精细尾数保障视觉几何回归,而 FP8/FP4 则通过非均匀网格重新定义了云端大模型的算力极限。
3. 对称量化的工程统治力:由于非对称量化会在运行时带来致命的动态零点求和补偿($- Z_W \sum q_X$),工业界几乎全线优先选择纯整数极速流转的对称量化。
在建立了扎实的数学公式与浮点底座之后,一个更深层的工程难题浮出水面:
在模型真正运行前,我们如何获知未知输入的特征图动态范围?
为什么朴素权重量化不需要数据,而激活量化和 AWQ/GPTQ 必须使用校准集?
量化在模型转换流水线中究竟发生在哪一步?
👉 下篇预告:第 2 篇《校准到底在校准什么?从四大量化范式到大模型与边缘感知的硬件抉择》,我们将深入剖析离群点截断机制、三大转换生命周期,并彻底看清为什么低比特浮点适合大模型却严重不适合端侧边缘芯片。
参考资料
1. IEEE Standard for Floating-Point Arithmetic (IEEE 754-2019): https://standards.ieee.org/ieee/754/6210/
2. NVIDIA FP8 Formats for Deep Learning (Whitepaper): https://developer.nvidia.com/blog/nvidia-arm-and-intel-publish-fp8-specification-for-standardization/
3. OCP Microscaling Formats (MX) Specification: https://www.opencompute.org/documents/ocp-microscaling-formats-mx-v1-0-spec-final-pdf
4. CSDN 深度学习模型量化大总结: https://blog.csdn.net/zlgahu/article/details/104662203
蘑菇头表情图片来源:蚊子动漫
— THE END —
文章仅做学术分享,如有侵权请联系删除,非常感谢!