

哈喽,大家好~
今儿和大家来聊聊AdaGrad~
先给大家举个简单的例子:比如你在爬山找最低点,每一步你会根据地形(梯度)决定走多大步。
AdaGrad 的想法是:如果某个方向的坡一直很陡(梯度很大),那我们就把该方向的步子逐渐变小;如果某个方向的坡一直比较平缓(梯度小),那我们的步子可以相对大点儿。
这样可以让学习率“自适应”地沿不同参数方向缩放,避免在某些方向上步子过大导致震荡,也能在稀疏特征上更快学习~
AdaGrad 核心逻辑
设在时间步 ,参数为 ,目标函数(损失)的梯度为 ,学习率基准为 ,累积平方梯度为 (对每个参数分别维护)。
AdaGrad 的累积规则和更新规则通常写为:
-
累积平方梯度(按元素):
-
参数更新(按元素):
其中 表示按元素相乘, 是为了数值稳定的小常数(例如 )。可以看到,每个参数都有自己独立的有效学习率
当某个参数的梯度长期很大, 会迅速变大,从而 变小;对于梯度稀疏的参数, 变慢,保持相对较大的学习率,从而加快对稀疏特征的学习。
为什么 AdaGrad 有用
我们从三方面来阐述~
对稀疏特征友好(NLP、推荐系统常见):稀疏特征在很少更新时能保持较大步幅,快速学习权重。
自适应步长:不用为每个参数单独调学习率,避免手工微调。
缺点:累积平方梯度是单调递增的(不会衰减),长时间训练会让有效学习率越来越小,可能导致早停在较差的解。为了解决这一点,后来设计了 RMSProp、Adam 等加入了指数衰减平均。
PyTorch实现
我们用一个合成数据集:二维输入 ,目标是线性回归 ,并用 AdaGrad 优化参数 。
因为只有两个权重,便于绘制损失面和参数轨迹~
import torch
import torch.nn as nn
import matplotlib.pyplot as plt
import numpy as np
import random

seed = 42
random.seed(seed)
np.random.seed(seed)
torch.manual_seed(seed)

# 1) 数据集:二维线性回归
N = 1500
# 输入在 -3 ~ 3 之间均匀分布,制造一些结构
X = np.random.uniform(-3, 3, size=(N, 2))
w_true = np.array([1.8, -2.5])   # 真正的权重
noise = np.random.normal(0, 0.8, size=(N,))
y = X.dot(w_true) + noise

# 转为 torch 张量
X_t = torch.tensor(X, dtype=torch.float32)
y_t = torch.tensor(y.reshape(-1,1), dtype=torch.float32)

# 2) 模型(线性,无偏置,便于在二维参数空间可视化)
model = nn.Linear(2, 1, bias=False)
# 初始化一个比较远的初值以便看到轨迹
with torch.no_grad():
    model.weight.copy_(torch.tensor([[ -4.0, 4.0 ]], dtype=torch.float32))

# 3) 手写 AdaGrad(便于记录 G_t 和有效学习率)
lr = 0.5
epsilon = 1e-8
num_steps = 300

# 初始化累积平方梯度 G 为 0(同参数形状)
G = torch.zeros_like(model.weight.data)  # shape (1,2)
# 记录历史
loss_hist = []
params_hist = []
G_hist = []
eff_lr_hist = []
grad_norm_hist = []

# 损失函数
mse = nn.MSELoss(reduction='mean')

for step in range(num_steps):
    preds = model(X_t)  # (N,1)
    loss = mse(preds, y_t)
    model.zero_grad()
    loss.backward()

    # 获取当前梯度(shape: 1x2)
    g = model.weight.grad.data  # 注意 grad 对 bias: None, 我们只有 weight

    # 更新累积平方梯度
    G += g * g  # element-wise

    # 记录 grad norm
    grad_norm_hist.append(torch.norm(g).item())

    # 计算按元素的有效学习率
    eff_lr = lr / torch.sqrt(G + epsilon)  # shape 1x2

    # 手动更新参数(与 torch.optim.Adagrad 等价)
    with torch.no_grad():
        model.weight.data -= eff_lr * g

    # 记录历史
    loss_hist.append(loss.item())
    params_hist.append(model.weight.data.clone().numpy().reshape(-1))
    G_hist.append(G.clone().numpy().reshape(-1))
    eff_lr_hist.append(eff_lr.clone().numpy().reshape(-1))

# 转换为 numpy 便于绘图
loss_hist = np.array(loss_hist)
params_hist = np.array(params_hist)   # shape (steps, 2)
G_hist = np.array(G_hist)
eff_lr_hist = np.array(eff_lr_hist)
grad_norm_hist = np.array(grad_norm_hist)
现在生成可视化图表:
# 1) Loss 曲线
plt.figure(figsize=(8,4))
plt.plot(loss_hist, color='magenta', linewidth=2)
plt.xlabel('Step')
plt.ylabel('MSE Loss')
plt.title('Training Loss (AdaGrad)')
plt.grid(True)
plt.tight_layout()
plt.show()

# 2) 预测 vs 真实(利用最终模型)
pred_final = model(X_t).detach().numpy().reshape(-1)
plt.figure(figsize=(6,6))
plt.scatter(y, pred_final, s=25, c='orange', alpha=0.8, edgecolor='k')
lims = [min(y.min(), pred_final.min()), max(y.max(), pred_final.max())]
plt.plot(lims, lims, '--', color='cyan')
plt.xlabel('True y')
plt.ylabel('Predicted y')
plt.title('Predicted vs True (final)')
plt.grid(True)
plt.tight_layout()
plt.show()

# 3) 参数空间的 Loss 等高线 + 参数轨迹
# 计算损失面(网格)
w1_vals = np.linspace(-6, 6, 200)
w2_vals = np.linspace(-6, 6, 200)
W1, W2 = np.meshgrid(w1_vals, w2_vals)
Z = np.zeros_like(W1)
# 计算每个参数组合下的 MSE(无偏置)
for i in range(W1.shape[0]):
    for j in range(W1.shape[1]):
        w = np.array([W1[i,j], W2[i,j]])
        preds = X.dot(w)
        Z[i,j] = np.mean((preds - y)**2)

plt.figure(figsize=(8,6))
cp = plt.contourf(W1, W2, np.log(Z+1e-8), levels=50, cmap='Spectral')  # 对数尺度更清晰
plt.colorbar(cp, label='log(MSE)')
# 画轨迹
plt.plot(params_hist[:,0], params_hist[:,1], '-o', color='lime', markersize=3, linewidth=2, label='param path')
plt.scatter([w_true[0]], [w_true[1]], c='cyan', edgecolor='k', s=100, label='true w')
plt.xlabel('w1')
plt.ylabel('w2')
plt.title('Loss Contours and Parameter Trajectory (log MSE)')
plt.legend()
plt.tight_layout()
plt.show()

# 4) 每个参数的有效学习率随时间变化
plt.figure(figsize=(8,4))
plt.plot(eff_lr_hist[:,0], label='eff lr w1', color='magenta', linewidth=2)
plt.plot(eff_lr_hist[:,1], label='eff lr w2', color='cyan', linewidth=2)
plt.xlabel('Step')
plt.ylabel('Effective LR')
plt.title('Per-parameter Effective Learning Rate (AdaGrad)')
plt.legend()
plt.grid(True)
plt.tight_layout()
plt.show()

# 5) 累积平方梯度随时间(每个参数)
plt.figure(figsize=(8,4))
plt.plot(G_hist[:,0], label='G w1', color='orange', linewidth=2)
plt.plot(G_hist[:,1], label='G w2', color='blue', linewidth=2)
plt.xlabel('Step')
plt.ylabel('Accumulated squared grad (G)')
plt.title('Accumulated squared gradients G_t')
plt.legend()
plt.grid(True)
plt.tight_layout()
plt.show()
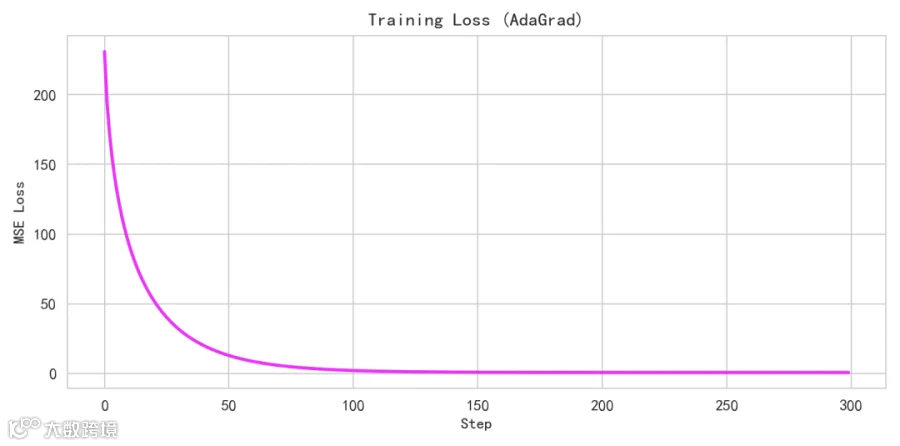
Loss 曲线
展示训练过程中的均方误差随步数的变化。
-
Loss 很快下降说明优化在初期收敛良好。 -
AdaGrad 在初期通常能快速降低损失,因为有效学习率较大;随后随着累积平方梯度增加,步长会变小,Loss 曲线会趋于平稳(可能出现“平台期”)。
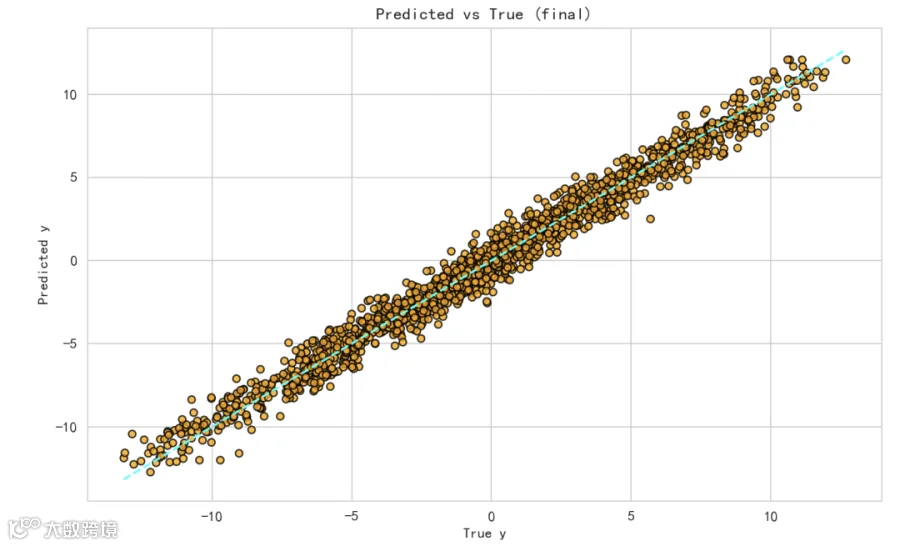
预测 vs 真实
点 (y_true, y_pred)。理想情况点应分布在对角线 附近。
-
点云聚集在对角线附近,说明模型总体拟合良好。 -
偏离较大的点反映了噪声(数据生成时带有噪声),或者模型没全部拟合(可能欠拟合)。
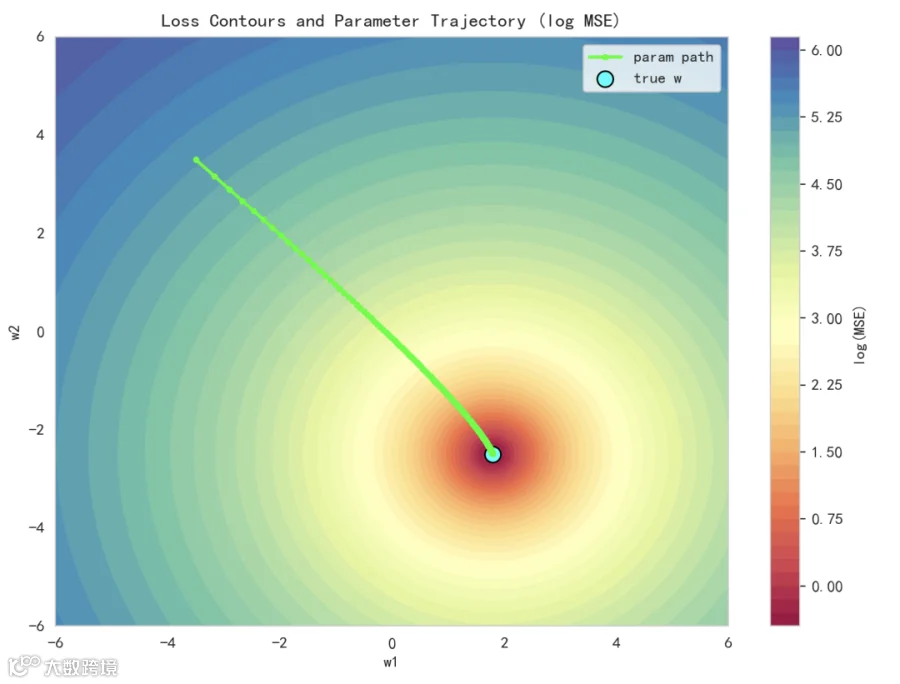
参数空间 Loss 等高线 + 参数轨迹
在 平面上绘制损失函数等高线(这里用了 显示以便更好观察),并叠加优化过程中参数的轨迹。
-
等高线通常呈椭圆形(线性回归的二次损失在参数空间中是二次型,凸面),轨迹显示从初始点逐步逼近全局最优点(true w)。 -
AdaGrad 的轨迹可能在不同方向上移动速度不同:沿梯度大方向收敛变慢(步长被缩小),沿梯度小方向可能一次跨越得快。 -
轨迹的折线、弯曲能直观反映各方向上学习率的自适应调整。
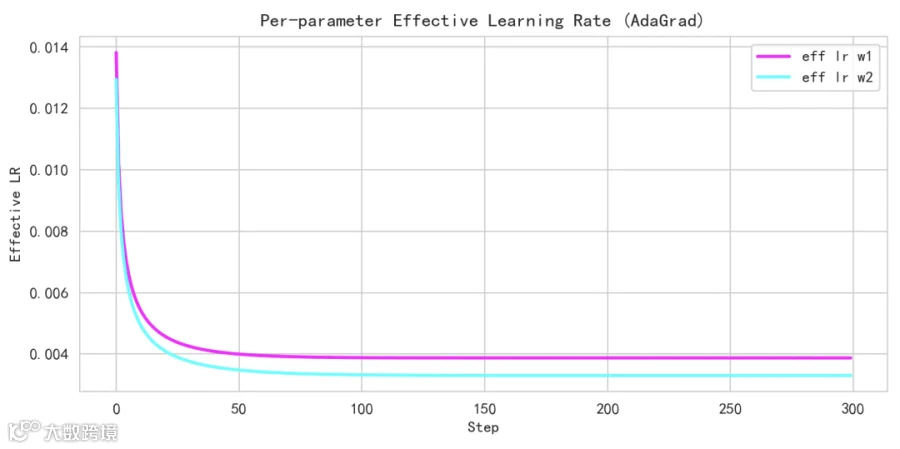
每个参数的有效学习率随时间
绘制了 对两个参数随时间的变化。
-
随着时间推移,effective LR 单调下降(因为 G_t 单调升高)。但是下降速率会随参数而异。 -
如果某个参数梯度一直很大,对应的 effective lr 会更快速变小;另一个参数梯度较小,其 effective lr 保持较大。
这就是 AdaGrad 的核心机制——对不同参数实行不同速率的缩放。
累积平方梯度随时间
绘制每个参数的 值随时间的变化(累积平方梯度)。

-
单调上升,且两个参数增长速度可能不同。 -
通过对比 的差异,可以解释为什么两个参数的有效学习率不同。
理解哪些参数“吃”掉了较多的梯度(导致步长被压小)。
总结
整体来说,AdaGrad 很适合稀疏、噪声差异大的特征场景;但对于需要长时间训练的深度学习任务,有时会导致步长过早变得极小。
RMSProp、Adam 通过指数加权移动平均来让累积项有“遗忘”机制,从而避免有效学习率单调收敛到 0 的问题。