

哈喽,大家好~
今儿和大家来梳理一下,LightGBM。
首先,LightGBM 是一种非常快、效果很好的“树模型”集合,即梯度提升树,GBDT 的工程化实现。
LightGBM 通过把很多“弱分类器”(通常是很浅的决策树)一棵一棵地串起来,每棵树负责纠正前面模型的错误,从而把弱分类器叠成强分类器。LightGBM 在训练和预测上都做了许多工程优化(比如基于直方图的分裂、按叶子生长而不是按层生长、稀疏特征优化等),因此速度更快、内存更省,适合高维、大数据场景。
01核心逻辑
决策树是把特征空间按规则切分成不同的区域,每个叶子给出一个输出(回归值或类概率)。
一棵很浅的树往往是弱分类器(效果不强)。
梯度提升 的关键思想是“逐步拟合残差”:先训练一棵树 ,再训练一棵树 去拟合目标与 的残差,依次叠加,最终预测为
其中 是学习率。
学习器的训练是以最小化损失函数为目标(比如二分类常用的对数损失),每一步根据当前模型的预测计算“伪残差”,然后用一棵新树去拟合这些残差。
LightGBM 对实现做了大量工程优化:基于直方图的近似分裂(加速和节省内存)、按叶子生长(leaf-wise)而不是按层生长以获得更低的损失、对稀疏特征和类别特征有专门处理等。
直观来说,GBDT(包括 LightGBM)就是把很多“小树”串起来,每一棵小树都在“纠前人错”。LightGBM 把这套流程做得又快又省,从而在工业界广为使用。
核心步骤
假设训练集 ,损失函数为 。梯度提升在第 步的伪残差为
然后拟合一棵基学习器 使其逼近 ,更新:
对于二分类(标签 )常用的对数似然 loss:
伪残差为 (因为负梯度等于标签与当前概率差),这也是为什么拟合残差直观上等价于把概率估计修正回来。
完整案例
首先,我们使用合成数据集,二维可分/不可分组合,例如混合同心圆 + 噪声,另外扩展成高维特征。
定义软决策树(SoftDecisionTree),每个内部节点用参数化的线性分割函数和 sigmoid 产生左右分支概率;叶子给出实数输出(logit)。
定义 BoostingClassifier:逐步训练 棵软树。每棵树用 MSE 拟合当前的伪残差(也可以直接最小化对数损失,但这里用拟合 residual 的方式更贴近 GBDT)。
在每一轮记录训练损失、验证损失、预测概率等,便于可视化~
import numpy as np
import torch
import torch.nn as nn
import torch.optim as optim
from sklearn.datasets import make_moons, make_classification
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.decomposition import PCA
from sklearn.manifold import TSNE


def make_synthetic(n_samples=5000, noise=0.25, random_state=42):
    # 非线性部分(moons)
    X1, y1 = make_moons(n_samples=n_samples//2, noise=noise, random_state=random_state)
    # 线性可分部分(高维)
    X2, y2 = make_classification(n_samples=n_samples//2, n_features=6, n_informative=3,
                                 n_redundant=1, n_clusters_per_class=1, random_state=random_state+1)
    # make_moons 默认只有 2 个特征;补充 4 个噪声特征,使两部分都为 6 列
    rng = np.random.RandomState(random_state)
    extra_dim = X2.shape[1] - X1.shape[1]
    if extra_dim > 0:
        X1 = np.hstack([
            X1,
            rng.normal(0, 0.5, size=(X1.shape[0], extra_dim))
        ])
    # stack, shift labels for balance
    X = np.vstack([X1, X2])
    y = np.hstack([y1, y2])
    # shuffle
    idx = np.random.RandomState(random_state).permutation(len(y))
    X = X[idx]
    y = y[idx]
    # scale
    scaler = StandardScaler()
    X = scaler.fit_transform(X)
    return X.astype(np.float32), y.astype(np.int64)

X, y = make_synthetic(n_samples=5000)
X_train, X_val, y_train, y_val = train_test_split(X, y, test_size=0.25, random_state=0)
我们构造了一个由两部分组成的数据集:moons(非线性,两维)和一个六维线性可分部分,合并后总维度为 8(或更多),以模拟现实中混合信号的情况。我们会用 PCA/TSNE 来可视化低维结构。
定义软决策树
一棵深度为 D 的二叉树有 内部节点和 叶子。每个内部节点 k 使用参数向量 ,计算分裂概率 ,到达某个叶子的路径概率为内节点左右分支概率的乘积;叶子 j 有输出值 (标量)。整棵树的输出为叶值的加权和。
class SoftDecisionTree(nn.Module):
    def __init__(self, input_dim, depth=3):
        super().__init__()
        self.input_dim = input_dim
        self.depth = depth
        self.num_internal = 2**depth - 1
        self.num_leaves = 2**depth
        # internal node linear params
        self.w = nn.Parameter(torch.randn(self.num_internal, input_dim) * 0.1)
        self.b = nn.Parameter(torch.zeros(self.num_internal))
        # leaf outputs (logits)
        self.v = nn.Parameter(torch.randn(self.num_leaves) * 0.1)

    def forward(self, x):
        # x: (N, D)
        N = x.shape[0]
        # compute p for internal nodes
        logits = torch.matmul(x, self.w.t()) + self.b  # (N, num_internal)
        probs = torch.sigmoid(logits)  # probability go to right child (for example)
        # compute leaf path probabilities
        # leaves indexed 0..num_leaves-1, binary code gives left/right on each depth
        path_probs = x.new_ones(N, 1)  # start with 1
        leaf_probs = []
        for depth_level in range(self.depth):
            nodes_start = 2**depth_level - 1
            nodes_end = 2**(depth_level+1) - 1
            p_level = probs[:, nodes_start:nodes_end]  # (N, 2^depth_level)
            # for each existing path, expand to left and right
            if depth_level == 0:
                path_probs = torch.cat([path_probs * (1 - p_level), path_probs * p_level], dim=1)  # (N,2)
            else:
                # previous path_probs has size (N, 2^(depth_level))
                left = path_probs * (1 - p_level)
                right = path_probs * p_level
                path_probs = torch.cat([left.reshape(N, -1), right.reshape(N, -1)], dim=1)
        # path_probs now has shape (N, num_leaves)
        leaf_out = torch.matmul(path_probs, self.v)  # (N,)
        return leaf_out, path_probs  # return also path probabilities for explainability
为了可解释性,我们也返回了 path_probs(到每个叶子的概率),用于画图或计算特征重要性。注意这是“软”路径(概率乘积),因此整棵树对参数是可微分的。
定义 BoostingClassifier
训练策略:对于二分类,我们使用 log-loss。在第 m 步,我们把当前模型输出 F^(m-1)(x),计算概率 p = sigmoid(F),伪残差 r = y - p,将下一棵树拟合 r(用 MSE)。
训练每棵树时我们在若干 epochs 内用 Adam 优化叶值和分裂参数,最终按学习率 eta 累加到总体模型。
class BoostingClassifier:
    def __init__(self, input_dim, n_estimators=10, tree_depth=3, lr_tree=0.05, eta=0.1, device='cpu'):
        self.input_dim = input_dim
        self.n_estimators = n_estimators
        self.tree_depth = tree_depth
        self.lr_tree = lr_tree
        self.eta = eta
        self.device = device
        self.trees = []

    def fit(self, X_train, y_train, X_val=None, y_val=None, tree_epochs=200, batch_size=256):
        X = torch.from_numpy(X_train).to(self.device)
        y = torch.from_numpy(y_train).float().to(self.device)
        N = X.shape[0]
        F = torch.zeros(N, device=self.device)  # initial logit
        val_F = None
        history = {'train_loss': [], 'val_loss': [], 'per_tree_val': []}
        for m in range(self.n_estimators):
            # pseudo residual (negative gradient)
            p = torch.sigmoid(F)
            residual = (y - p).detach()  # target to fit
            # train a soft tree to fit residual
            tree = SoftDecisionTree(self.input_dim, depth=self.tree_depth).to(self.device)
            optimizer = optim.Adam(tree.parameters(), lr=self.lr_tree)
            for ep in range(tree_epochs):
                optimizer.zero_grad()
                pred, _ = tree(X)
                loss = ((pred - residual)**2).mean()
                loss.backward()
                optimizer.step()
            # after training, add scaled tree to ensemble
            self.trees.append(tree)
            with torch.no_grad():
                pred_train, _ = tree(X)
                F = F + self.eta * pred_train
                # compute losses
                train_loss = - (y*torch.log(torch.sigmoid(F)+1e-9) + (1-y)*torch.log(1-torch.sigmoid(F)+1e-9)).mean().item()
                history['train_loss'].append(train_loss)
                if X_val is not None:
                    Xv = torch.from_numpy(X_val).to(self.device)
                    yv = torch.from_numpy(y_val).float().to(self.device)
                    # compute val F incrementally
                    if val_F is None:
                        val_F = torch.zeros(Xv.shape[0], device=self.device)
                    pred_val, _ = tree(Xv)
                    val_F = val_F + self.eta * pred_val
                    val_loss = - (yv*torch.log(torch.sigmoid(val_F)+1e-9) + (1-yv)*torch.log(1-torch.sigmoid(val_F)+1e-9)).mean().item()
                    history['val_loss'].append(val_loss)
                    history['per_tree_val'].append(torch.sigmoid(val_F).cpu().numpy())
                else:
                    history['val_loss'].append(None)
            print(f"Tree {m+1}/{self.n_estimators}, train loss: {train_loss:.4f}, val loss: {history['val_loss'][-1]}")
        self.history = history

    def predict_proba(self, X_np):
        X = torch.from_numpy(X_np).to(self.device)
        F = torch.zeros(X.shape[0], device=self.device)
        with torch.no_grad():
            for tree in self.trees:
                pred, _ = tree(X)
                F = F + self.eta * pred
            p = torch.sigmoid(F).cpu().numpy()
        return np.vstack([1-p, p]).T  # (N,2)

    def predict(self, X_np):
        p = self.predict_proba(X_np)[:,1]
        return (p>0.5).astype(int)
说明:每棵树内部我们用 Adam 训练若干 epochs 来拟合残差。真实的 LightGBM 会用树算法直接拟合残差,但这里的软树更容易可视化参数如何改变。
训练模型并可视化
训练并记录中间预测(history['per_tree_val'] 保存了每棵树后的验证概率演化):
model = BoostingClassifier(input_dim=X.shape[1], n_estimators=12, tree_depth=3, lr_tree=0.05, eta=0.2, device='cpu')
model.fit(X_train, y_train, X_val=X_val, y_val=y_val, tree_epochs=120)
训练/验证损失曲线:
plt.figure()
plt.plot(model.history['train_loss'], '-o', color='crimson', label='Train loss')
plt.plot(model.history['val_loss'], '-s', color='royalblue', label='Val loss')
plt.xlabel('Number of trees')
plt.ylabel('Log loss')
plt.title('Learning curve (log-loss)')
plt.legend()
plt.grid(True)
plt.show()
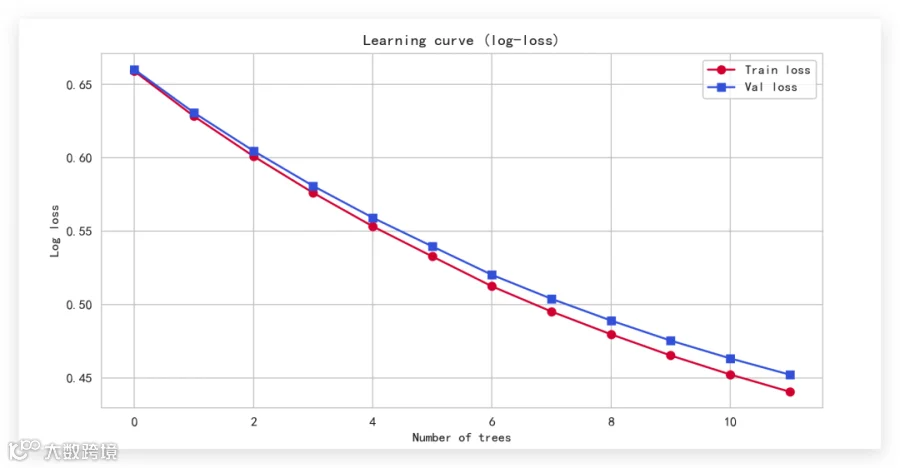
观察随着树的增加损失是否下降、是否过拟合~
决策边界:
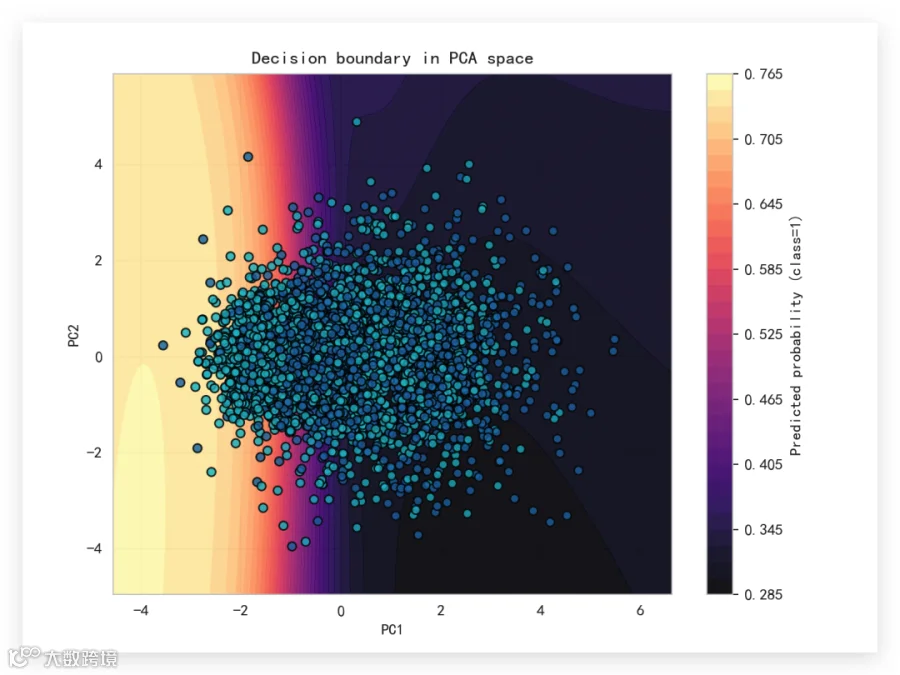
我们用 PCA 将数据投到二维,然后在二维平面上网格预测概率并画等高(决策边界)。
pca = PCA(n_components=2)
X_pca = pca.fit_transform(X)
Xp_train_pca = pca.transform(X_train)
Xp_val_pca = pca.transform(X_val)

# grid
xx, yy = np.meshgrid(np.linspace(X_pca[:,0].min()-1, X_pca[:,0].max()+1, 300),
                     np.linspace(X_pca[:,1].min()-1, X_pca[:,1].max()+1, 300))
grid = np.column_stack([xx.ravel(), yy.ravel()])
# need to map grid back to original feature space approx: use inverse_transform
grid_orig = pca.inverse_transform(grid).astype(np.float32)
proba_grid = model.predict_proba(grid_orig)[:,1].reshape(xx.shape)

plt.figure(figsize=(8,6))
cs = plt.contourf(xx, yy, proba_grid, levels=30, cmap='magma', alpha=0.9)
plt.colorbar(cs, label='Predicted probability (class=1)')
plt.scatter(Xp_train_pca[:,0], Xp_train_pca[:,1], c=y_train, cmap='tab10', edgecolor='k', s=30, alpha=0.8)
plt.title('Decision boundary in PCA space')
plt.xlabel('PC1'); plt.ylabel('PC2')
plt.show()
展示模型对样本空间的概率估计~
每棵树后验证集预测概率的演化热图:
显示模型如何逐步把预测拉向正确端,我们把 history['per_tree_val'](shape: n_trees x n_val)用热图展示(每列一个样本,每行一个树),并按真实标签排序样本以便观察:
per_tree_val = np.array(model.history['per_tree_val'])  # (n_trees, n_val, ) values are probabilities
# sort by true label and by probability in last step for clarity
order = np.argsort(y_val)
per_tree_val_sorted = per_tree_val[:, order]

plt.figure(figsize=(12,4))
sns.heatmap(per_tree_val_sorted, cmap='cubehelix', cbar=True)
plt.xlabel('Validation samples (sorted by label)')
plt.ylabel('Tree index (1..M)')
plt.title('Prediction probability evolution on val set — 每棵树后的概率逐步变化')
plt.show()
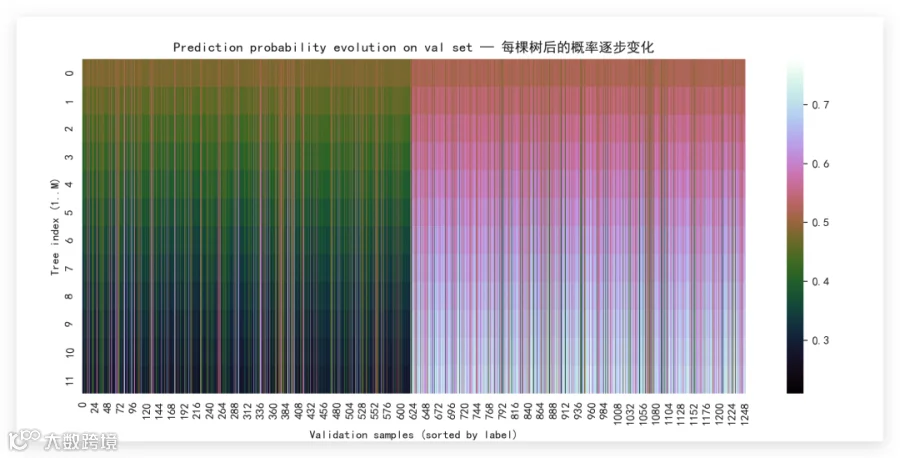
热图显示每棵树如何修正样本的预测~
残差 / 概率分布与 t-SNE 可视化:
用 t-SNE 将高维样本嵌入二维,并用预测概率着色,展示概率在嵌入空间的分布;同时绘制残差直方图。
# t-SNE 可视化
tsne = TSNE(n_components=2, random_state=0, perplexity=40, n_iter=800)
X_tsne = tsne.fit_transform(X_val)

probs_val = model.predict_proba(X_val)[:,1]
residuals = y_val - probs_val

plt.figure(figsize=(12,5))
plt.subplot(1,2,1)
plt.scatter(X_tsne[:,0], X_tsne[:,1], c=probs_val, cmap='Spectral', s=40, edgecolor='k', alpha=0.9)
plt.colorbar(label='Predicted prob (class=1)')
plt.title('t-SNE of val data colored by predicted probability')
plt.subplot(1,2,2)
plt.hist(residuals, bins=30, color='limegreen', edgecolor='k')
plt.title('Residual distribution (y - p)')
plt.xlabel('Residual')
plt.show()
左图显示模型在数据嵌入空间的置信分布,右图显示残差分布(是否偏向某侧)

事实上,真实的 LightGBM 使用基于直方图的贪心分裂和按叶子生长(leaf-wise)策略,能在大规模数据上快得多。
机器学习工程中,LightGBM 常用场景:表格数据、类别特征、稀疏输入、需要快速训练与调参的场景(比如竞赛、推荐、搜索排序)。
若数据是图像/序列/多模态且需要端到端表征学习,神经网络可能更合适;也可以把 LightGBM 与深度特征结合:先用神经网络提取特征,再用 LightGBM 做最终分类/排序。
总结
LightGBM 是高效的梯度提升树实现,适合表格数据的大多数任务。
核心思想:逐步拟合残差,把许多弱树叠加成强模型。
实际工程中直接用 LightGBM 更高效,但理解其底层机制(残差 + 分裂 + 叶子输出)对调参与诊断模型非常有帮助。