大家好,我是Tony Bai。
【导读】
2026年9月,由OpenAI“ChatGPT共同发明人”Diogo Almeida创立的TypeSafe AI高调发布Jev模型,将“非自回归决策模型”包装为一次范式级突破,并拿下4000万美元种子轮融资。然而几乎在同一时间,一位名叫Nandakishor Mukkunnoth的独立研究者在Hacker News上贴出了一篇措辞激烈的博客:他早在2025年3月就发表了同样思路的arXiv论文,开源了模型权重和数据集,只是当时无人问津。这场关于“是谁先做出来的”的争论,在HN上迅速演变成一场关于开源精神、学术优先权与资本话语权的公开辩论。
【文章要点】
-
Jev是什么:TypeSafe AI发布的“System 1决策模型”,不生成文本,只输出带校准概率的结构化决策(choice / score / noul三种原语),号称比传统LLM快百倍、便宜数百倍 -
争议起点:独立研究者Nandakishor Mukkunnoth在博客中列出完整时间线——2025年3月arXiv论文、开源权重、Reddit讨论帖,声称自己才是“元老” -
他的应对方式很硬核:不止是喊话,而是直接做出了开源版本Laya,并在多项基准上宣称超越Jev(推理延迟快7.8倍、支持100+种语言、完全开源免费) -
HN网友的态度分裂:有人认为这不过是“套壳BERT”炒热点,有人认为两者可能是独立撞车的“多重发现”,也有人质疑Laya作者单方面说法难以核实 -
深层问题:这场争论触及的不只是谁先谁后,而是开源研究者与资本化明星创业公司之间长期存在的“注意力不对等”
一条“酸味十足”的标题,引爆了HN
如果要给2026年9月的AI圈评选一条“最扎心标题”,这条大概能排进前三:
《I Built Non-Autoregressive Decision Models with RL a Year Ago. Then a Frontier Lab Called It a "Breakthrough".》 (《一年前我就用强化学习做出了非自回归决策模型,然后一家头部实验室把它叫做“突破”》)
写下这行标题的人,是印度籍独立研究者、ConvAI Innovations创始人Nandakishor Mukkunnoth。他的博客文章连同项目Laya一起,被投到了Hacker News,标题被网友精简为一句更直接的话:
"Laya the open source version of Jev"(Laya:Jev的开源版)
短短一小时内,这条帖子拿到了数十个5点赞和评论,讨论迅速从“这个模型好不好用”滑向了一个更敏感的话题:Jev所谓的“突破性架构”,到底是不是全新的东西?
Jev是什么:一次高调的“System 1”叙事
要理解这场争论,得先搞清楚Jev是什么。
2026年9月15日,TypeSafe AI高调结束隐身模式,发布了首款模型Jev。这家公司由前OpenAI研究员Diogo Almeida创立,他的身份标签相当唬人——官方团队页面称其“共同发明了RLHF和InstructGPT,正是这些方法催生了ChatGPT和GPT-4”。
Jev最大的卖点,是它彻底放弃了“像人一样说话”这件事。它不聊天、不写文章、不生成代码,只做一件事:在结构化任务上给出一个带校准概率的决策。TypeSafe把这类模型命名为“System 1模型”,灵感来自诺贝尔奖得主丹尼尔·卡尼曼在《思考,快与慢》中提出的概念——System 1是快速直觉式的反应,System 2才是缓慢深思的推理。TypeSafe创始人Almeida认为,现有大模型带着思维链和数秒级的推理过程,牢牢地站在System 2这一边,而多数软件决策其实只需要一个快速的System 1式答案。
架构上,Jev确实与传统Transformer大模型有明显区别:它使用一种带并行采样器的新架构,在单次查询中一次性生成所有输出,而不是像自回归模型那样逐词生成,训练方法则是TypeSafe称为“用于校准决策的强化学习”(RLCD)的方法。
发布当天,TypeSafe同时官宣了一轮由DCVC领投的4000万美元种子轮融资。多家科技媒体给出的评测数据也颇为惊人:号称在分类任务上比Claude Sonnet 5快193倍,比Opus 5便宜444倍。
但争议也随之而来——Jev是完全闭源的。它不开放模型权重,没有发表技术论文,也没有公开训练数据集,只以付费API的形式提供服务,定价为每百万输入token 0.042美元。
时间线对照:从2025年3月到2026年9月
Nandakishor Mukkunnoth在博客中给出了一份相当详尽的“证据链”,试图证明这条技术路线他早就走过一遍。以下是根据Laya官网整理的完整时间线:
-
2025年3月:Mukkunnoth发表arXiv论文2503.23303,提出用PPO强化学习训练序列转化轨迹模型,在Hugging Face开源模型权重与数据集,在Reddit r/LocalLLaMA发帖分享; -
2025年:发布PyPI包,供开发者直接调用; -
2025年9月:发表第二篇arXiv论文2510.01237,正式提出"基于强化学习指导的模式化决策"框架; -
2026年9月15日:TypeSafe AI发布Jev,提出RLCD训练方法与并行采样架构,完成4000万美元种子轮融资。 -
2026年9月:Mukkunnoth发布Laya,开源三个专用checkpoint并全面对比Jev,登上Hacker News引发讨论。
按照Mukkunnoth自己的说法,他这套系统最早是应用在销售话术转化率预测这样一个相当“接地气”的场景:用PPO(近端策略优化)在一段对话的每一轮上,输出一个0到1之间的转化概率。而Jev所做的,本质上是把这个思路“横向”泛化——不再是预测一条时间序列上的概率轨迹,而是在多种预先定义好的结构化“题型”(选择、打分、判断)上,一次性给出带校准置信度的答案。
用他自己的话说,两者的核心驱动都是强化学习,而不是简单的embedding模型或自回归大模型套壳。
反击方式很硬核:不止是嘴炮,还有一个开源项目
如果这篇博客只是停留在“抢首创权”的层面,大概率不会引起太大水花。真正让HN网友愿意认真讨论的,是Mukkunnoth紧接着甩出的东西——一个完全开源、且号称在多项指标上碾压Jev的模型:Laya。
Laya的核心卖点可以概括为一句话:用双向编码器(bidirectional encoder),而不是自回归架构,在单次前向传播中同时回答多个结构化问题。
它设计了三种“决策原语”:
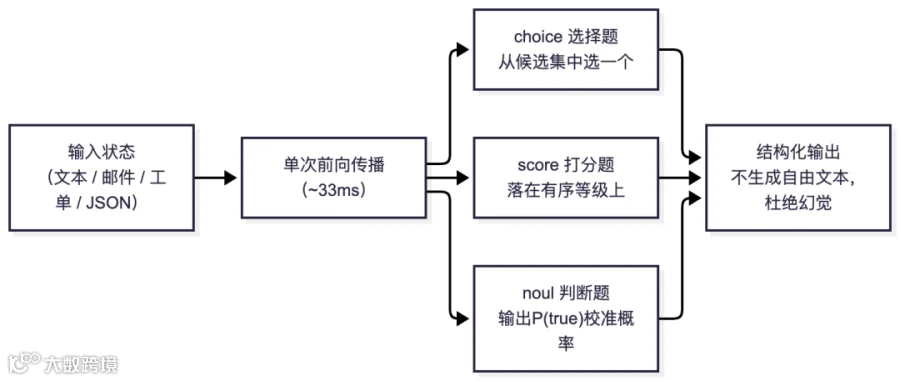
由于输出空间被严格限定为概率和数字,模型不会生成自由文本,也就从架构层面杜绝了“格式错乱”、“JSON解析失败”这类自回归模型常见的痛点。
Laya还内置了一套语言路由机制:通过检测输入文本的Unicode字符集,在不到1毫秒的时间内判断应该调用哪个专用checkpoint,从而覆盖100多种语言。官网给出的一组数据颇具警示意义——针对高棉语(Khmer)输入,英文checkpoint的判断准确率是0%,但模型给出的平均置信度却高达95.2%。这说明单纯依赖模型自身的置信度,根本无法判断它是不是在“胡乱猜测”,路由决策必须在前向传播之前就做出。
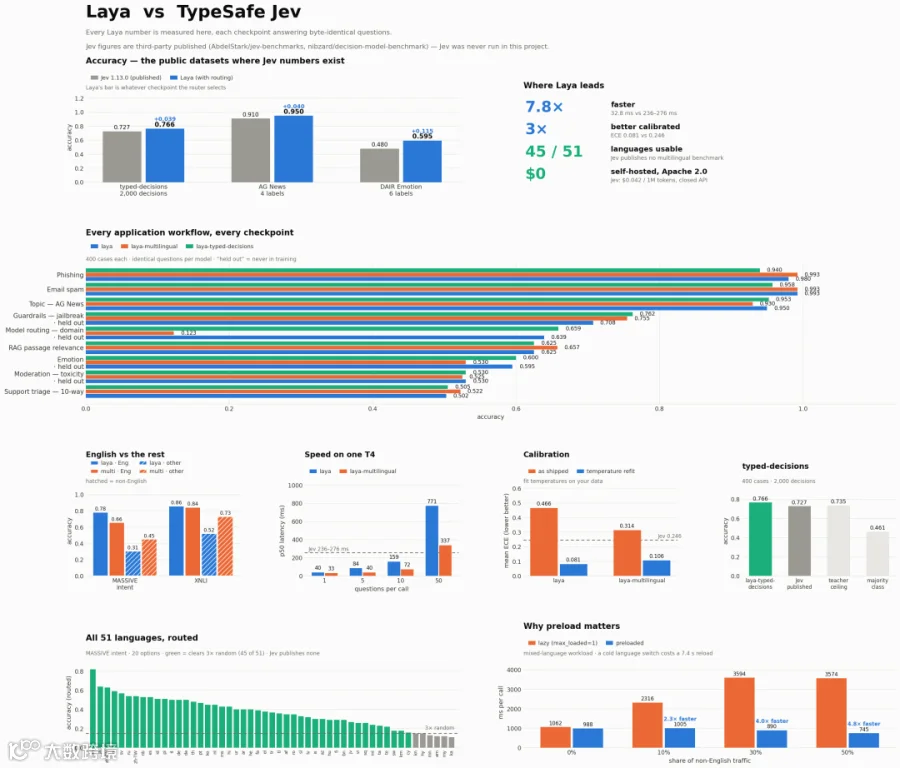
硬核对比:Laya vs Jev,数据打到明面上
Laya官网给出了一份详细的对比表格,需要说明的是:Laya一侧的数据由作者自行测得,Jev一侧的数据部分来自TypeSafe官方,部分来自第三方独立评测,尚未经过交叉验证。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
从这份表格不难看出Laya想传达的信号:同样的思路,开源版本反而在多数指标上跑赢了融资4000万美元的闭源商业版本。当然,Laya官网自己也坦诚列出了短板——比如在超过20个候选项的选择题任务(Banking77基准,77个标签)上,Laya的准确率只有0.425,远低于Jev的0.870,原因是架构上每个候选项分到的token预算太少。这种“既晒优势也晒短板”的态度,也是这篇博客在HN上获得不少好感的原因之一。
HN众生相:三种声音的交锋
真正让这场讨论变得有价值的,其实是评论区里出现的三种截然不同的立场,比原文本身更值得细品。
第一种声音:技术圈老兵的“祛魅”式吐槽。
有网友表示自己实测过Jev,用在原本由Gemini 2.5 Flash Lite处理的分类任务上,速度和成本确实有优势,一致性也不错,但作为一名“LLM时代之前就在训练NLP模型”的从业者,他的判断是——这本质上就是喂了更多数据的BERT,谈不上什么突破,预计很快会被各大实验室复现并纳入自家工具链。
第二种声音:撞车经历的“同病相怜”。
另一位网友的留言颇具戏剧性:他表示自己一年前就为客户做过类似的东西,当时也觉得没什么了不起,客户买单、用到现在,仅此而已。看到Jev发布后引发的关注度,他反而受到刺激,动手做了一个开源库OpenDecision,底层模型支持8k上下文长度。
第三种声音:更谨慎的中立派。
也有网友直接指出了Laya的软肋——它的checkpoint上下文长度只有512到1024 token,而Jev据称支持32k上下文,这是一个相当大的差距,却在原文的对比表格中没有被充分强调。还有网友提出了一个更本质的疑问:Jev和表格型基础模型(tabular foundation model)在应用场景上高度重合,这类模型到底学到了什么?可解释性问题在机器学习领域一直悬而未决。
而对于最核心的“谁先谁后”问题,评论区的态度也是分裂的。有人认为,既然Mukkunnoth把论文、权重、数据集全部公开,“可以拿到台面上验证”,这本身就比一份公关通稿更值得信任;但也有人提醒,目前并没有证据表明TypeSafe看过或参考过Mukkunnoth的研究,更合理的解读或许是——这是一次典型的“多重独立发现”(multiple independent discovery),历史上这种现象在科学史上并不罕见,只是背后的资源与关注度天差地别。
谁先谁后:一桩难以取证的技术优先权公案
坦白说,这场争论最终很难有一个“盖棺定论”的答案。
Mukkunnoth的证据链是完整且可验证的:两篇arXiv论文、公开的Hugging Face权重、开放数据集、PyPI包、Reddit讨论帖——时间戳都摆在那里,任何人都可以去查证。但这些证据只能证明他确实早就做了类似的东西,却无法证明TypeSafe团队“知道”这些工作的存在,更谈不上“抄袭”。
而TypeSafe这边,目前尚未就此事公开回应,Jev本身也没有发表技术论文,外界甚至无从判断它的具体架构细节是否与Mukkunnoth的方案高度重合,还是仅仅共享了“非自回归+强化学习+结构化决策”这个大方向。
一位HN网友的评论或许概括得最中肯:这更可能是两个团队各自独立走到了同一个技术路口,实现细节未必相同;但即便如此,头部创业公司在做重大宣发之前,理应对相关领域的现有研究做更充分的检索,这是学术诚信和行业礼貌的基本要求,而不是营销话术的技术细节。
小结:比“谁发明的”更重要的问题
这场围绕Jev与Laya的争论,表面上是一场关于技术优先权的口水仗,但真正值得回味的,或许是它折射出的一个更普遍的现象:同一个想法,由谁在什么位置上讲出来,命运可能天差地别。
一位没有融资、独立打磨了一年多的研究者,把论文、权重、数据集、代码全部开源出来,却几乎无人问津;而一位带着“ChatGPT共同发明人”光环、拿到4000万美元融资的创始人,把相似的思路包装成“突破性架构”,第一天就登上各大科技媒体的头条。
这不是AI行业第一次出现这种“注意力错配”,恐怕也不会是最后一次。
对独立研究者而言,这次事件也提供了一个相对健康的应对范例——与其停留在情绪化的控诉,不如把技术摊开来,用可复现的开源方案和硬核的基准数据说话。至于Jev与Laya究竟谁的架构更胜一筹,或许交给时间和更多的独立复现者来验证,会是更公平的裁判方式。
参考资料:
-
Laya官网:https://laya.convaiinnovations.com -
Hacker News讨论帖:https://news.ycombinator.com/item?id=49765348 -
Mukkunnoth arXiv论文:arXiv:2503.23303、arXiv:2510.01237
如果本文对你有所帮助,请帮忙点赞、推荐和转发 !
点击下面标题,阅读更多干货!
- 刚刚,TypeSafe 发布“反 LLM”新物种 JEV:0.1 秒出结果、宣称零幻觉、比大模型便宜上百倍
- 开源杀出重围!OpenAI 亲述:如何把Codex变成谁都能装进产品里的“智能体引擎”
- MIT史上最重磅教育报告出炉:AI正在瓦解大学的“社会契约”
- CUDA 编程模型:指挥“千军万马”的线程艺术
- 英伟达亲自下场:CUDA 原生支持 Rust 了!但“纯 Rust AI 技术栈”,还差一堵墙
- Go 核心团队放大招:cgo 不用 C编译器也能跑,AI/GPU 库调用将迎来大简化
- 十四年磨一剑:Go 标准库encoding/json/v2 演进全史
🔥 还在为“复制粘贴喂AI”而烦恼?我的新极客时间专栏 《AI原生开发工作流实战》 将带你:
-
告别低效,重塑开发范式 -
驾驭AI Agent(Claude Code),实现工作流自动化 -
从“AI使用者”进化为规范驱动开发的“工作流指挥家”
扫描下方二维码👇,开启你的AI原生开发之旅。