

📝 英文题目:Tool or tutor? A dynamic assessment-informed comparison of pedagogical AI agents and general-purpose GenAI for EFL speaking development and anxiety
📚 来源期刊:System
🗓 发表时间:2026-11-01
✍ 作者:Lin Chih-Chung, Lin Vivien
🏆 期刊等级:JCR Q1 · 中科院 文学1区 · TOP 文学TOP · SSCI Q1 · Scopus
📌 本文看点
01
动态评估 (dynamic assessment)
02
教学 AI 智能体 (PAIA)
03
生成式 AI (GenAI)
BACKGROUND
研究背景
问题提出
在全球化高教环境里,英语口语被普遍视作参与学术活动和未来职业流动的门票。但对 EFL 学习者、尤其是低成就本科生来说,口语始终是语言学习中最难、也最让人焦虑的一环:口语任务中反复卡壳、又缺少持续且有支持的练习机会,会形成持续性的口语焦虑,进而抑制课堂参与、限制口语能力发展(Tien, 2018)。 AI 中介的口语练习因此被越来越多地用来把「说英语的机会」延伸到课堂时间之外,综述也报告了 chatbot 支持语言学习的总体正面效果(Ding & Yusof, 2025;Wu & Li, 2026;Zhang et al., 2023)。但更多 AI 互动 ≠ 有教学意义的口语发展。已有研究提示:AI 支持的口语活动高度设计敏感——互动质量、反馈时机、教学整合方式,共同决定重复练习是通向真实发展,还是停留在表层参与(Du & Daniel, 2024;Li et al., 2024)。所以对低成就学习者,核心问题不是「AI 能不能提供更多开口的机会」,而是「AI 中介的互动能不能提供发展上适配的支持,帮助学习者扩展、修复并调控自己的口语产出」。 这引出一个更具体的对比:通用 GenAI(如 ChatGPT)是工具——你问它才答,答得快也答得完整;而按动态评估设计的教学 AI 智能体 (PAIA) 是导师——它会诊断你卡在哪,并按你的反应逐级给出提示。这两种形态在真实课堂里到底差多少,此前缺一整个学期的实证证据。
难点剖析
难点有四:(1) 可用性—深度悖论(usability–depth paradox)。大学生随手就能用 ChatGPT 写口语稿、改语法、模拟对话,这些便利确实支持计划与演练;但在没有引导时,学习者可能直接照搬 AI 生成的语言而不评估、不改写——这就是替代性认知卸载(Risko & Gilbert, 2016;Du & Daniel, 2024;Waluyo & Kusumastuti, 2024;Zhai et al., 2024)。对语言资源本就不足、判断 AI 输出好坏的能力也更弱的低成就学习者,这个风险尤其致命。
(2) 「中介」而非「给答案」的设计难。从动态评估视角,关键区分是:AI 反馈只是帮你完成这一次任务,还是通过依随的、渐进的支持去中介你发展中的能力(Lantolf & Poehner, 2014;Poehner, 2008)。要做到后者,得把 Aljaafreh & Lantolf (1994) 的调节量表真正写进系统——先隐含提示、再引导性问题、再部分改述,扣住最终范例直到学习者穷尽自我修复尝试。
(3) 口语焦虑的双向可能。DA 式中介会让学生「注意到自己的错误」,这可能一开始抬高焦虑;但它同时让任务预期更清楚、进步更可见,又可能逐步降压。两种可能性互相竞争,光靠理论裁决不了,需要课堂证据。
(4) 学期长度与准实验约束。短期、单次任务的设计分不清「暂时的表现提升」和「更稳定的发展变化」——而元分析恰恰显示干预时长会调节学习效果(Wu & Li, 2026)。同时受限于行政安排只能整班分配、不能随机分组,就必须靠同一教师、同一大纲、同一活动加统计协变量去尽量压掉替代解释。
理论脉络
理论锚在三条线上:① 社会文化理论 (SCT) 与最近发展区 (ZPD)。二语发展被理解为中介过程:学习者的认知与语言能力在与他人、与文化工具的互动中涌现(Vygotsky, 1978)。ZPD 是学习者在更有知识者 (MKO) 协助下能够超出其独立水平的表现空间;学习不是语言形式的累积,而是通过依随的、互动根植的支持逐步走向自我调控(Lantolf, 2000;Lantolf et al., 2015)。延伸到 AI 场景:同一套底层技术,可以只是「语言资源」,也可以在围绕教学 contingencies 被显式设计后成为「教学中介者」。对低成就学习者,光给正确形式不够——流利的 GenAI 输出可能只是一个外部成品 (external product),而不是中介过程;学习者拿到了正确范例,却未必学会诊断自己的错误、修改产出、内化修复策略。
② 情感过滤假说 (Affective Filter Hypothesis)。动机、自信、焦虑调节语言输入被加工为 intake 的程度(Krashen, 1982, 1985)。口语尤其突出——实时加工、错误即时暴露、被社会评价。心理安全重要的原因不只是「让人舒服」,而是决定学习者愿不愿意参与这个有风险、费力的口语产出过程。而且焦虑来源不只是怕被负面评价,还包括「不知道下一句怎么说、怎么修复卡壳、怎么理解纠正性反馈」。这带来一个方法含义:前测焦虑水平本身可能调节干预效果,所以焦虑不能只当后测结果看。
③ 动态评估 (DA) 与调节量表。DA 关心的不是一次性表现提升,而是学习者对中介的 responsiveness 与逐步走向自我调控(Lantolf & Poehner, 2014;Poehner, 2008)。Aljaafreh & Lantolf (1994) 的调节量表提供了操作化阶梯:从非特定的隐含提示到明确的示范逐级递进。相关实证与综述也提示:干预时长会调节效果(Wu & Li, 2026),而学习效果不只取决于工具,还取决于教学整合、课堂编排与教师能动性(Ji et al., 2023;Lan & Chen, 2024)。
METHOD
研究方法
理论模型
两种 AI 模态的功能区分(Table 1)+ DA 中介的调节阶梯(Fig. 2)。 ① 通用 GenAI(ChatGPT,默认配置)= 工具 (Tool) - 教学取向:学习者发起的辅助 (learner-initiated assistance) - 互动结构:开放式、用户发起 - 反馈功能:按请求提供答案、纠正或范例 - 支架:可选,且取决于学习者会不会问 - 中介序列:往往即时且明确 - 错误处理:被要求时才纠正 - 情境敏感性:回应局部 prompt,不调节整体学习轨迹 - 学习者调控:高度依赖自我调控 - 与 ZPD 的对齐:间接且不一致 - 预期影响:支持演练、词汇检索与表层流利;通过私密互动降低评价压力 ② DA 导向的教学 AI 智能体 (PAIA) = 导师 (Tutor) - 教学取向:系统引导的中介 (system-guided mediation) - 互动结构:结构化、系统引导 - 反馈功能:诊断学习者困难并中介发展 - 支架:基于学习者反应的自适应支架 - 中介序列:从隐含提示渐进到明确支持 - 错误处理:把错误当作自我修复的机会 - 情境敏感性:按任务需求、学习者产出与卡壳类型调整 - 学习者调控:通过提示、修复循环与引导性反思来支持 - 与 ZPD 的对齐:明确设计为在 ZPD 内运作 - 预期影响:支持阐述、复杂度、任务完成度与策略性修复;通过结构化指导、可预测性与可见进步来调节焦虑 ③ PAIA 的调节阶梯(Aljaafreh & Lantolf, 1994;Fig. 2) 学习者产出卡壳 → 先给元认知提示(例:Can you expand on your reason?)→ 仍卡住则给引导性问题或部分改述 → 扣住最终纠正性范例,直到学习者穷尽自我修复尝试。核心是:中介依随于学习者的反应,而不是立刻奉上正确脚本。值得强调的是,两组底层用的是同一个模型(经 OpenAI API 的 GPT-4o),差别只在中介逻辑的设计——这正是对「工具 vs 导师」最干净的一次对照。 ④ 认知卸载与元认知税。认知卸载分战略性(拿 AI 查词、查语法、做计划,但学习者仍负责评估与修改产出)与替代性(照搬 AI 的流利语言,却不转化为自己的口语产出)。通用 GenAI 的开放性还会额外加征一层作者命名的元认知税 (metacognitive tax):学习者必须自己决定要什么支持、怎么评估 AI 反馈、怎么把反馈变成自己的口语产出——而这恰好是低成就学习者最缺的能力。
研究问题与分析策略
本研究为准实验设计,作者以研究问题 (RQ) 而非形式化假设提出;以下为两个研究问题与三条分析主轴。 研究问题: - RQ1:DA 导向的 PAIA 能否比通用 GenAI 更好地支持低成就 EFL 本科生的英语口语表现? - RQ2:AI 模态如何影响低成就 EFL 本科生的口语焦虑,且这一效应是否随学习者初始口语焦虑水平而变化? 分析主轴: - 主轴一(RQ1):MANCOVA——教学条件为自变量,四项后测口语维度(流利度、准确度、复杂度、任务完成度)为因变量,对应前测分数为协变量;先检验多元正态、线性与方差-协方差矩阵同质性(Box‘s M),多元效应用 Wilks’ Lambda 判定;显著后再做逐维度 follow-up ANCOVA,效应量报 partial η²。 - 主轴二(RQ2):先检验回归斜率同质性(条件 × 前测焦虑的交互);若交互显著则按方法论文献建议(Aiken & West, 1991;Miller & Chapman, 2001;Tabachnick & Fidell, 2019)保留并解释该交互,改走调节性 ANCOVA,并在 −1SD / 均值 / +1SD 三个前测焦虑水平上探测条件效应。 - 主轴三(补充性):选取代表性前/后测口语语段作说明性话语证据,帮助读者理解复杂度与任务完成度的变化如何体现在真实口语产出中;作者明确说明这不是独立的质性话语分析,也不用于生成独立发现。
分析策略
16 周准实验,整班分配(受行政约束)。为压低教学变异,两组由同一位教师授课,使用同一份教学大纲、同一教学进度、同一套任务型口语活动;两组唯一的系统性差异,是用来支持口语练习的 AI 系统设计。 流程:第 1 周说明研究目的、程序与伦理并取得知情同意;第 2 周前测(基线口语表现 + 口语焦虑问卷);第 3–14 周完成 6 次任务型口语活动(分别在第 3、5、7、10、12、14 周),任务主题、指令与课堂输入两组完全一致,每次要求与各自 AI 系统互动至少 15 分钟,并监控互动日志以确保 GenAI 组不是把工具当翻译机用、而是在做任务演练;第 15–16 周后测(平行卷口语测试 + 同一份焦虑问卷,两周窗口以配合排课)。 口语表现测量:两个任务——
① 45 秒内就给定话题表达个人观点;
② 日常情境口语(前测「咖啡店买东西」/ 后测「在超市为家人买东西」,交际需求等价、情境不同以减轻练习效应)。合计口语时长 1 分 30 秒,全部录音后评分。采用分析性评分量表(Skehan, 2009 的三个核心维度 + 任务完成度):流利度(产出的流畅与连贯)、准确度(语法与词汇正确性)、复杂度(结构与词汇的 elaboration)、任务完成度(当前任务要求的满足程度)。两个任务分别就四个维度评分,再加总为 composite 分数作为因变量。评分一致性:研究者 + 一位具 15 年以上高校英语教学经验的评分者,每次测验各组随机抽约 30% 录音独立双评,Cronbach‘s α = .78(前测)/ .81(后测);其余由主评分者评定。 口语焦虑测量:改编自 Woodrow (2006) 的自陈问卷,按 AI 支持的口语活动做情境化改写但保留原构念;12 题、5 点 Likert(1 非常不同意 – 5 非常同意),反向题反向计分后加总。α = .92(前测)/ .93(后测);前后测总分 Pearson r = .86(因两次施测之间夹着意在改变焦虑的干预,作者仅作描述性报告,不将其解读为时间稳定性的证据)。 统计策略:口语表现走 MANCOVA(Box’s M = 18.10, χ²
(15) = 16.41, p = .355,方差-协方差矩阵同质性未违反;未见多元正态性或线性的实质违反)→ Wilks‘ Lambda → 显著后逐维度 ANCOVA + partial η²。焦虑部分:回归斜率同质性检验的交互项显著 (p < .01),故放弃传统 ANCOVA,改调节性 ANCOVA(后测焦虑为因变量,条件为组间因子,前测焦虑为连续预测变量,并纳入二者交互)。所有检验 α = .05。
DESIGN
实验设计
数据收集
非实验室操纵的准实验(整班分配),场域是台湾一所公立大学面向低成就本科生开设的必修通用英语课程。该校通用英语课程按学生先前的英语成就(而非专业)分班,依据校方英语学习记录与先前英语课程表现排课,因此两组虽来自不同专业,入学时共享大体可比的低水平英语画像。 数据收集分三类:① 前测(第 2 周)与后测(第 15–16 周)的口语录音;
② 同时点施测的口语焦虑问卷;
③ 16 周内 6 次任务型口语活动期间与 AI 系统的互动日志(用于监控 GenAI 组确实在进行任务演练而非单纯翻译)。参与自愿,全体签署知情同意,数据在分析前匿名化,遵循校方伦理规范。研究由台湾国科会三项计划资助(NSTC-114-2410-H-415-041、NSTC-114-2410-H-992-063-、NSTC-113-2410-H-018-009-MY2)。
研究样本
n = 59 本科生,按整班分为 PAIA 组(n = 30)与 GenAI 组(n = 29)。性别 24 女 / 35 男;全体为大一非英语专业学生;进入研究前大多接受过约 10 年正式英语教育。 「低成就」的判定采用两个互补标准:① 尽管有约 10 年英语学习经历,其前测口语表现显示口语水平仍在 CEFR A2 附近——功能性口语能力有限;
② 校方记录显示这些学生的先前英语课程成绩排在同届后 25%。与这一画像一致,许多参与者表现出:口语产出策略有限、频繁依赖套语、难以维持扩展的口语回应,以及在评价性情境中呈中到高度口语焦虑。
测量工具
PAIA 组:自建的教学 AI 智能体,经 OpenAI API(GPT-4o) 实现 DA 中介逻辑(Fig. 1 提示词设计、Fig. 2 中介流程)。按 Aljaafreh & Lantolf (1994) 的调节量表运作:卡壳时先给元认知提示(如 Can you expand on your reason?),仍卡住则推进到引导性问题或部分改述,扣住最终纠正性范例直到学习者穷尽自我修复尝试——使中介依随于学习者反应,而非立即给出纠正脚本。 GenAI 组:商业化通用 GenAI 系统 ChatGPT 的默认配置(Fig. 3),作为通用语言资源使用,支持由学习者自定、不遵循预设的渐进中介序列;学生可以拿到高质量输入、要的话也能拿到完整答案,但系统不会施加 PAIA 的调节序列。 口语测验:两个任务(45 秒观点表达 + 情境任务),合计 90 秒,平行卷设计(情境不同、交际需求等价);分析性量表四维(流利度 / 准确度 / 复杂度 / 任务完成度),双任务加总为 composite。 焦虑量表:Woodrow (2006) 改编版,12 题 5 点 Likert。 互动量一致性控制:两组均被要求每次任务与各自 AI 系统互动至少 15 分钟,并监控日志。
RESULTS
结果与分析
评分者一致性 + 量表信度与多元前提检验
(1)口语评分者一致性可接受:两组每次测验随机抽取约 30% 录音由第二位评分者(15 年以上高校英语教学经验)独立双评,Cronbach‘s α = .78(前测)/ .81(后测)。
(2)焦虑量表信度极高:12 题改编版内部一致性 α = .92(前测)/ .93(后测)。
(3)多元统计前提经检验:Box’s M = 18.10, χ²
(15) = 16.41, p = .355,方差-协方差矩阵同质性未违反;多元正态性与线性未见实质违反。
(4)统计模型选择有方法论依据:焦虑分析中回归斜率同质性假设被检验并发现违反(交互 p < .01),作者据此(而非强行套用传统 ANCOVA)改走调节性 ANCOVA,并引用 Aiken & West (1991)、Miller & Chapman (2001)、Tabachnick & Fidell (2019) 支持这一处理;条件效应在 −1SD / 均值 / +1SD 三点探测,而非只报一个总体主效应。
(5)须一并说明的边界:整班分配非随机分组(虽以同一教师、同一大纲、同一活动与统计协变量尽量控制);仅前后测、无过程性追踪;未拆解 PAIA 的具体设计特征;说明性语段为目的性选取,作者明确指出不支持因果或总体层面的推断。
核心发现:口语表现与口语焦虑
RQ1|口语表现:AI 模态有显著多变量效应,但只惠及部分维度
MANCOVA(以前测为协变量):Wilks‘ Λ = .670, F(4, 50) = 6.15, p < .001。逐维度 follow-up ANCOVA:
- 任务完成度:F(1, 56) = 11.79, p = .001, partial η² = .17 → PAIA 组显著更高(效应量最大)
- 复杂度:F(1, 56) = 4.65, p = .035, partial η² = .08 → PAIA 组显著更高
- 流利度:F(1, 56) = 2.59, p = .113 → 不显著
- 准确度:F(1, 56) = .17, p = .685 → 不显著
描述统计(前测 → 后测 / 调整后):流利度 PAIA 4.00 → 6.13(adj 6.13)vs GenAI 4.01 → 5.59(adj 5.59);准确度 PAIA 3.39 → 5.23(adj 5.23)vs GenAI 3.83 → 5.03(adj 5.04);复杂度 PAIA 3.10 → 5.53(adj 5.49)vs GenAI 2.93 → 4.62(adj 4.67);任务完成度 PAIA 3.27 → 5.73(adj 5.69)vs GenAI 3.07 → 4.28(adj 4.33)。
说明性话语证据:后测语段显示回应长度明显扩展、想法组织更清晰、任务要求满足度更高,而前测回应往往简短、零碎或过早收尾。但语法错误在后测语段中依然明显(与准确度不显著一致),停顿与迟疑也仍在(与流利度不显著一致)。从 DA 视角,这一不对称模式可解读为中介中的表现正在浮现(emerging mediated performance),而非完全独立掌握;也与 Skehan (2009) 的复杂度/准确度/流利度权衡一致——更多阐述并不必然伴随准确度的同步提升。
RQ2|口语焦虑:没有「谁更减压」的主效应,而是看你起点有多焦虑
调节性 ANCOVA:条件 × 前测焦虑交互显著,F(1, 55) = 12.02, p = .001, partial η² = .18;前测焦虑主效应显著 F(1, 55) = 24.95, p < .001;条件主效应不显著 F(1, 55) = .34, p = .560。
条件效应(在 −1SD / 均值 / +1SD 前测焦虑水平估计):
- 高初始焦虑:PAIA 组调整后后测焦虑低于 GenAI 组
- 低初始焦虑:GenAI 组调整后后测焦虑低于 PAIA 组
- 平均水平:两组相当
描述统计:PAIA 40.3 → 37.57(adj 37.12);GenAI 39.21 → 35.93(adj 36.00)——两组在描述层面都在下降,但交互说明不能把它简单归因为「用了 AI」。
怎么理解这个交叉:高焦虑的学习者需要更可预测、更结构化的中介才能留在对话里;PAIA 的渐进中介把「卡壳」拆成可管理的步骤序列,降低了不确定性。低焦虑的学习者则能忍受开放互动、甚至更享受这种灵活——通用 GenAI 的私密、非评价性环境对他们已经够用。反过来,同一种开放性对高焦虑学习者可能变成负担:它把「该问什么、怎么改、我到底有没有进步」的自我调控成本全部压回学习者身上,这正是作者所说的元认知税。
CONCLUSION
总体结论
研究结论
① AI 支持的口语练习效果不是均匀的,而是选择性的。PAIA 只在复杂度与任务完成度上胜出,流利度与准确度两组无差异——说明 AI 的中介设计改变的主要是话语层面的调控与交际阐述,而不是口语的自动化程度。
② 情感结果取决于学习者起点。不存在「哪种 AI 更减压」的统一结论:初始焦虑水平调节了 AI 模态与后测焦虑之间的关联,而这个模式用组平均比较会被完全掩盖。
③ 从 DA 视角重读「进步不完整」。后测语段里「话说得更长更完整、但语法错误和停顿还在」,恰恰是中介中的表现正在浮现的证据,而不是学习失败的证据;这与 Skehan (2009) 的 CAF 权衡一致。
④ 核心判断:AI 在口语教学中的教学价值不在于提供了更多互动机会,而在于 AI 中介的支持是否对齐了学习者的发展需求与情感需求。对低成就学习者而言,仅仅给一份「不受限的通用 GenAI 访问权」,可能反而促成替代性认知卸载。
⑤ 三条实践建议:(a) 对低成就学习者应优先给结构化中介,而非只给不受限的通用 GenAI;PAIA 通过渐进提示、扣住完整答案来制造生产性挣扎,从而支持话语层面的发展。(b) AI 整合要按学生的情感画像分层——高焦虑者配可预测、结构化的 PAIA;低焦虑者可给更大灵活度,把通用 GenAI 当会话伙伴。(c) 要把 AI 定义为演练的脚手架,而不是完成任务的捷径:必须嵌在连贯的任务型大纲里、由教师的教学意图引导,并通过回看互动日志确保 AI 支持逐步转移为自主口语能力。
研究局限
1. 参与者限于单一教学情境下的低成就大学 EFL 学习者,外推受限;需在中等教育、ESP 课程或不同水平学习者身上检验同一模式。 2. 只用前后测,捕捉到总体提升,但看不到口语能力在教学过程中如何演化;需过程导向设计(中途测评、AI 互动日志分析)来追踪发展轨迹。 3. 未拆解教学智能体的具体设计特征(提示类型、中介时机、自适应程度),因此无法断言究竟是哪一个设计要素在起作用。 4. 整班分配而非随机分组:虽以同一教师、同一大纲、同一活动及统计协变量尽量控制,仍不能完全排除替代解释。 5. 说明性语段为目的性选取,作者明确指出其用于增强可解释性,不支持因果或总体层面的推断。 6. 样本规模 n = 59(两组各约 30),组间比较的统计功效有限,非显著结果(流利度、准确度)需谨慎解读。
未来展望
① 在不同水平、不同教学情境(中等教育、ESP、不同语言背景)中复制,检验「高焦虑受益于结构化中介、低焦虑受益于开放工具」的交叉模式是否稳定。
② 采用过程导向设计:加入中途测评与 AI 互动日志分析,追踪口语能力的发展轨迹,而非只看前后测差值。
③ 实验性地操纵教学智能体的设计特征——提示类型、中介时机、自适应程度——识别对哪一类学习者、哪一类教学目标最有效。
④ 进一步拆解认知卸载:区分战略性与替代性使用,检验 PAIA 的渐进中介是否真的抑制了非生产性卸载(例如通过日志编码学习者是否真的完成了自我修复循环)。
金句
原文:“the pedagogical value of AI-mediated speaking practice is design-dependent, and that DA-informed mediation may be particularly effective for supporting the developmental and affective needs of low-achieving EFL speakers.”(Lin & Lin, 2026) 解读:这是全文的题眼,也是对「AI 会不会取代语言老师」这个问题最扎实的一次回答。它把争论从「用不用 AI」推进到「AI 被设计成什么」:同一个 GPT-4o,做成随问随答的工具,和做成会先给暗示、再给引导、最后才给答案的导师,一学期下来学生的口语产出真的不一样。而且不一样的地方很具体——不是说得更快、不是语法更好,而是话能说得更长更完整、任务能真的做完。 原文:“learners must determine what support to request, how to evaluate AI-generated feedback, and how to transform that feedback into their own spoken production.”(Lin & Lin, 2026,作者称之为 metacognitive tax / 元认知税) 解读:这句解释了为什么「把 ChatGPT 丢给学生」这件事,对弱势学生反而可能更不公平。开放式的 AI 看起来很友好——不问你是谁、不评判你、随叫随到;但它把三件事悄悄推回给了学生:你要知道自己缺什么、你要能判断 AI 给的对不对、你还得把它变成自己嘴上能说的话。这三件事恰恰是低成就学习者最缺的。所以「不给结构的自由」不是自由,是税。这也是本研究最反直觉的发现——低焦虑的学生用 ChatGPT 更舒服,高焦虑的学生用会「逼」你的智能体反而更不焦虑。 延伸解读(结果层面的反直觉):焦虑上没有主效应,只有交互。这意味着任何「XX AI 能降低口语焦虑」的说法都太粗糙了——它取决于你原本有多怕开口。
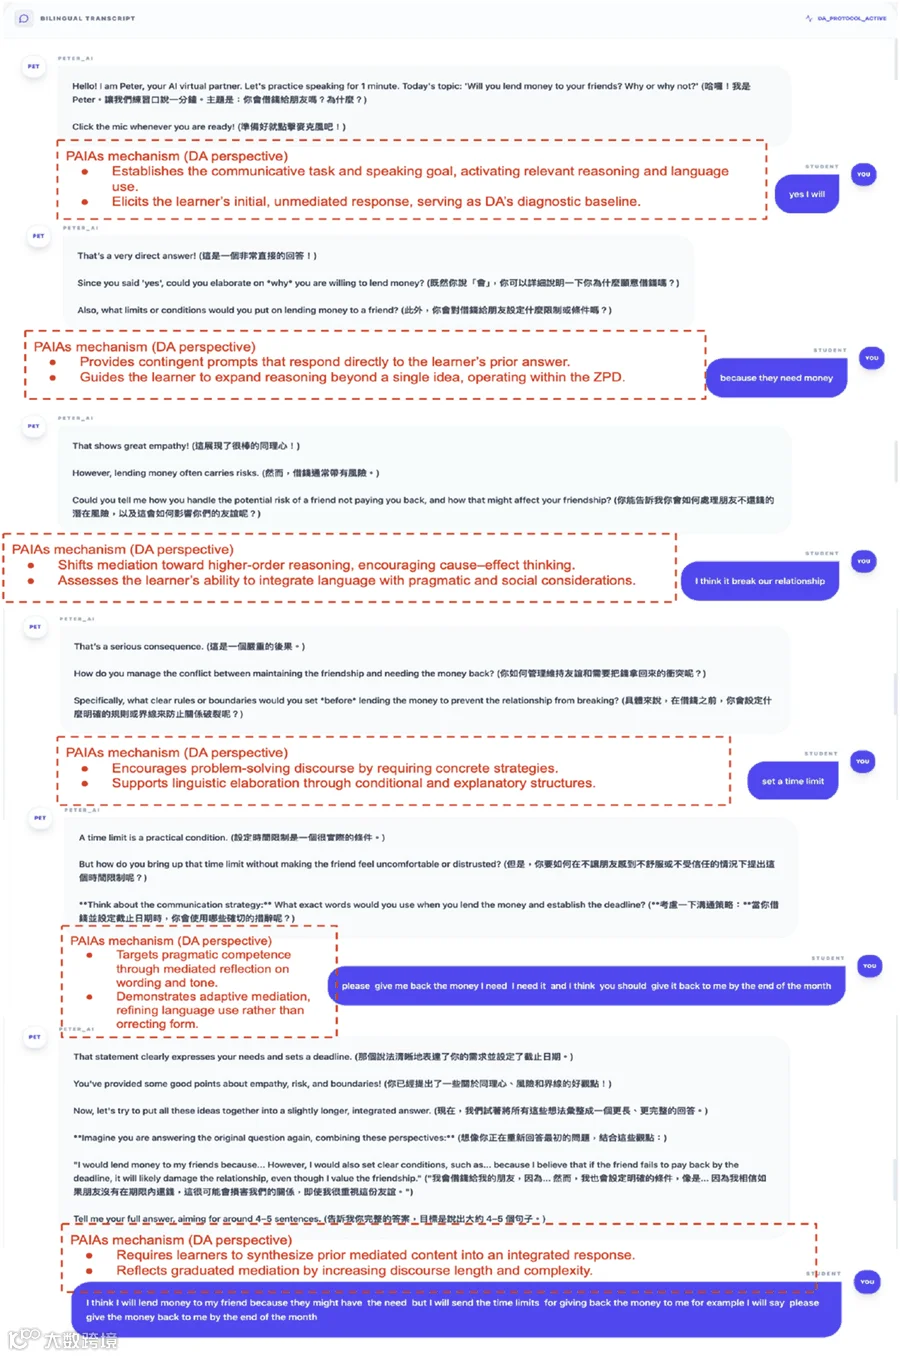
— 研究模型图
📄 摘要原文
English speaking is often the most anxiety-provoking skill for low-achieving EFL undergraduates, and recent research suggests that AI chat tools and pedagogical AI agents (PAIA) can expand opportunities for speaking practice. However, empirical evidence remains limited regarding whether DA-informed pedagogical AI agents differ from general-purpose generative AI (e.g., ChatGPT) in supporting speaking development and regulating speaking anxiety over a full semester. This study therefore examined how the two different AI modalities, conceptualized through dynamic assessment (DA), influences low-achieving learners‘ English speaking performance and speaking anxiety. Using a 16-week quasi-experimental design with intact classes (n = 59), students engaged in identical task-based speaking activities supported by either a DA-oriented pedagogical AI agent (n = 30) or general-purpose GenAI (n = 29). Speaking performance, operationalized as fluency, accuracy, complexity, and task completion, was evaluated using pre- and post-test recordings, and speaking anxiety was assessed through a questionnaire. English speaking performance was analyzed using MANCOVA and moderated ANCOVA with pre-test scores as covariates. Results revealed a significant multivariate effect of AI modality on speaking performance. Follow-up analyses showed that learners supported by the pedagogical AI agent demonstrated significantly higher post-test complexity and task completion, whereas no significant group differences were found for fluency or accuracy. For speaking anxiety, results indicated a significant interaction between AI modality and learners’ initial anxiety levels. These findings suggest that the pedagogical value of AI-mediated speaking practice is design-dependent, and that DA-informed mediation may be particularly effective for supporting the developmental and affective needs of low-achieving EFL speakers.
📎 阅读原文:DOI: 10.1016/j.system.2026.104157
END
我是扣子,高校教师/在读博士/AI顾问。关注AIGC,学术科研,博士生活;分享AI赋能和论文带读,打破AI信息差。视频号:扣子说AI。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。
欢迎关注我的视频号
(❤️会不定期更新AI工具哦❤️)
三连一下,不失联!