


通用模型可以告诉我们"通常应该怎么做",而真实世界需要的,是进一步理解面对的是谁、处于什么状态、有哪些规则和边界,以及此刻到底应该怎么做。
也正因此,随着基础模型能力不断提升,AI的竞争正在从"模型有多强",逐渐转向另一个问题:
谁更懂真实场景。
01通用大模型和垂类模型,到底差在哪?
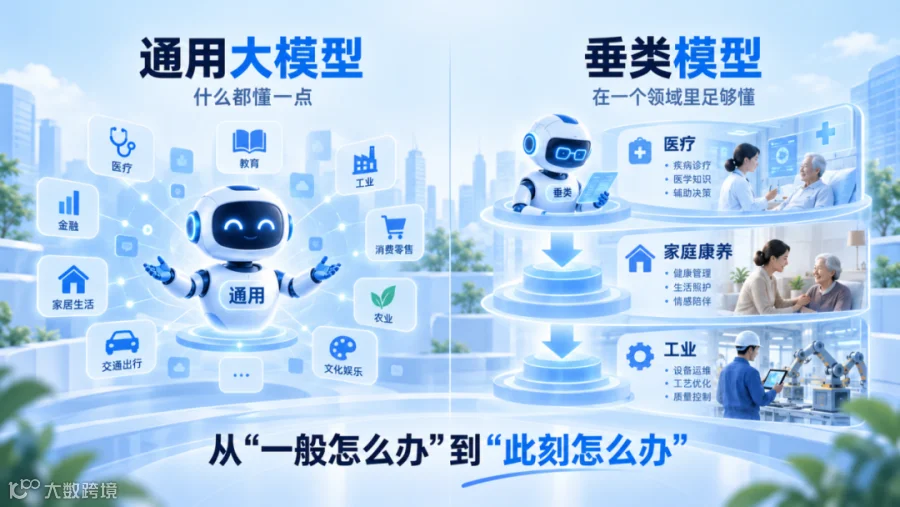
如果做一个简单的类比,通用大模型更像一个知识面很广的"通才"。它了解很多领域,也能够回答很多类型的问题,追求的是能力的广度和通用性。
垂类模型则更像一个经过专业训练的人。它不一定什么都懂,却需要在一个具体领域里理解得更深,同时熟悉这个行业里的知识、规则和判断方式。
比如,同一句"我有点不舒服",对于通用模型来说,它可能会根据常识给出一些常见建议;但如果进入家庭康养场景,系统需要理解的内容会复杂得多,它可能还需要结合一个人的年龄、身体状态、近期变化、当前时间,以及是否存在潜在风险,判断这只是一次普通的不适,还是需要进一步提醒家属或寻求专业帮助。
所以,垂类模型真正要理解的,并不只是"这个行业有哪些知识",而是人在什么时间、什么环境、什么状态下,按照什么规则应该采取什么行动。
通用模型更擅长回答"这种事情一般怎么办",而垂类模型需要进一步理解的是:
当前这个具体情况,应该怎么办。
这就是从通用能力走向场景智能的关键。
02垂类模型≠重造一个行业版ChatGPT
很多人听到"垂类模型",会自然地理解成:企业是不是需要重新训练一个医疗版、工业版或者金融版的大模型?
实际上,随着基础模型能力越来越成熟,更常见、也更现实的路径,是在一个已经拥有通用能力的模型基础上,继续增加专业能力,而不是从零开始重新训练一个大模型。
Google推出的医疗模型MedGemma就是一个典型案例。MedGemma建立在Gemma3基础模型之上,又进一步使用医学文本、医学问答、医学影像、电子健康记录等专业数据进行训练。2026 年更新的MedGemma 1.5,还进一步支持 CT、MRI、病理切片等医疗数据。
简单来说,垂类模型更像是:
先拥有一个足够聪明的大脑,
再让它接受专业训练。
这个过程虽然在不同公司、不同场景中的技术路径并不完全相同,但如果把复杂的模型训练翻译成普通人更容易理解的语言,大致可以分成三个阶段。
首先,是让模型真正"懂这一行"。
医疗里的病例、指南和医学论文,工业里的设备手册和故障记录,企业里的业务文档、历史工单和操作记录,都可能成为模型学习的专业数据。通过这些数据,模型会逐渐熟悉一个行业里的专业术语、知识结构和判断逻辑。
但数据并不是越多越好。与互联网公开数据相比,行业数据往往更加稀缺,真正重要的是这些数据是否准确、真实、有代表性,以及是否来自实际业务和真实场景。
接下来,是让模型从"懂知识"变成"会做事"。
知道医学知识,并不代表会处理一个具体患者的问题;知道设备原理,也不代表会判断一次真实故障。因此还需要利用大量实际任务和专业人员标注的样本,对模型进行进一步训练,让它知道面对某类情况应该如何判断、缺少什么信息时需要继续询问、什么时候可以直接处理,以及什么时候必须转交给人。
如果前一步更像"学习专业知识",这一阶段则更像进入岗位之后的"实战训练"。
最后,还要让模型知道自己的边界在哪里。
越接近医疗、金融、工业、康养这些真实场景,AI 越不能只追求"会不会做",还必须知道"能不能做"。有些任务可以由 AI 自动完成,有些需要用户确认,有些则必须由专业人员做最终判断。
所以,一个成熟的垂类模型,不只是更专业,也应该更清楚自己的能力边界。
03好用的垂类 AI,往往不只是一个模型
还有一个容易被忽略的问题:真实世界里的信息一直在变化。
企业制度会更新,产品信息会变化,设备状态随时可能改变,一个人的身体状态和生活习惯同样不可能永远固定。如果所有信息都依靠重新训练模型进行更新,不仅成本很高,也无法满足实时需求。
因此,真正落地的垂类 AI,通常不会只依赖模型本身,而是会同时连接专业知识库、数据库和各种工具,让模型能够在需要时获取最新信息。
比如,当员工询问公司最新制度时,系统可以先从企业知识库找到最新版文件,再结合文件内容回答;当设备发生异常时,可以先读取设备当前状态和历史数据,再进行判断;如果任务需要真正执行,系统还可以进一步调用软件、服务,甚至实体设备完成操作。
这意味着,真正成熟的垂类 AI,通常已经不是一个孤立的模型,而是一套完整系统。
其中,大模型负责理解和推理,专业数据提供知识,工具负责获取实时信息和执行任务,而规则、权限和安全机制负责确保系统在正确的边界内运行。
因此,与其说未来的垂类 AI 是"一个更专业的大模型",不如说它更像是围绕一个具体场景建立起来的智能系统。
04真正的壁垒,是越来越懂真实场景
当越来越多企业都能够使用相似的基础模型之后,单纯拥有一个模型,本身会越来越难成为长期优势。
真正难以复制的,反而可能是企业是否拥有真实的行业数据,是否真正理解业务流程,能不能把专家经验转化成 AI 可以学习的规则,以及系统进入实际场景之后,能不能持续获得新的反馈。
最终,一个成熟的垂类模型会形成这样的循环:
数据 → 模型 → 场景 → 反馈 → 新的数据
因此,垂类模型真正的价值并不只存在于第一次训练完成的那一刻,而在于进入真实世界之后,能不能随着持续运行和反馈,逐渐变得更懂行业、更懂环境,也更懂用户。
从这个角度来看,未来垂类 AI 的竞争,也许并不只是参数多少、模型大小或者某一次 Benchmark 的竞争,而是谁能够更深入地进入真实场景,并建立起一套持续积累数据和经验的闭环。
05家庭和康养,更需要"懂场景"的 AI
家庭和康养,是一个很典型的例子,因为真实生活中的需求,往往不会首先变成一句清晰完整的指令。
比如,一个老人半夜频繁起身。
如果 AI 只是识别出"有人起床",它只是完成了最基础的感知。真正有价值的系统,还需要结合这个人的生活习惯、近期行为变化、当前时间、身体状态以及环境风险,判断这是正常活动,还是值得关注的异常,是应该自动打开夜灯、提醒家人,还是暂时不做任何打扰。
再比如,一个人说"我有点冷",真正好的系统也不应该只是回答一句"建议把空调调高一点",而是需要结合当前室温、时间、个人习惯、身体状态以及家里的设备情况,判断此刻什么样的行动更加合适。
这意味着,在家庭和康养场景里,AI 真正需要理解的,其实不是某一句话本身,而是人、时间、空间、状态和规则共同构成的上下文。它不仅需要听懂"你说了什么",还要逐渐理解"此刻正在发生什么"。
这也是引态目前正在围绕家庭、康养等场景探索垂类模型的原因之一。相比再做一个"什么都能回答"的 AI,我们更关注如何让 AI 在具体生活场景中理解不同的人、不同的需求和不同的边界,并在合适的时候,与设备和服务协同完成行动。
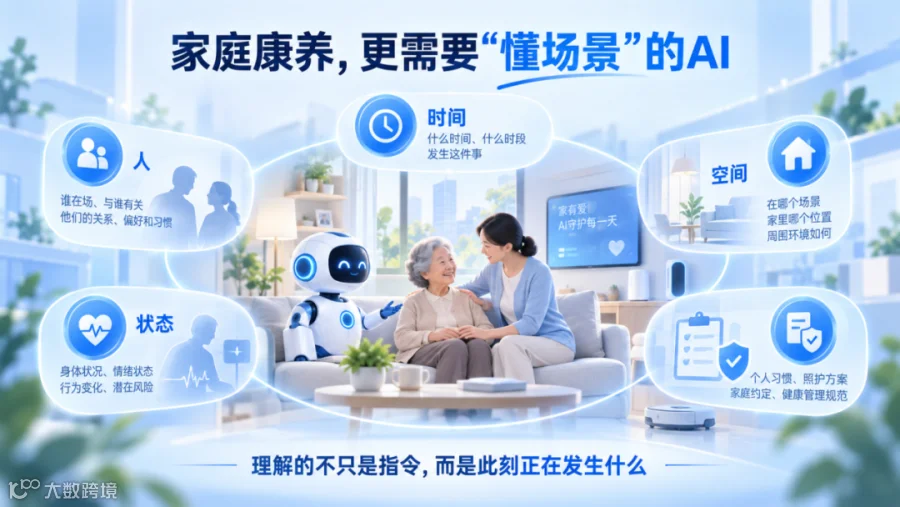
从这个角度来看,通用模型和垂类模型并不是替代关系。通用大模型提供了越来越强的智能底座,而垂类模型所做的,是让这些能力进一步理解行业、理解用户,并最终进入真实生活。
当基础模型越来越普及,下一阶段真正稀缺的,或许不只是更强的模型,而是真正懂场景的 AI。